
CRISP-DM (Cross-Industry Standard Process for Data Mining) es la metodología de referencia para organizar un proyecto de minería de datos o de analítica avanzada. Define seis fases que van desde entender el problema de negocio hasta poner el resultado en producción, y su principal virtud es que no presupone ninguna herramienta ni ningún sector concreto.
Se publicó a finales de los años noventa por un consorcio de empresas que buscaban un marco común para sus proyectos analíticos, y sigue siendo el esquema más utilizado a pesar de su edad. La razón es sencilla: describe cómo se trabaja realmente, no cómo debería trabajarse en un mundo ideal.
Lo que más se malinterpreta: CRISP-DM no es una secuencia lineal. Es un ciclo con vueltas atrás previstas entre fases. Un proyecto que recorre las seis fases en orden y sin retroceder nunca no es un proyecto bien gestionado: es un proyecto en el que nadie ha revisado sus supuestos.
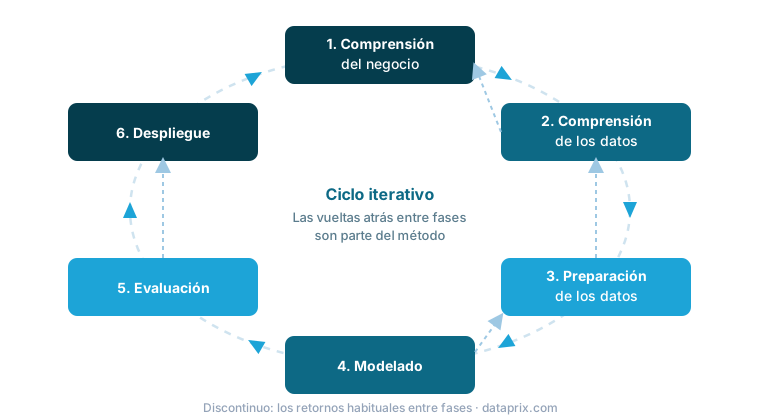
Las 6 fases de CRISP-DM
1. Comprensión del negocio
Antes de mirar un solo dato hay que traducir la pregunta del negocio en un problema analítico. No es lo mismo «queremos reducir la fuga de clientes» que «queremos predecir qué clientes se darán de baja en los próximos 60 días para actuar sobre ellos»: la segunda formulación ya dice qué se va a predecir, con cuánta antelación y para qué.
Lo que debe quedar cerrado en esta fase:
- El objetivo de negocio y cómo se sabrá si se ha cumplido, en términos que entienda quien paga el proyecto.
- El objetivo analítico derivado del anterior, con su métrica técnica.
- Qué se hará con el resultado. Si nadie va a cambiar ninguna decisión a partir del modelo, el proyecto no debería empezar.
- Las restricciones: plazos, presupuesto, datos a los que no se puede acceder y limitaciones legales sobre su uso.
Es la fase que más proyectos hunde por omisión. Un modelo técnicamente impecable que responde a la pregunta equivocada no tiene arreglo en fases posteriores.
2. Comprensión de los datos
Aquí se recopilan los datos disponibles y se examinan: qué hay, de dónde viene, en qué estado está y hasta qué punto sirve para la pregunta planteada.
Las tareas habituales son la recopilación inicial, la descripción de las fuentes, la exploración estadística y la verificación de calidad. Esta última es la que suele traer sorpresas: campos con más nulos de los esperados, históricos que empiezan más tarde de lo que decía la documentación, o categorías que cambiaron de significado hace tres años sin que nadie lo anotara.
Es frecuente y perfectamente normal volver desde aquí a la fase anterior. Si los datos disponibles no permiten responder la pregunta, es mejor reformularla ahora que descubrirlo en la fase de evaluación.
3. Preparación de los datos
Es la fase más larga de todas, con diferencia, y la que menos aparece en las presentaciones. Incluye la selección de los datos relevantes, la limpieza, la construcción de variables derivadas, la integración de fuentes distintas y el formateo final para la herramienta que vaya a consumirlos.
La parte que más determina el resultado es la construcción de variables. La mayoría de las mejoras significativas en un modelo vienen de haber derivado la variable adecuada —la antigüedad del cliente, la variación respecto al mes anterior, el número de incidencias en los últimos noventa días— y no de haber elegido un algoritmo más sofisticado.
Conviene que esta fase se implemente como un proceso reproducible desde el principio, no como una serie de pasos manuales, porque tendrá que repetirse cada vez que el modelo se reentrene. Es el punto donde el proyecto analítico se apoya en la arquitectura de integración de datos de la organización.
4. Modelado
Se seleccionan las técnicas apropiadas, se define el esquema de validación, se construyen los modelos y se ajustan sus parámetros. Es la fase que la mayoría imagina cuando piensa en minería de datos, y suele ser bastante más corta de lo que se espera.
La decisión más importante aquí rara vez es qué algoritmo usar, sino cómo se va a validar. Una partición mal diseñada —por ejemplo, repartir al azar registros que tienen dependencia temporal— produce métricas excelentes que no se sostienen en producción. Es el error técnico más caro de esta fase, y el más difícil de detectar después.
Es habitual volver a la preparación de datos: la técnica elegida puede exigir un formato distinto, normalizaciones o un tratamiento diferente de los valores ausentes.
5. Evaluación
No se trata de repetir las métricas técnicas del modelado, sino de responder a una pregunta distinta: ¿este resultado sirve para el objetivo de negocio del principio?
Un modelo con una precisión alta puede ser inútil si los casos que acierta no son los que importan, o si el coste de actuar sobre sus predicciones supera el beneficio de acertar. Aquí es donde se revisa el proceso completo, se comprueba que no se ha pasado nada por alto y se decide una de tres cosas: pasar a despliegue, iterar sobre alguna fase anterior, o parar el proyecto.
Que «parar» sea una salida legítima y prevista de la metodología es una de sus aportaciones menos valoradas.
6. Despliegue
Un modelo que vive en el portátil de un analista no ha generado ningún valor. El despliegue puede ir desde un informe con recomendaciones hasta un servicio integrado en un sistema operacional que puntúa registros en tiempo real.
Lo que hay que cerrar en esta fase:
- El plan de despliegue: dónde se ejecuta, con qué frecuencia y quién consume el resultado.
- La monitorización. Los datos de entrada cambian con el tiempo y el rendimiento del modelo se degrada; hace falta medirlo, no suponerlo.
- El plan de mantenimiento: cuándo se reentrena, con qué criterio y quién es responsable.
- La documentación y el informe final, incluyendo lo que no funcionó, que es lo que evita repetir el camino en el siguiente proyecto.
Documento de referencia: puedes consultar la guía original completa de la metodología en el PDF de CRISP-DM alojado en Dataprix, con la descripción detallada de cada tarea y sus entregables.
Resumen de las fases y sus entregables
| Fase | Pregunta que responde | Entregable principal |
|---|---|---|
| 1. Comprensión del negocio | ¿Qué problema resolvemos y cómo sabremos que lo hemos resuelto? | Objetivos de negocio y analíticos, criterios de éxito, plan de proyecto |
| 2. Comprensión de los datos | ¿Qué datos hay y sirven para esto? | Informe de exploración y de calidad de los datos |
| 3. Preparación de los datos | ¿Cómo los dejamos listos? | Conjunto de datos final y proceso reproducible que lo genera |
| 4. Modelado | ¿Qué técnica funciona mejor? | Modelos entrenados y esquema de validación |
| 5. Evaluación | ¿Esto sirve para el negocio? | Decisión: desplegar, iterar o parar |
| 6. Despliegue | ¿Cómo lo ponemos a producir valor? | Sistema en producción, monitorización y plan de mantenimiento |
Cuándo CRISP-DM encaja y cuándo no
Encaja bien en proyectos analíticos con un objetivo de negocio identificable, varios participantes y necesidad de justificar decisiones ante terceros. Su vocabulario común entre perfiles técnicos y de negocio es, en la práctica, buena parte de su valor.
Encaja peor en dos situaciones. La primera, en exploraciones abiertas sin pregunta previa, donde la primera fase no tiene contenido que aportar. La segunda, en organizaciones con entrega continua de modelos, donde el ciclo de despliegue y reentrenamiento es tan frecuente que la estructura por fases se queda corta: ahí el marco natural es el de las prácticas de operación de modelos, que asumen que el ciclo no termina nunca.
En ese segundo caso conviene entender que no se trata de sustituir CRISP-DM sino de encajarlo: las seis fases siguen describiendo bien el primer recorrido, y lo que cambia es lo que ocurre después del despliegue inicial.
¿Tienes un proyecto de analítica que no acaba de pasar de la prueba de concepto?
Solicitar una consulta inicial gratuitaPreguntas frecuentes
¿Qué significan las siglas CRISP-DM?
Cross-Industry Standard Process for Data Mining, es decir, proceso estándar intersectorial para minería de datos. El nombre refleja su intención: servir en cualquier sector y con cualquier herramienta.
¿Cuántas fases tiene CRISP-DM?
Seis: comprensión del negocio, comprensión de los datos, preparación de los datos, modelado, evaluación y despliegue. Están concebidas como un ciclo con retornos entre fases, no como una secuencia cerrada.
¿Cuál es la fase más larga?
La preparación de los datos, en la mayoría de los proyectos y por un margen amplio. Es también la que más determina la calidad del resultado final.
¿Sigue vigente CRISP-DM?
Sí como marco de organización de proyectos analíticos, y es el vocabulario más extendido para hablar de ellos. Lo que ha cambiado desde su publicación es la fase de despliegue, que hoy exige prácticas de automatización y monitorización continuas que la metodología original no detalla.
¿Sirve para proyectos de machine learning y no solo de minería de datos?
Sí. Las seis fases describen igual de bien un proyecto de aprendizaje automático supervisado. La diferencia está en el detalle del despliegue y del mantenimiento, no en la estructura.
Si estás definiendo la plataforma sobre la que se apoyarán estos proyectos, la guía práctica de arquitectura de datos recorre las decisiones de fondo, desde el almacenamiento hasta la gobernanza. Y para elegir herramientas concretas, el ranking de software de data science recoge el veredicto editorial de cada opción.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 11 de septiembre de 2026.
