Ingesta de datos a escala: cómo construir pipelines resilientes con idempotencia, backpressure y reintentos

Por Dataprix · 21 de julio de 2026
La ingesta de datos a escala es el proceso de capturar, mover y entregar grandes volúmenes de datos —en lotes o en flujo continuo— desde sus orígenes hasta las plataformas de almacenamiento y procesamiento, manteniendo la fiabilidad bajo carga variable y… Leer más sobre Ingesta de datos a escala: cómo construir pipelines resilientes con idempotencia, backpressure y reintentos

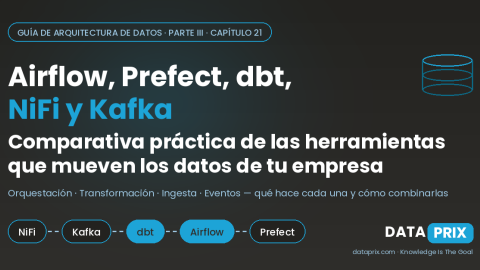
Airflow, Prefect, dbt, NiFi y Kafka: comparativa práctica de las herramientas que mueven los datos de tu empresa

Por Dataprix · 15 de junio de 2026

Airflow, Prefect, dbt, NiFi y Kafka son un ejemplo de stack de integración —el del modern data stack open-source, código primero— que este capítulo usa como hilo conductor para entender los cuatro planos de un pipeline: quién orquesta (Airflow, Prefect),… Leer más sobre Airflow, Prefect, dbt, NiFi y Kafka: comparativa práctica de las herramientas que mueven los datos de tu empresa

Almacenamiento en la Nube: S3, Azure Blob, Tiering y Políticas de Retención — Cómo Optimizar Costes sin Sacrificar el Cumplimiento Normativo

Por Dataprix · 4 de marzo de 2026

Si hay una factura de infraestructura que crece de manera silenciosa hasta convertirse en un problema de comité de dirección, esa es la del almacenamiento en la nube. Según estimaciones de FinOps Foundation, entre el 25 % y el 35 % del gasto cloud de una… Leer más sobre Almacenamiento en la Nube: S3, Azure Blob, Tiering y Políticas de Retención — Cómo Optimizar Costes sin Sacrificar el Cumplimiento Normativo

Diseño de esquemas y modelos de datos escalables — normalización, desnormalización y modelos por acceso

Por Dataprix · 25 de noviembre de 2025

El diseño de esquemas de datos es la decisión arquitectónica más duradera y costosa de modificar en cualquier plataforma. Este capítulo desmitifica el dilema normalización vs desnormalización, proporcionando criterios cuantitativos basados en patrones de… Leer más sobre Diseño de esquemas y modelos de datos escalables — normalización, desnormalización y modelos por acceso

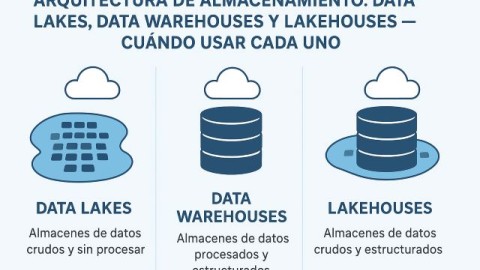
Arquitectura de almacenamiento: data lakes, data warehouses y lakehouses — cuándo usar cada uno

Por Dataprix · 6 de noviembre de 2025

La decisión entre data lake, data warehouse o lakehouse no es una mera elección tecnológica: define cómo su organización almacenará, procesará y extraerá valor de los datos durante los próximos años. Esta arquitectura condiciona los tiempos de acceso, los… Leer más sobre Arquitectura de almacenamiento: data lakes, data warehouses y lakehouses — cuándo usar cada uno

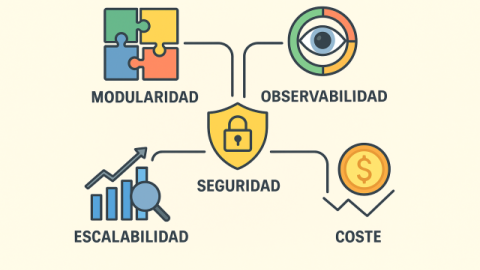
Principios de arquitectura de datos: modularidad, observabilidad, escalabilidad, seguridad y coste

Por Dataprix · 19 de septiembre de 2025

La arquitectura de datos moderna ya no se define solo por la tecnología que la soporta, sino por los principios que la orientan. En un entorno donde la presión por innovar convive con el riesgo de sobrecostes, ciberamenazas y sistemas cada vez más complejos,… Leer más sobre Principios de arquitectura de datos: modularidad, observabilidad, escalabilidad, seguridad y coste