Observabilidad en bases de datos: métricas clave, distributed tracing y alerting para la capa de datos

Por Dataprix · 16 de marzo de 2026

La observabilidad en la capa de datos es la disciplina que convierte el comportamiento interno de bases de datos, pipelines y motores de almacenamiento en información accionable para los equipos de ingeniería. A diferencia de la simple monitorización —que… Leer más sobre Observabilidad en bases de datos: métricas clave, distributed tracing y alerting para la capa de datos

Panorama actual de motores de datos: RDBMS, NewSQL, NoSQL, series temporales, grafos , grafos y su lugar en la arquitectura

Por Dataprix · 23 de octubre de 2025

La elección del motor de datos correcto puede suponer la diferencia entre una arquitectura que escala con elegancia y un cuello de botella perpetuo de 2 millones de euros anuales. Este capítulo desmitifica el zoo de bases de datos modernas y ofrece un marco… Leer más sobre Panorama actual de motores de datos: RDBMS, NewSQL, NoSQL, series temporales, grafos , grafos y su lugar en la arquitectura

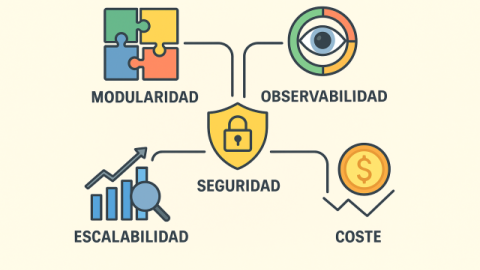
Principios de arquitectura de datos: modularidad, observabilidad, escalabilidad, seguridad y coste

Por Dataprix · 19 de septiembre de 2025

La arquitectura de datos moderna ya no se define solo por la tecnología que la soporta, sino por los principios que la orientan. En un entorno donde la presión por innovar convive con el riesgo de sobrecostes, ciberamenazas y sistemas cada vez más complejos,… Leer más sobre Principios de arquitectura de datos: modularidad, observabilidad, escalabilidad, seguridad y coste

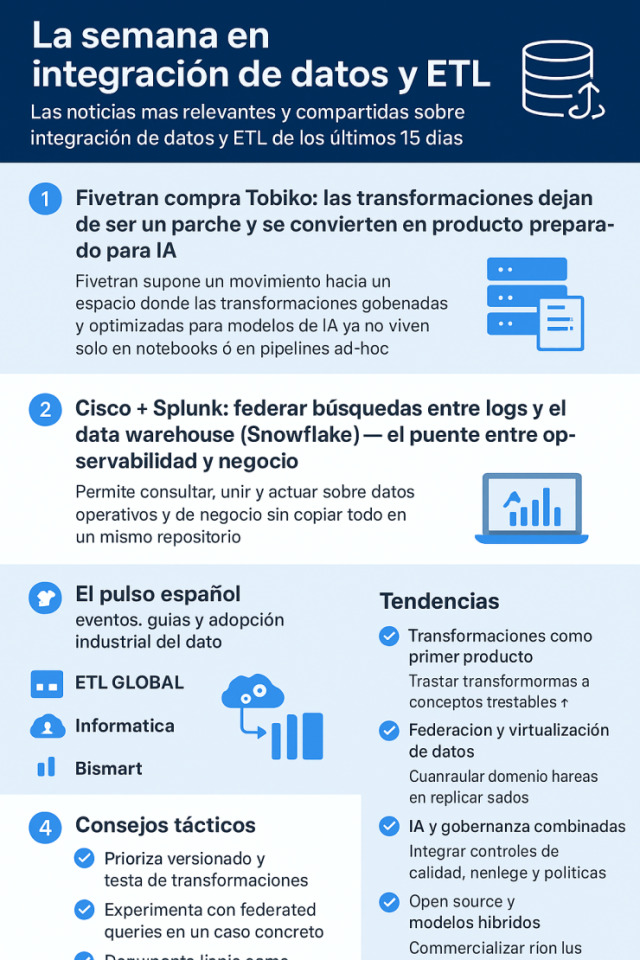
Integración de datos y ETL: las noticias clave de la semana para empresas y equipos de datos

Fivetran compra Tobiko, Cisco y Splunk conectan Snowflake, y España impulsa la gobernanza del dato. Un resumen riguroso y práctico de las últimas novedades en integración de datos y ETL, con claves para profesionales que buscan eficiencia, trazabilidad y preparación para IA.

Noticias integracion de datos

Amazon SageMaker

Amazon Sagemaker Studio

Amazon SageMaker es una solución de aprendizaje automático que permite a científicos de datos y desarrolladores crear, entrenar e implementar modelos de aprendizaje automático. Es compatible con el aprendizaje por lotes y en línea, y viene con algoritmos preconstruidos para casos de uso comunes..