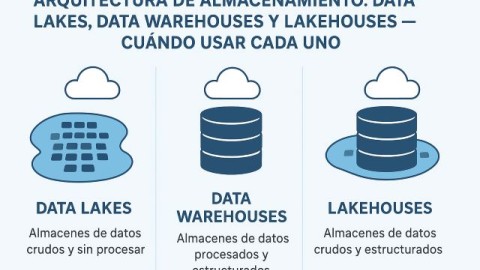
Arquitectura de almacenamiento: data lakes, data warehouses y lakehouses — cuándo usar cada uno

Por Dataprix · 6 de noviembre de 2025

La decisión entre data lake, data warehouse o lakehouse no es una mera elección tecnológica: define cómo su organización almacenará, procesará y extraerá valor de los datos durante los próximos años. Esta arquitectura condiciona los tiempos de acceso, los… Leer más sobre Arquitectura de almacenamiento: data lakes, data warehouses y lakehouses — cuándo usar cada uno

Talentia se posiciona como líder en SPARK Matrix™ 2022 for Talent Management Application de Quadrant Knowledge Solutions

13 de septiembre de 2022.- Quadrant Knowledge Solutions anuncia que ha nombrado a Talentia como líder tecnológico 2022 en el análisis SPARK Matrix™ del mercado global de aplicaciones de gestión del talento.


Apache Spark

Apache Spark

Spark es un framework open source de Apache Software Foundation para procesamiento distribuído sobre clusters de ordenadores de grandes cantidades de datos, ideado para su uso en entornos de Big Data, y creado para mejorar las capacidades de su predecesor MapReduce.

Spark hereda las capacidades de escalabilidad y tolerancia a fallos de MapReduce, pero lo supera ampliamente en cuanto a velocidad de procesamiento, facilidad de uso y capacidades analíticas..

Introducción a Apache Spark

Resource type
Manual

Apache SparkHoy vamos a hacer una introducción a Apache Spark, el nuevo motor del Big Data, se trata de un framework de computación paralela enfocando especialmente hacia la ciencia de datos.
Esta primera introducción es una guía para su instalación, conceptos, estructura y el primer contacto que tendremos será la implementación de un Clúster Standalone con PySpark..