Esta semana en el portal profundizamos en una disciplina que muchos equipos de datos dan por hecha hasta que falla en producción: el testing de pipelines. La guía de arquitectura de datos dedica su nuevo capítulo a distinguir qué merece un test automatizado y qué no, con el listón puesto en el coste real de un fallo de lógica frente al de una validación en producción. En el directorio seguimos ampliando la cobertura de catálogos y gobierno de metadatos con Atlan, integración de datos con Fivetran y ciencia de datos con KNIME, tres piezas que conectan directamente con lo que se mueve esta semana en el sector.
Y esta semana el sector se mueve, sobre todo, en la capa de gobierno que rodea a los agentes de IA sobre datos empresariales: Databricks integra GPT-6 Astra de OpenAI en Unity Gateway el mismo día de su lanzamiento, Qlik lleva su servidor MCP a los marketplaces de AWS y Databricks, y Snowflake completa el círculo con el linaje externo en disponibilidad general. Apache Kafka 4.4.0 refuerza la seguridad de los clústeres KRaft y MongoDB da un paso relevante en residencia de datos europea para su servicio de embeddings. Cinco piezas que, juntas, dibujan un mismo mensaje: a medida que los agentes de IA acceden a más datos de producción, el gobierno de quién puede tocar qué se ha convertido en la funcionalidad más disputada del sector.
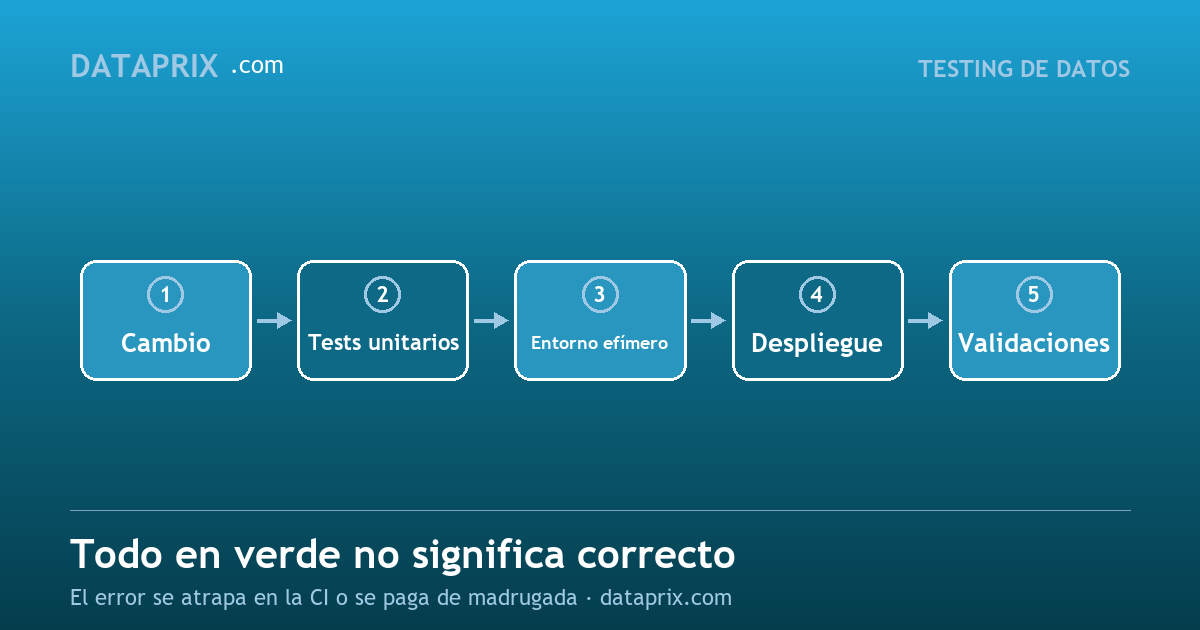
El testing de pipelines verifica la lógica antes de desplegarla, con datos de prueba controlados, igual que se testea cualquier software: tests unitarios, tests de integración y validación de contratos. Es la disciplina complementaria de las validaciones en producción: aquellas vigilan los datos reales en ejecución; el testing atrapa los errores de lógica cuando corregirlos cuesta minutos, no horas de madrugada.
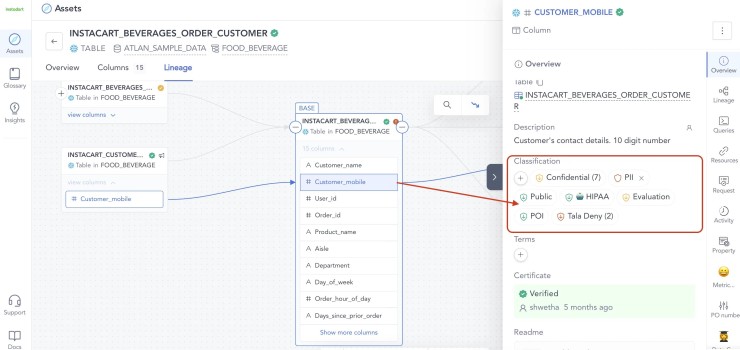
Catálogo de datos y gobierno de metadatos con un núcleo de "metadatos activos" que ingiere y actualiza información a medida que los pipelines se ejecutan. La pieza natural para quien esta semana mira de cerca el linaje externo de Snowflake.
Integración de datos automatizada en la nube que replica y normaliza información de aplicaciones SaaS, bases de datos y archivos hacia data warehouses y data lakes, sin pipelines a medida que mantener.
Plataforma open source para crear y analizar pipelines de datos mediante flujos de trabajo visuales, nacida en la Universidad de Konstanz. Una alternativa de código abierto a las plataformas de IA de pago que dominan las noticias de esta semana.
Databricks añade GPT-6 Astra a su catálogo de modelos el mismo día del lanzamiento de OpenAI, con gobierno, auditoría y control de costes ya integrados en Unity Gateway.
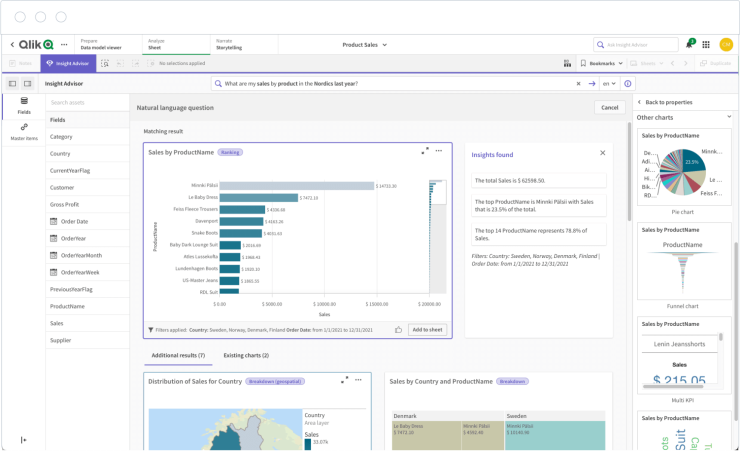
El servidor MCP de Qlik llega a AWS Marketplace y Databricks Marketplace, para que los agentes de esos entornos accedan a datos y métricas de negocio gobernados sin reconstruir la lógica desde cero.
Con el estándar OpenLineage, herramientas como dbt o Airflow ya pueden aparecer integradas en el mismo grafo de trazabilidad de Snowflake, incluido el linaje a nivel de columna.
Más de 25 mejoras: asignación dinámica de memoria en el productor, ACL por rango CIDR y una unificación de las herramientas de arranque en clústeres KRaft.
El servicio de embeddings y reranking ERAS de MongoDB Atlas añade residencia de datos en la UE y en EE.UU., una garantía de soberanía del dato que el mercado europeo llevaba tiempo pidiendo.
Con el linaje externo de Snowflake en disponibilidad general y Qlik y Databricks abriendo sus datos gobernados a agentes de terceros, la pregunta de fondo es siempre la misma: ¿quién puede ver, tocar y auditar cada dato de la organización? Nuestro ranking recoge las plataformas de gobernanza de referencia —catálogos, linaje, calidad y cumplimiento— con análisis técnico en español para comparar antes de decidir.
Si tu organización está evaluando cómo dar acceso a agentes de IA sin perder trazabilidad ni control, este es el punto de partida.
Ver el ranking de gobernanza en Dataprix →
Dataprix · C/ Font dels Arcs, 10 · La Florida, Barcelona 08130
Los contenidos de este boletín se elaboran con asistencia de inteligencia artificial y se revisan
y editan por el equipo editorial de Dataprix, que asume la responsabilidad editorial.