• Log in

Menu principal

  • Quienes somos
  • Contact
  • twitter
  • linkedin
  • facebook
Home
  • TOP Software
    • Ranking Plataforma de datos
    • Ranking Integracion de datos
    • Ranking Business Intelligence
    • Ranking Data Science y AI
    • Ranking Gobernanza de datos
    • Ranking ERP
    • Ranking CRM
    • Marketing electrónico
      • Ranking SEM/SEO
    • Gestión empresarial
      • Ranking CMS
      • Ranking Contabilidad y finanzas
      • Ranking Diseño gráfico
      • Ranking Software Colaboración
      • Ranking Software Comunicación equipo
  • Empresas IT
    • Fabricación y desarrollo de productos
      • Bases de datos
      • Integración de datos
      • Business Intelligence
      • Data Science y AI
      • ERP
      • CRM
      • Gestión empresarial
      • Marketing electrónico
      • Seguridad
      • Movilidad
      • Software libre
      • Tendencias tecnológicas
    • Servicios de consultoría
      • Bases de datos
      • Integración de datos
      • Business Intelligence
      • Data Science
      • ERP
      • CRM
      • Gestión empresarial
      • Marketing electrónico
      • Seguridad
      • Movilidad
      • Cloud
      • Software libre
      • Tendencias tecnológicas
    • Infraestructura, Hosting o Servicios cloud
    • Márqueting y comunicación
    • Formación especializada
    • Reclutamiento, Bolsa de trabajo
  • Blogs
    • Dataprix
    • Carlos Fernández
    • Invitados
    • Sonia
    • Oscar Paredes
    • Alfonso Cutro
    • Il masacratore
  • Novedades
  • Herramientas
    • Test de Madurez Analítica

Navegacion temática principal

  • Plataforma de datos
  • Integracion
  • Business intelligence
  • Data Science
  • Gobernanza de Datos

Breadcrumb

  1. Home
  2. Integracion de datos

Entradas de blog

Testing de pipelines y datos: qué probar, cuándo y qué no merece la pena

Profile picture for user Dataprix
By Dataprix on 1 September, 2026 - 20:59
  • Read more about Testing de pipelines y datos: qué probar, cuándo y qué no merece la pena
  • Log in to post comments

Testing de datos

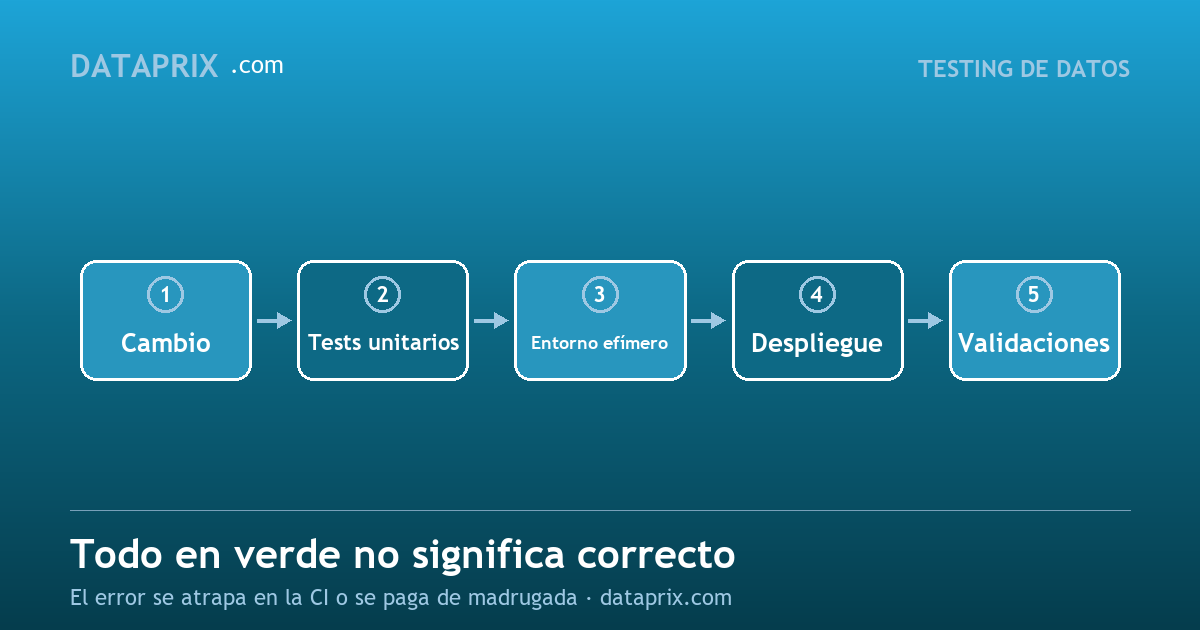
El testing de pipelines de datos es la práctica de verificar la lógica de los pipelines antes de desplegarla, con datos de prueba controlados, igual que se testea cualquier software. Se organiza en tres niveles: tests unitarios, tests de integración y validación de contratos. Es la disciplina complementaria de las validaciones en producción del capítulo 24: aquellas vigilan los datos reales en ejecución; el testing atrapa los errores de lógica cuando corregirlos cuesta minutos, no horas de madrugada..
más entradas de blog

Noticias de Integracion de datos

Pentaho 2026: qué es, módulos, casos de uso y alternativas

Qué es Pentaho Pentaho es una plataforma de análisis empresarial y data integration nacida en 2004, una de las…

Tutorial dbt completo con DuckDB y Docker: pipeline, tests y docs

En el ecosistema moderno de datos, la transformación ya no es un paso oscuro enterrado dentro de un ETL monolítico.…

Integración de datos y ETL: las noticias clave de la semana para empresas y equipos de datos

En apenas quince días el ecosistema de la integración de datos ha vuelto a recordarnos que ya no existe frontera clara…
Más noticias

Software de Integracion de datos

Fivetran

Fivetran constituye una solución de integración de datos automatizada que opera en la nube y permite replicar, sincronizar y normalizar información proveniente de diversas fuentes (por ejemplo, aplicaciones SaaS, bases de datos y archivos) hacia repositorios analíticos como data warehouses y data lakes..
Más software empresarial

🎓 Formación recomendada por Dataprix

Profundiza en Analítica de Datos con estos cursos en español:

Curso SQL completo → BI y Minería de Datos → Data Analytics + Power BI →

Enlaces de afiliado · Dataprix puede recibir una comisión por tus compras

Lo más visto

Testing de pipelines y datos: qué probar, cuándo y qué no merece la pena

El testing de pipelines de datos es la práctica de verificar la lógica de los pipelines antes de desplegarla, con datos de prueba controlados, igual que se testea cualquier software. Se organiza en tres niveles: tests unitarios, tests de integración y validación de contratos. Es la disciplina complementaria de las validaciones en producción del capítulo 24: aquellas vigilan los datos reales en ejecución; el testing atrapa los errores de lógica cuando corregirlos cuesta minutos, no horas de madrugada..

Orquestación de pipelines: DAGs, reintentos y alertas

Capítulo 25 de la Guía práctica para diseñar y operar la arquitectura de datos de tu empresa. Llevamos varios capítulos construyendo piezas: pipelines de ingesta resilientes, flujos CDC casi en tiempo real y controles de calidad que vigilan cada carga. Este capítulo responde a la pregunta que las une todas: ¿quién dirige la orquesta? Hablamos de orquestación de pipelines: DAGs, dependencias, políticas de reintento y alertas..

Calidad de datos en el pipeline: validaciones, observabilidad y SLAs

La calidad de datos en el pipeline consiste en verificar los datos de forma automática y continua mientras se mueven y transforman, en lugar de descubrir los errores cuando ya han contaminado informes y modelos. Se apoya en tres capas complementarias: validaciones (tests explícitos que bloquean o marcan datos que incumplen reglas conocidas), observabilidad de datos (monitorización continua de frescura, volumen, esquema y distribución para detectar lo que nadie previó) y SLAs de calidad (compromisos medibles con los consumidores del dato). La regla de oro es el shift-left: cuanto antes se detecta un error en el flujo, más barato resulta corregirlo..

CDC y replicación: arquitectura para datos casi en tiempo real — Debezium, log-based vs trigger-based

El Change Data Capture (CDC) es la técnica que detecta y propaga los cambios de una base de datos (inserciones, actualizaciones y borrados) a otros sistemas casi en tiempo real. La aproximación log-based —leer el registro de transacciones de la base de datos— es hoy el estándar de facto porque no impacta en el rendimiento del sistema origen, mientras que las variantes trigger-based y query-based quedan relegadas a casos residuales. Debezium, la plataforma open source (Apache 2.0) del ecosistema Kafka, es la referencia del mercado, con su versión estable 3.5.2 publicada en junio de 2026..

Parte III — Integración de datos y ETL/ELT

Si la Parte II resolvía dónde se guarda el dato, esta tercera parte responde a una pregunta anterior y más incordiante: cómo llega hasta ahí. Entre el sistema que genera un registro y la tabla que alimenta un informe hay un recorrido de extracciones, colas, transformaciones, reintentos y validaciones que rara vez aparece en los diagramas de arquitectura y siempre aparece en los partes de incidencia.

Suscríbete a nuestro boletín

Featured software

Semrush

Semrush reúne en una sola plataforma SaaS todo lo que un equipo de marketing digital necesita para dominar el posicionamiento orgánico, la publicidad de pago y la inteligencia competitiva: más de 55 herramientas integradas, una base de datos de 26.000 millones de palabras clave, 43 billones de backlinks indexados y estimaciones de tráfico para cualquier dominio..
🟢 DataCamp — Aprende datos e IA en español

600+ cursos interactivos de SQL, Python, Power BI y más. Empieza gratis, certifícate como profesional de datos.

Probar Gratis →

Enlace de afiliado · Dataprix puede recibir una comisión

  • twitter
  • linkedin
  • facebook

Dataprix TOP Technology blogs

Licencia de Creative Commons   Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 | Presentacion | Aviso legal

Clear keys input element