
Capítulo 28 · Parte III: Integración de datos y ETL/ELT · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
Una migración de ETL a ELT se decide casi siempre por un motivo que no tiene nada que ver con la arquitectura: una licencia que vence, un servidor que llega al final de su vida o un fin de soporte con fecha publicada. Este capítulo recorre, de principio a fin, cómo una cadena de retail convierte esa fecha en una modernización ordenada de su integración de datos, y qué decisiones separan una migración que termina de una que se queda a medias para siempre.
TL;DR. Vandelar es una cadena de retail ficticia pero representativa, compuesta a partir de patrones habituales en migraciones reales del sector. Su punto de partida: un data warehouse en SQL Server 2016 alimentado por cerca de cuatrocientos paquetes SSIS acumulados durante doce años. Su destino: un modelo ELT sobre Microsoft Fabric, con réplica por CDC de las ventas de tienda, transformaciones versionadas en SQLMesh y orquestación por activos en Dagster. La migración se gana antes de escribir una línea de código nuevo, cuando cada flujo se clasifica en la matriz 3R (migrar tal cual, rediseñar o retirar) y cuando se fija la regla del apagado: ningún flujo entra en operación dual sin fecha firmada para desconectar su equivalente legado. El mayor riesgo del proyecto es técnico solo en apariencia; en la práctica, es la convivencia indefinida de dos plataformas.
Una fecha de fin de soporte sobre la mesa del comité
El orden del día del comité de tecnología de Vandelar tenía un único punto con fecha impresa: el 14 de julio de 2026, día en que SQL Server 2016 alcanzaba el final de su soporte extendido, según anunció la propia Microsoft. Sobre esa versión corría el almacén de datos corporativo de la cadena y, con él, el motor de integración que lo alimentaba: SQL Server Integration Services (SSIS), incluido en la misma licencia.
Conviene dejar claro el régimen del relato desde este primer párrafo. Vandelar es una empresa ficticia: una cadena de tiendas de hogar y bricolaje con alrededor de ciento cincuenta establecimientos en la península ibérica y un canal de comercio electrónico propio, construida para este capítulo a partir de situaciones que se repiten en migraciones de este perfil. Las cifras del caso son estimaciones representativas, no mediciones de un proyecto concreto. Los datos de mercado (fechas de soporte, estado de las herramientas) sí son reales y están fechados.
El comité tenía tres opciones encima de la mesa, y las tres eran defendibles:
- Actualizar en casa. Pasar a una versión soportada de SQL Server en los propios servidores, renovar el hardware y mantener SSIS. Es la opción de menor riesgo inmediato y la que menos cambia el día a día del equipo.
- Comprar tiempo. Contratar las Extended Security Updates (ESU), que Microsoft ofrece para SQL Server 2016 hasta el 17 de julio de 2029 según su FAQ oficial. Solo incluyen parches de seguridad, se pagan por años y, según los análisis de licenciamiento publicados en 2026, su precio crece de forma notable de un año al siguiente.
- Modernizar la integración. Aprovechar la fecha para abandonar el patrón ETL clásico y llevar el almacén y sus transformaciones a una plataforma cloud con un modelo ELT.
La primera opción no era un error. Para muchas organizaciones, con una ventana nocturna holgada y un equipo cómodo con SSIS, actualizar es la respuesta correcta y este capítulo no pretende lo contrario. En Vandelar pesaban tres síntomas que la actualización no curaba: la ventana de carga nocturna ya se desbordaba en campaña, los informes de reposición llegaban a las tiendas con los datos del día anterior, y nadie sabía con certeza cuántos de los paquetes SSIS seguían alimentando algo que alguien leyera. El comité acabó combinando la segunda y la tercera opción: un año de ESU como puente y una migración planificada para no necesitar el segundo.
El punto de partida: una ETL que funcionaba demasiado bien
Es tentador describir el sistema legado como un desastre, y casi nunca lo es. La ETL de Vandelar llevaba doce años cargando datos cada noche con una fiabilidad razonable. Precisamente por eso había crecido sin control: cada nueva necesidad de negocio se resolvía con un paquete más, y ninguno se retiraba nunca porque apagar algo que funciona no tiene patrocinador.
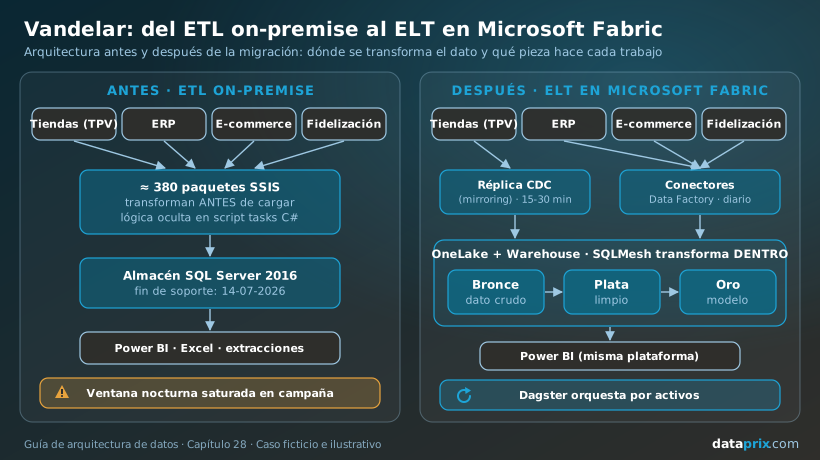
La arquitectura de partida respondía al patrón clásico que el capítulo 20 describe como ETL: extraer de los orígenes, transformar en un servidor intermedio y cargar en el almacén solo el resultado ya elaborado.
- Orígenes. Una base de datos central de ventas en SQL Server que consolidaba los tickets de las tiendas, el ERP corporativo, la plataforma de comercio electrónico, el sistema de fidelización con los datos de clientes y una colección de ficheros planos de proveedores.
- Integración. Unos 380 paquetes SSIS, con una proporción significativa de script tasks en C# donde vivía lógica de negocio que no estaba documentada en ningún otro sitio.
- Almacén. SQL Server 2016 Enterprise en dos servidores físicos, con un modelo en estrella para ventas, stock, márgenes y promociones.
- Consumo. Informes de Power BI, un número indeterminado de hojas de cálculo conectadas directamente al almacén y varias extracciones programadas hacia proveedores.
El dato que más preocupaba al equipo de datos no era técnico. En temporada alta, la carga nocturna necesitaba casi toda la ventana entre el cierre de tiendas y la apertura, y cualquier fallo a media noche obligaba a elegir entre relanzar y llegar tarde o abrir con datos incompletos. El capítulo 22 explica por qué los pipelines que no son idempotentes convierten cada reintento en una apuesta; los paquetes de Vandelar, escritos en otra época, rara vez lo eran.
Por qué ELT, y qué se compra realmente al elegirlo
La tesis de este capítulo cabe en una frase: migrar de ETL a ELT supone cambiar de contrato económico y organizativo, mucho más que cambiar de herramienta. Se paga cómputo del almacén, cada día y de forma visible, a cambio de agilidad para modificar transformaciones, de trazabilidad sobre lo que ocurre con cada dato y de la posibilidad de reprocesar la historia sin volver a extraerla.
Migración ETL a ELT: proceso de trasladar la lógica de transformación de datos desde un motor intermedio, que procesa antes de cargar, al propio almacén de destino, que recibe primero los datos en bruto y los transforma después con SQL versionado. Implica cambiar la herramienta de integración, pero sobre todo el reparto de costes, la propiedad de la lógica de negocio y el modo de probarla.
En Vandelar, ese cambio de contrato tenía tres consecuencias concretas que el comité quiso ver escritas antes de aprobar el presupuesto:
- El coste pasa de fijo a variable. Con SSIS, el coste era la licencia y el hierro, pagados de antemano. En una plataforma cloud, cada transformación consume capacidad y una consulta mal escrita se nota en la factura. Eso exige una disciplina de costes que el equipo nunca había necesitado.
- La lógica sale de las cajas negras. Las reglas de negocio que dormían dentro de script tasks pasan a ser SQL legible, versionado en un repositorio y revisable por cualquiera del equipo. Es la mayor ganancia a largo plazo y también la que más trabajo inicial exige.
- Los datos crudos se conservan. Al cargar antes de transformar, el almacén guarda una copia fiel de cada origen. Cuando una regla de negocio cambia, la historia se recalcula dentro del almacén en vez de volver a pedir a los sistemas operacionales datos que quizá ya no tengan.
Hay un matiz sobre el que se discutió bastante. ELT no elimina la transformación en vuelo: ciertos filtrados, la seudonimización de datos personales antes de que salgan de la red corporativa o la normalización de ficheros de proveedores con formatos imposibles siguen teniendo sentido antes de la carga. La decisión razonable es ELT por defecto y ETL por excepción justificada, y cada excepción se anota con su motivo.
El inventario que decide la migración: la matriz 3R
El error más común en una migración de este tipo es empezar por la herramienta. El equipo elige plataforma, monta el entorno, traduce los primeros paquetes y, seis meses después, descubre que está migrando con esmero flujos que nadie consume. Vandelar dedicó las primeras ocho semanas del proyecto a una única tarea: saber qué tenía.
Cómo se construyó el inventario
El inventario se creó cruzando cuatro fuentes, ninguna de las cuales era suficiente por sí sola:
- Los registros de ejecución del catálogo SSISDB, que dicen qué paquetes corren, con qué frecuencia y cuánto tardan.
- Las dependencias entre tablas del almacén, extraídas del propio SQL de las vistas y procedimientos, para saber qué tabla alimenta a cuál.
- Los metadatos de uso de Power BI y los registros de acceso al almacén, para saber qué tablas lee alguien y quién.
- Entrevistas cortas con los responsables de cada área, reservadas para los casos que los metadatos no resolvían.
Este trabajo es, en esencia, reconstruir a mano un grafo de linaje. En una organización que ya tenga instrumentado su linaje de forma automática, como propone el capítulo sobre automatización del lineage y catálogo de datos, el inventario se reduce de semanas a días. Vandelar no lo tenía, y la migración fue la excusa para empezar a construirlo.
Tres destinos posibles para cada flujo
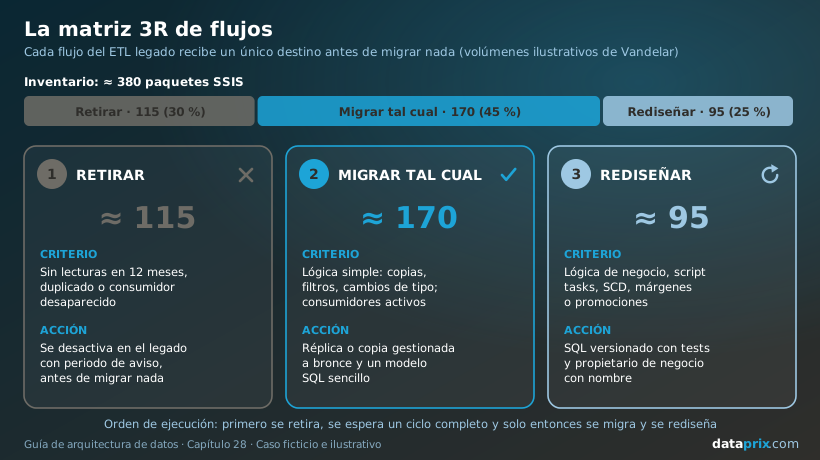
Con el inventario en la mano, cada flujo recibió una de tres etiquetas. La matriz 3R de flujos es el marco de este capítulo y su valor está en obligar a decidir flujo a flujo, en vez de tratar el sistema legado como un bloque:
| Destino | Criterio para asignarlo | Qué se hace | Flujos en Vandelar (ilustrativo) |
|---|---|---|---|
| Migrar tal cual | Lógica simple o inexistente: copia de tablas, filtros, cambios de tipo. Consumidores activos. | Se sustituye por réplica o copia gestionada hacia la capa bronce y un modelo SQL sencillo. | ≈ 170 (45 %) |
| Rediseñar | Lógica de negocio relevante, script tasks, dimensiones lentamente cambiantes, cálculos de margen o de promociones. Consumidores activos. | Se reescribe como modelos SQL versionados, con tests y propietario de negocio nombrado. | ≈ 95 (25 %) |
| Retirar | Sin lecturas registradas en los últimos doce meses, duplicado de otro flujo o consumidor ya desaparecido. | Se desactiva en el legado antes de migrar nada, con un periodo de aviso a posibles usuarios. | ≈ 115 (30 %) |
Proporciones ilustrativas. En migraciones de este perfil es habitual que la fracción retirable se sitúe entre una cuarta y una tercera parte del inventario, pero el rango depende de la edad del sistema y de la disciplina con la que se haya mantenido.
La columna más rentable es la tercera. Retirar un flujo cuesta una conversación y un periodo de aviso; migrarlo cuesta análisis, desarrollo, pruebas y operación dual. En Vandelar, casi un tercio del sistema desapareció antes de empezar a construir, y cada paquete retirado era un paquete menos que traducir y reconciliar. El orden importa: primero se retira en el legado, se espera un ciclo completo para confirmar que nadie reclama, y solo después se planifica lo demás.
La columna del medio es donde se concentra el riesgo. Los flujos a rediseñar contienen la lógica que el negocio da por buena sin saber exactamente cómo se calcula. El caso más ilustrativo en Vandelar fue la definición de venta neta: tres paquetes distintos la calculaban de tres maneras, según se descontaran o no las devoluciones del mismo día y los vales de fidelización. Rediseñar obligó a elegir una, documentarla y avisar a quienes llevaban años viendo otra cifra.
Un contraste desde otro sector
La matriz 3R no se aplica igual en todas partes. En un escenario ilustrativo del sector sanitario, un hospital que migrase su integración encontraría flujos sin consumidores recientes que, sin embargo, no puede retirar: alimentan la conservación de la historia clínica o registros exigidos por la normativa. Allí la columna de retirada se estrecha y aparece una categoría implícita, archivar, que conserva el dato sin mantener el flujo vivo. La lección es trasladable: la matriz se adapta al sector, pero la obligación de decidir flujo a flujo no cambia.
La elección del stack, criterio a criterio
Con el inventario terminado, el equipo sabía qué necesitaba mover y con qué exigencias de frescura. Solo entonces abrió la conversación sobre plataformas. Los criterios se fijaron por escrito antes de ver ninguna demostración comercial, para evitar que la presentación más vistosa decidiera la arquitectura.
Criterio de decisión. En una migración ETL a ELT, la plataforma de destino se elige por el encaje con las competencias del equipo y con el consumo existente antes que por su posición en cualquier clasificación. Un almacén técnicamente superior que el equipo no sabe operar alarga la operación dual, y la operación dual es la partida más cara de todo el proyecto.
El almacén: Microsoft Fabric
Vandelar evaluó cuatro destinos: una versión soportada de SQL Server en sus propios servidores, BigQuery, Snowflake y Microsoft Fabric. Todos podían sostener la carga. La decisión la inclinaron dos hechos del contexto: el equipo dominaba T-SQL y el consumo ya estaba en Power BI. Fabric permitía conservar el lenguaje, situar el almacén y los informes en la misma plataforma y guardar los datos en OneLake en formato de tabla abierto (Delta Parquet), lo que reducía la dependencia del motor concreto. La contrapartida quedó anotada: la capacidad de Fabric se comparte entre todas las cargas, y una transformación pesada compite por recursos con los informes que leen los directores de tienda.
El ranking de plataformas de datos del directorio recoge el veredicto editorial sobre las alternativas que Vandelar descartó, desde Snowflake y Databricks hasta BigQuery y el propio SQL Server. Para una organización con un perfil de competencias distinto, cualquiera de ellas habría sido una elección razonable.
La ingesta: réplica por CDC y copias gestionadas
La base de datos central de ventas era el origen más sensible: recibe los tickets de todas las tiendas y es la que más frescura necesita. Para ella se eligió la réplica de Fabric para SQL Server (mirroring), disponible de forma general y compatible con las versiones 2016 a 2022 mediante captura de cambios (CDC), según la documentación de Microsoft consultada en septiembre de 2026. Detrás del cortafuegos corporativo requiere una puerta de enlace de datos, y la propia documentación advierte de que las transacciones de larga duración pueden hacer crecer el registro de transacciones del origen, un punto que el equipo añadió a la monitorización desde el primer día.
Para el ERP, la plataforma de comercio electrónico y los ficheros de proveedores bastaba con copias periódicas mediante los conectores de Data Factory en Fabric; una herramienta de ingesta gestionada como Airbyte o Fivetran habría cumplido el mismo papel. El capítulo 23 explica las diferencias entre CDC basado en el log y basado en disparadores; aquí bastaba con saber que la réplica leía cambios sin tocar el esquema de la base operacional.
El momento de no desplegar un bus de eventos
Durante la evaluación, un proveedor propuso una arquitectura de streaming completa, con un bus de eventos (Kafka, Redpanda o Event Hubs) recibiendo cada ticket de cada tienda en tiempo real. La propuesta se descartó con un argumento sencillo: el requisito de frescura más exigente de Vandelar era de quince a treinta minutos, para la reposición de stock en tienda. La réplica por CDC lo cubría con holgura, sin un clúster nuevo que operar, sin un equipo que aprender a gestionarlo y sin una segunda vía de datos que reconciliar.
El capítulo 21 propone una prueba sencilla para decidir si un bus de eventos está justificado, y el capítulo 19 desarrolla el coste real de la latencia. Aplicados aquí, ambos dan la misma respuesta: cuando nadie va a actuar en segundos sobre el dato, pagar por entregarlo en segundos es un gasto sin retorno.
La transformación: SQLMesh
Para la capa de transformación, el equipo comparó dbt, SQLMesh y los cuadernos y flujos de datos nativos de Fabric. Eligió SQLMesh por dos capacidades que encajaban con una migración con operación dual: los entornos virtuales, que permiten validar un cambio sobre datos reales sin duplicar tablas, y el análisis del SQL en tiempo de compilación, que detecta errores de columnas y dependencias antes de ejecutar nada. Pesó también el gobierno del proyecto: Fivetran, que había adquirido su creador Tobiko Data en septiembre de 2025, lo donó a la Linux Foundation en marzo de 2026.
La elección tenía un riesgo que el comité aceptó de forma explícita. Según su documentación, el adaptador de SQLMesh para Fabric es una contribución de la comunidad con soporte limitado, y desaconseja usar el Warehouse de Fabric para guardar el estado interno de la herramienta. Vandelar resolvió lo segundo con una pequeña base de datos Azure SQL dedicada a ese estado, y lo primero con un plan B documentado: dbt dispone de adaptador para Fabric Warehouse y los modelos, escritos en SQL estándar, se podían trasladar con un esfuerzo acotado. La madurez de la integración entre dos herramientas pesa tanto como la madurez de cada una por separado.
La orquestación: Dagster
El orquestador elegido fue Dagster, cuyo modelo basado en activos de datos (cada tabla es un activo con dependencias declaradas) encajaba con la forma en que SQLMesh describe los modelos. Existe una biblioteca comunitaria, dagster-sqlmesh, que conecta ambos, y el mismo criterio de prudencia se aplicó: se fijaron sus versiones y se probó la actualización en un entorno aparte antes de cada cambio. El capítulo 25 detalla las políticas de reintentos y alertas que se configuraron sobre él.
La alternativa más sensata para un equipo sin experiencia en Python habría sido orquestar con las canalizaciones nativas de Data Factory en Fabric: menos código, menos piezas y una curva de aprendizaje más suave. Vandelar tenía dos ingenieros con soltura en Python y prefirió la visibilidad del grafo de activos. La elección responde al perfil del equipo más que a las prestaciones de cada herramienta.
Lo que no se eligió: SSIS dentro de Fabric
Microsoft ofrece desde 2026 una actividad para invocar paquetes SSIS dentro de las canalizaciones de Fabric. A fecha de septiembre de 2026 está en versión preliminar y, entre otras limitaciones, no puede conectarse a orígenes on-premise ni admite componentes de terceros. Para Vandelar, cuyos orígenes seguían en sus centros de datos, no servía como puente. Para otras organizaciones con los orígenes ya en la nube, puede ser una forma razonable de ganar tiempo con los flujos de la columna migrar tal cual, siempre que se trate como transitoria.
| Capa | Elección | Alternativas evaluadas | Motivo de la decisión |
|---|---|---|---|
| Almacén | Microsoft Fabric (Warehouse sobre OneLake) | SQL Server soportado on-premise, BigQuery, Snowflake | Continuidad de T-SQL y de Power BI; formato abierto en OneLake |
| Ingesta de ventas | Réplica de Fabric para SQL Server (CDC) | Bus de eventos, DMS de terceros, carga por lotes | Frescura de 15-30 minutos sin infraestructura nueva |
| Ingesta del resto | Conectores de Data Factory | Airbyte, Fivetran | Orígenes con frescura diaria; menos piezas que operar |
| Transformación | SQLMesh | dbt, flujos nativos de Fabric | Entornos virtuales para la operación dual; plan B en dbt |
| Orquestación | Dagster | Canalizaciones de Data Factory, Airflow | Grafo de activos alineado con los modelos; competencias del equipo |
El ranking de herramientas de integración de datos del directorio recoge el veredicto editorial de cada opción, encabezado por Informatica, Azure Data Factory y Oracle Data Integrator; el propio SSIS figura en la clasificación, lo que recuerda que la herramienta de partida no era un problema en sí misma.
Plan por fases, operación dual y la regla del apagado
Una migración de integración no admite un corte de un día para otro: los informes de ventas no pueden quedarse en blanco un lunes. Durante un tiempo, el legado y la plataforma nueva conviven y se comparan. Esa convivencia es imprescindible y es también el lugar donde las migraciones se estancan.
Operación dual: periodo durante el cual un mismo flujo de datos se ejecuta en paralelo en el sistema legado y en el nuevo, y ambos resultados se reconcilian de forma sistemática hasta que se cumplen los criterios pactados para conmutar a los consumidores y apagar el legado.
La regla del apagado
Vandelar adoptó una norma que resultó ser la decisión más rentable del proyecto. La regla del apagado dice: ningún flujo entra en operación dual sin una fecha firmada, por su propietario de negocio, para desconectar su equivalente en el legado. Si la fecha llega y los criterios de conmutación no se cumplen, el caso sube al comité con un diagnóstico; nunca se prorroga en silencio.
Parece burocracia, pero su efecto es el opuesto. Sin fecha de apagado, la operación dual se vuelve cómoda: el legado sigue funcionando, nadie tiene prisa por validar el nuevo flujo y, dos años después, la organización paga dos plataformas, dos equipos de guardia y dos versiones de cada cifra. La fecha firmada convierte la validación en un compromiso con dueño.
Criterios de conmutación
Para que la fecha de apagado sea alcanzable, hace falta saber qué significa «el flujo nuevo está listo». En Vandelar se fijaron cuatro criterios, iguales para todos los flujos:
- Reconciliación. Totales por tienda, día y familia de producto coincidentes entre legado y plataforma nueva durante un número pactado de cierres consecutivos, incluido al menos un cierre de mes. Tolerancia cero en importes de venta; tolerancia documentada en métricas derivadas.
- Frescura. El objetivo de nivel de servicio del flujo se cumple durante el mismo periodo, medido con las prácticas del capítulo 24.
- Consumidores repuntados. Cada informe y cada extracción que leía el flujo legado apunta ya a la tabla nueva, y su responsable ha validado el resultado.
- Vuelta atrás ensayada. Existe un procedimiento para volver al legado, y se ha ejecutado al menos una vez en un entorno de pruebas.
La reconciliación se automatizó con comparaciones de datos entre ambos sistemas, el mismo principio de data diff que el capítulo 26 presenta para las revisiones de código. Una diferencia tampoco implica, por definición, un fallo del flujo nuevo: en Vandelar, aproximadamente una de cada cinco discrepancias investigadas en la primera ola resultó ser un error antiguo del legado que nadie había detectado. Cada hallazgo de ese tipo se documentaba y se comunicaba al área afectada antes de conmutar, porque la cifra «correcta» iba a cambiar lo que veían.
Las fases y el calendario comercial
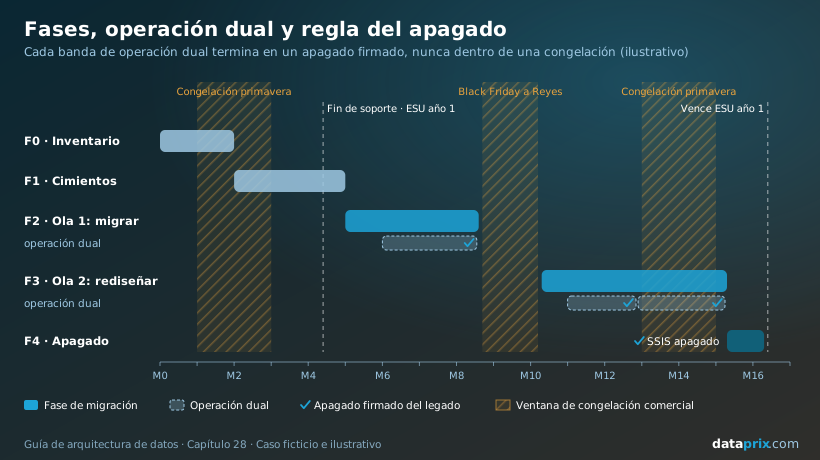
El retail impone una restricción que otros sectores no tienen con la misma intensidad: hay semanas en las que no se toca nada. En Vandelar, la campaña de primavera (jardín y terraza) y el periodo entre Black Friday y Reyes eran ventanas de congelación. El plan se construyó alrededor de ellas, como un dato de planificación más:
- Fase 0, inventario (unas 8 semanas). Matriz 3R, contratación del primer año de ESU, retirada de los primeros flujos sin consumidores.
- Fase 1, cimientos (unos 3 meses). Capacidades de Fabric separadas para ingesta y transformación y para consumo, réplica de la base de ventas, repositorio de SQLMesh, Dagster, integración continua y los primeros modelos de la capa bronce.
- Fase 2, primera ola (unos 4 meses). Flujos de migrar tal cual de ventas y stock, en operación dual, con conmutación escalonada por dominio. Termina antes de la congelación de otoño.
- Fase 3, segunda ola (unos 5 meses). Flujos de rediseñar: márgenes, promociones y fidelización, con nuevas definiciones pactadas con negocio. Arranca tras Reyes.
- Fase 4, apagado (unas 6 semanas). Últimas conmutaciones, parada de SSIS, copia de seguridad final y retirada de los servidores, antes de que venza el primer año de ESU.
Duraciones ilustrativas. En migraciones de este tamaño es habitual un horizonte total de entre doce y dieciocho meses; la variable que más lo alarga es el volumen de la columna rediseñar.
Los riesgos que se materializaron
Ninguna migración sale como estaba escrita. Estos son los problemas que el equipo de Vandelar encontró, ordenados de más a menos caro, junto con la forma en que se contuvieron. Son también los anti-patrones más frecuentes en proyectos de este tipo.
El anti-patrón más caro: la operación dual sin final. A mitad de la segunda ola, tres flujos de promociones acumulaban dos prórrogas cada uno porque su propietario de negocio no encontraba tiempo para validar. La regla del apagado obligó a llevarlos al comité, que asignó a un analista a tiempo parcial para la validación y fijó una fecha no negociable. Sin la regla, esos tres flujos habrían mantenido vivos el servidor de SSIS, la licencia y la guardia nocturna durante un periodo indefinido.
La lógica escondida en código. Unas decenas de paquetes contenían script tasks con reglas que no aparecían en ningún documento: redondeos de precios por país, exclusiones de tiendas en obras, correcciones manuales de un proveedor concreto. La mitigación fue tratar cada script task como un flujo de rediseñar por defecto, aunque el resto del paquete fuera trivial, y exigir que cada regla recuperada quedara escrita como un modelo SQL con un test asociado. Lección: en un sistema legado, el código que nadie lee es donde vive la lógica que todos usan.
La primera factura. El primer mes completo con cargas reales superó la estimación. La causa fue una combinación de modelos que recalculaban tablas completas cada hora cuando podían procesar solo los cambios, y consultas de exploración lanzadas sobre la misma capacidad que las cargas de producción. Se corrigió con modelos incrementales, con la separación de capacidades por uso y con una revisión semanal de consumo que pasó a formar parte del ritual del equipo. Lección: en ELT cloud, la eficiencia del SQL deja de ser una cuestión de estilo y pasa a ser una partida del presupuesto.
Las cifras que cambian. La nueva definición de venta neta hizo que algunos informes mostraran importes distintos a los de siempre. Donde se comunicó antes de conmutar, se aceptó; donde no, generó desconfianza en la plataforma nueva durante semanas. Lección: cada cambio de definición es un cambio de producto y necesita un aviso, igual que un cambio de precio.
El registro de transacciones del origen. Durante una operación de mantenimiento en la base de ventas, una transacción larga hizo crecer el registro de transacciones más de lo previsto mientras la réplica esperaba. La alerta configurada desde el primer día permitió actuar a tiempo. Lección: la réplica por CDC traslada parte de su coste al sistema origen, y ese coste tiene que vigilarlo alguien que conozca el origen.
Los cambios de esquema en origen. Una actualización del ERP renombró columnas que alimentaban la capa bronce. Los tests de contrato en integración continua lo detectaron antes de llegar a producción, y el cambio se absorbió con el patrón de expandir y contraer que describe el capítulo 17.
Riesgo legal: los datos de fidelización. Llevar a la nube los datos personales del programa de fidelización convierte al proveedor en encargado del tratamiento (art. 28 del RGPD) y exige revisar el contrato, la región de almacenamiento y las transferencias internacionales. Vandelar seudonimizó los identificadores de cliente antes de la carga, una de las excepciones justificadas al principio de ELT, y documentó el nuevo tratamiento en su registro de actividades. El derecho de supresión, además, obliga a saber en qué tablas derivadas acaba cada dato personal, lo que vuelve a llevar al linaje.
Lo que Vandelar haría de otra manera
En la revisión posterior al proyecto, el equipo reunió las decisiones que repetiría y las que cambiaría. Las primeras ya han aparecido: inventario antes que herramienta, matriz 3R, regla del apagado, criterios de conmutación iguales para todos. Las segundas son más útiles para quien empieza.
Retirar antes y con más ambición. La primera ronda de retirada fue prudente y dejó vivos flujos dudosos «por si acaso». En la segunda ola, casi todos acabaron retirados igualmente. Un periodo de aviso con desactivación real (el flujo se apaga y se reactiva solo si alguien lo reclama) habría ahorrado semanas.
Nombrar propietarios de negocio en la fase 0. Los flujos que más se retrasaron fueron los que no tenían un responsable claro fuera del equipo de datos. La propiedad se asignó sobre la marcha y debió asignarse en el inventario.
Instrumentar el linaje desde el primer modelo. SQLMesh y Dagster emiten información de dependencias que el equipo tardó meses en aprovechar. Haberla volcado en un catálogo desde el inicio habría facilitado el análisis de impacto de cada cambio y la respuesta a las solicitudes de supresión de datos personales.
Formar antes de construir. Dos de los cinco ingenieros aprendieron SQLMesh mientras migraban flujos de producción. El resultado fue funcional, pero la primera ola incluyó modelos que hubo que rehacer cuando el equipo dominó los modelos incrementales. Una formación corta y un proyecto piloto con flujos retirables habrían evitado ese retrabajo.
El caso homólogo de la Parte II, la fintech ficticia del capítulo 18, llegaba a una conclusión parecida desde otro ángulo: las decisiones de plataforma envejecen mejor cuando se toman sobre un inventario realista de lo que se tiene y de lo que el equipo sabe operar.
Checklist reutilizable para una migración ETL a ELT
Esta lista resume el recorrido de Vandelar en pasos aplicables a cualquier organización. No todos los puntos tienen el mismo peso en todos los contextos, pero saltarse cualquiera de los cinco primeros suele salir caro.
- Existe un inventario completo de flujos, construido con registros de ejecución, dependencias entre tablas y datos de uso, no solo con entrevistas.
- Cada flujo tiene asignado un destino de la matriz 3R (migrar tal cual, rediseñar o retirar) y un propietario de negocio con nombre.
- Los flujos a retirar se han desactivado en el legado, con periodo de aviso, antes de empezar a migrar.
- Los criterios de selección de plataforma se escribieron antes de ver demostraciones comerciales e incluyen las competencias del equipo.
- Cada flujo en operación dual tiene fecha de apagado firmada y los criterios de conmutación (reconciliación, frescura, consumidores repuntados, vuelta atrás ensayada) son iguales para todos.
- La reconciliación entre legado y plataforma nueva está automatizada y cada discrepancia se clasifica como error del flujo nuevo o del legado.
- El requisito real de frescura de cada consumidor está documentado, y la arquitectura de ingesta se dimensiona para él y no para el máximo teórico.
- La lógica de las script tasks y del código embebido se ha recuperado como SQL versionado con tests.
- Hay separación de capacidades o de presupuestos entre ingesta, transformación y consumo, con una revisión periódica de coste.
- Los cambios de definición de métricas se comunican a los consumidores antes de conmutar.
- Las ventanas de congelación comercial están marcadas en el plan y ninguna conmutación cae dentro de ellas.
- El tratamiento de datos personales en la nueva plataforma está revisado: contrato de encargado, región, seudonimización y registro de actividades.
- El linaje de los nuevos modelos se publica en un catálogo desde el primer día.
- Existe una fecha de apagado total del legado, alineada con el vencimiento de licencias o de soporte extendido.
Formación recomendada
Para equipos que vayan a trabajar con Microsoft Fabric como destino de una migración, estos dos cursos cubren la plataforma de forma práctica. Ambos están disponibles en español.
- Introducción a Microsoft Fabric (DataCamp): curso de unas cuatro horas que recorre Data Factory, Lakehouse, Warehouse y Power BI dentro de Fabric. Adecuado como formación previa para todo el equipo antes de la fase de cimientos.
- Microsoft Fabric: Curso completo de Microsoft Fabric (Udemy): recorrido más extenso por almacenamiento, canalizaciones, transformación, Spark y gobierno en OneLake, útil para los ingenieros que asumirán la operación de la plataforma.
Recursos y lecturas recomendadas
Dentro de la guía, el recorrido completo de la Parte III está en su página de presentación, y el índice general de la guía sitúa este caso en el conjunto del libro. Los capítulos que más directamente sostienen las decisiones de Vandelar son el 20 (ETL frente a ELT), el 23 (CDC y replicación), el 24 (calidad y SLAs), el 25 (orquestación) y el 26 (testing y contratos).
- Joe Reis y Matt Housley, Fundamentals of Data Engineering (O'Reilly, 2022): el ciclo de vida de la ingeniería de datos y los criterios para elegir tecnologías, con un enfoque independiente de proveedor.
- Documentación de la réplica de Fabric para SQL Server: versiones compatibles, requisitos de red y limitaciones.
- Documentación de SQLMesh para Fabric: configuración del adaptador y advertencias sobre el estado interno.
- Documentación de Dagster: el modelo de activos de datos y sus integraciones.
- Preguntas frecuentes de Microsoft sobre las ESU de SQL Server: plazos y condiciones del soporte extendido de seguridad.
Preguntas frecuentes
¿Cuánto dura una migración de ETL a ELT en una empresa mediana?
En migraciones de unos cientos de flujos, es habitual un horizonte de doce a dieciocho meses desde el inventario hasta el apagado del legado. La variable que más lo alarga es el número de flujos que hay que rediseñar, porque contienen lógica de negocio que debe recuperarse, validarse y, a menudo, redefinirse con el área afectada.
¿Qué es la matriz 3R de flujos?
Es un marco para clasificar cada flujo del sistema de integración legado en uno de tres destinos: migrar tal cual (lógica simple con consumidores activos), rediseñar (lógica de negocio relevante que se reescribe con tests) o retirar (sin consumidores o duplicado). Obliga a decidir flujo a flujo y hace que la retirada, que es la opción más barata, se ejecute antes que cualquier migración.
¿Se pueden reutilizar los paquetes SSIS en la nube?
Parcialmente. Microsoft Fabric ofrece una actividad para invocar paquetes SSIS dentro de sus canalizaciones, pero a septiembre de 2026 está en versión preliminar y no admite orígenes on-premise ni componentes de terceros. Puede servir como puente temporal para flujos sencillos con orígenes ya en la nube; no sustituye la reescritura de la lógica de negocio como SQL versionado.
¿Hace falta Kafka para alimentar el warehouse con ventas de tienda casi en tiempo real?
Depende del requisito de frescura real. Si el consumidor más exigente necesita datos con quince o treinta minutos de retraso, una réplica por CDC desde la base de datos de ventas lo cubre sin desplegar ni operar un bus de eventos. Un bus como Kafka, Redpanda o Event Hubs se justifica cuando hay consumidores que actúan en segundos o varios sistemas que deben reaccionar a los mismos eventos.
¿Cuánto tiempo deben convivir el ETL legado y el nuevo pipeline?
El mínimo necesario para cumplir criterios de conmutación pactados: reconciliación correcta durante varios cierres consecutivos, incluido un cierre de mes, frescura dentro del objetivo, consumidores repuntados y vuelta atrás ensayada. La regla del apagado exige que cada flujo tenga fecha firmada de desconexión del legado antes de entrar en operación dual, para que la convivencia no se vuelva indefinida.
¿ELT sale más caro que ETL?
Cambia la estructura del coste más que su nivel. ETL concentra el gasto en licencias y servidores pagados de antemano; ELT lo convierte en consumo variable del almacén, que crece con transformaciones ineficientes y baja con modelos incrementales y separación de cargas. Sin una revisión periódica de consumo, la primera factura suele superar la estimación.
Una pregunta para el propio inventario
La historia de Vandelar tiene poco de heroico y mucho de método. El cambio de plataforma fue la parte visible, pero lo que decidió el resultado fueron ocho semanas de inventario, una clasificación estricta de cada flujo y una fecha de apagado firmada por alguien que no pertenecía al equipo de datos. Con este caso se cierra la Parte III: los datos ya llegan, se transforman, se prueban y se vigilan. La Parte IV, dedicada al Business Intelligence y al consumo, se ocupa de lo que viene después, cuando esos datos tienen que convertirse en decisiones.
Queda una pregunta que cada organización puede hacerse hoy mismo, tenga o no una fecha de fin de soporte a la vista: si mañana hubiera que clasificar todos los flujos de integración en migrar, rediseñar o retirar, ¿cuántos podría asignar con datos, y cuántos tendría que asignar a ciegas?
Fin de la Parte III. Siguiente: Parte IV, Business Intelligence y consumo, que arranca con el capítulo 29, Estrategia de BI: del informe al producto de datos. · Volver a la Parte III · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 29 de septiembre de 2026.
