
Capítulo 27 · Parte III: Integración de datos y ETL/ELT · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
En septiembre de 2026, el repositorio de Amundsen se archivó por inactividad. El catálogo de datos que Lyft liberó en 2019 —el que popularizó la idea de buscar tablas igual que se busca una página web— quedó en modo lectura con una nota breve: el contenido seguirá disponible con fines históricos. No hubo quiebra ni adquisición; hubo un proyecto que dejó de tener quien lo empujara. Coincide con lo que le pasa dentro de las empresas a gran parte de los catálogos de datos: nadie los cancela, simplemente dejan de actualizarse.
Ese abandono, sin embargo, no es uniforme. Un catálogo no muere entero: se muere por una mitad muy concreta, mientras la otra sigue viva sin que nadie la atienda. Entender por qué unas piezas del inventario se regeneran solas y otras se pudren en cuanto se deja de mirarlas distingue el proyecto de catalogo de datos que perdura años del que se presenta en comité, se llena en seis semanas y se consulta por última vez el trimestre siguiente.
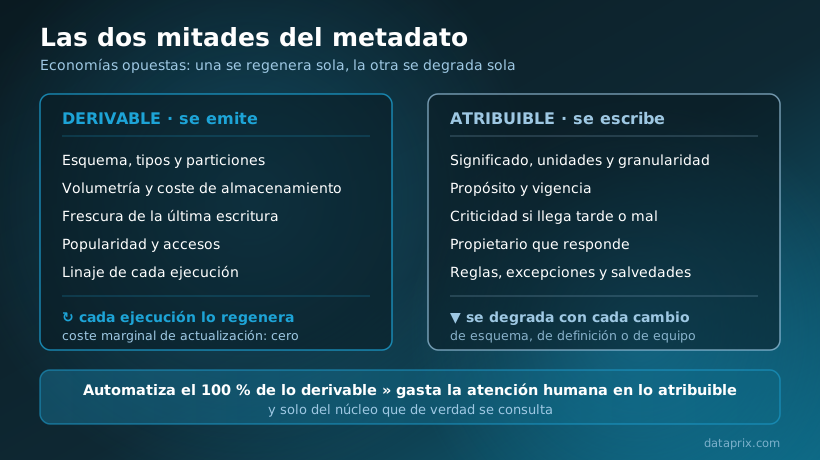
TL;DR. El metadato de una plataforma de datos se reparte en dos mitades con economías opuestas. La mitad derivable —esquemas, volumetrías, frescura, popularidad y, sobre todo, el linaje— la emiten los propios sistemas en cada ejecución y se regenera sola: automatizarla es un problema de instrumentación con estándar propio (OpenLineage) y conectores para los motores habituales. La mitad atribuible —qué significa un campo, para qué decisiones sirve, quién responde de él y cuánto duele si falla— solo la puede escribir una persona, y se degrada con cada cambio del sustrato que describe. Los catálogos mantenidos a mano se abandonan porque intentan sostener la segunda mitad al ritmo de la primera. La salida no pasa por escribir más deprisa, sino por escribir menos: documentar al 100 % el conjunto pequeño de activos que de verdad se consulta y dejar que el resto viva del metadato emitido.
La mitad que se emite y la mitad que se escribe
El inventario de datos corporativo acumula dos décadas de intentos con el mismo patrón: primero el diccionario en una hoja de cálculo mantenido por sistemas, después el wiki departamental con una plantilla que nadie rellenaba del todo, más tarde las suites de gobierno con su glosario empresarial y su despliegue por dominios. Cambiaron la interfaz, el presupuesto y el vocabulario; no cambió el desenlace, porque el contenido envejecía más rápido de lo que se actualizaba.
La explicación habitual —falta de cultura de datos, de disciplina o de patrocinio— describe síntomas, no mecanismos. El mecanismo es más simple: el inventario mezcla dos tipos de información que se comportan de forma radicalmente distinta, y las herramientas de la primera generación las trataron igual, con el mismo formulario y el mismo propietario.
Metadato derivable y metadato atribuible
Metadato derivable es aquel que puede reconstruirse a partir del funcionamiento observable de los sistemas, sin intervención humana: esquemas y tipos, particiones, volumetrías, marcas de tiempo de última escritura, frecuencia de consulta, usuarios que acceden, y el linaje de cada ejecución. Metadato atribuible es aquel que expresa significado, intención o responsabilidad, y que ningún sistema puede deducir de su propia ejecución porque no está contenido en ella: qué representa un campo en el mundo real, por qué existe una regla, qué decisiones dependen de un indicador, quién responde cuando ese indicador falla.
La distinción no es académica; es económica. El metadato derivable tiene un coste de producción que se paga una sola vez —instrumentar la emisión— y un coste marginal de actualización prácticamente nulo, porque cada ejecución del pipeline vuelve a producirlo. Si mañana se añade una columna, el esquema catalogado la refleja en la siguiente pasada sin que nadie escriba nada. Si un proceso deja de ejecutarse, la frescura del activo lo delata sola.
El metadato atribuible funciona al revés. Su coste de producción es alto, porque exige el tiempo de alguien que sabe algo que no está escrito en ningún sitio, y su coste de mantenimiento no baja nunca: cada cambio de esquema, cada redefinición de una regla de negocio y cada rotación de persona en un equipo lo desactualizan un poco más. Peor aún, ese deterioro es silencioso. Una descripción equivocada no lanza ninguna alerta; se queda ahí, con el mismo aspecto de una correcta, hasta que alguien toma una decisión apoyándose en ella.
Por qué el deterioro es inevitable y no es un problema de disciplina
Tres mecanismos explican ese deterioro, y ninguno de los tres es la falta de disciplina que suele invocarse. El primero es aritmético: un catálogo mantenido a mano compite contra la tasa de cambio del sustrato que describe, y en una plataforma con varios cientos de tablas los cambios de esquema semanales se cuentan por docenas. Mantener la documentación al día exige un caudal de escritura proporcional al caudal de cambio, y ese caudal no lo absorbe ningún equipo que además tenga que entregar.
El segundo es la falta de realimentación. Quien escribe la descripción de una tabla casi nunca es quien la consulta, y quien la consulta rara vez avisa de que está mal. Sin señal de utilidad ni de error, documentar deja de comportarse como el resto del trabajo de ingeniería —donde un fallo se manifiesta— y pasa a ser un trámite; las tareas sin realimentación pierden siempre la competición por la atención. El tercero es de incentivos mal repartidos: el coste lo paga el equipo productor y el beneficio lo recibe el consumidor, casi siempre de otro departamento. Los catálogos que aguantan resuelven esto dando al productor algo a cambio de escribir —análisis de impacto antes de tocar un esquema, propagación automática de clasificaciones, menos interrupciones preguntándole qué significa un campo—.
De ahí la regla que ordena el resto del capítulo: automatiza todo lo derivable, no para ahorrar trabajo, sino para concentrar la escasa atención humana disponible en la parte atribuible de un conjunto pequeño de activos. Quien documenta a mano lo que la máquina puede emitir se queda sin presupuesto de atención justo donde la máquina no llega.
Los tres grados del metadato
Medir la madurez de un catálogo por el número de activos cargados lleva a conclusiones equivocadas, porque premia justo lo que resulta barato y no sirve. Un marco más útil para situar dónde está una organización distingue tres grados, y la pregunta relevante en cada uno no es si la organización lo tiene documentado, sino si lo tiene automatizado.
| Grado | Qué responde | Cómo se alimenta | Señal de que está de verdad |
|---|---|---|---|
| 1. Inventario | Qué activos existen, dónde están, qué forma tienen, cuándo se actualizaron por última vez y quién los consulta | Extracción periódica de catálogos de sistema, registros de consulta y metadatos de almacenamiento | Un activo nuevo aparece sin que nadie lo dé de alta, y uno abandonado se detecta sin que nadie lo revise |
| 2. Linaje | De dónde viene cada activo, qué lo alimenta, qué depende de él y qué transformación media entre ambos | Emisión desde el orquestador y el motor de transformación; análisis de sentencias SQL para lo que no emite | El grafo refleja la ejecución de ayer, no el diseño documentado hace un año |
| 3. Activación | Qué hace el sistema con ese conocimiento sin que nadie se lo pida | Reglas que consumen el grafo: propagación de clasificaciones, avisos de impacto en integración continua, expedientes regulatorios, retirada de activos muertos | Un cambio de esquema se frena o se avisa antes de desplegarse, no después de romper un informe |
La mayoría de las organizaciones que creen tener un catálogo están en el grado 1 con una capa cosmética de grado 2: un grafo dibujado a mano en el arranque, que ilustra la arquitectura de la que se habló en una reunión y no la que está en producción. El salto que cambia la relación con el catálogo es el tercero, el que separa el metadato pasivo —el que espera a que alguien lo consulte— del metadato activo, el que dispara acciones en otros sistemas. Un catálogo de grado 1 se puede desconectar un martes y nadie se entera hasta el viernes; uno de grado 3 rompe un despliegue, y por eso se arregla.
Cómo se emite el linaje en la práctica
El linaje es el mejor ejemplo de metadato derivable y, durante años, el que peor se ha ido documentando: a mano. Un diagrama de flujos en una herramienta de dibujo es la forma más cara y menos fiable de saber qué alimenta a qué, porque cuesta horas, envejece a la primera modificación del pipeline y ningún programa puede consultarlo.
OpenLineage: un estándar para no reimplementar doce veces lo mismo
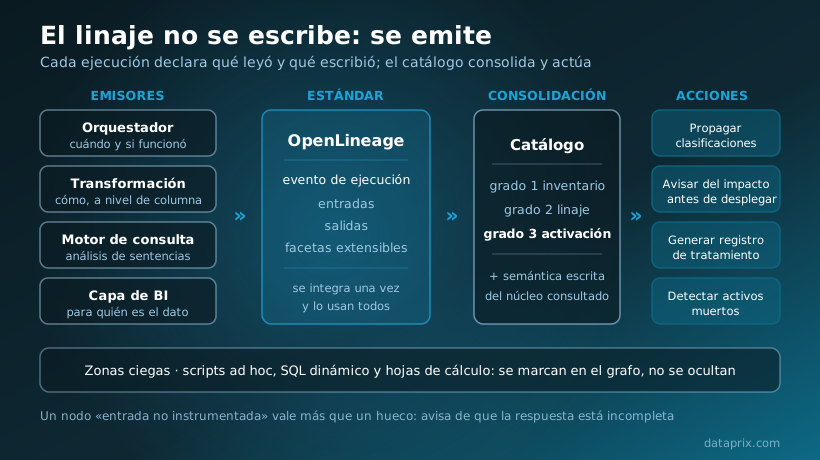
OpenLineage es una especificación abierta para recoger metadatos de linaje. Define un modelo de eventos —una ejecución de un trabajo, con las entradas que leyó y las salidas que escribió, más facetas extensibles con esquema, estadísticas o información de columna— de forma que cualquier sistema que lo emita pueda ser entendido por cualquier catálogo que lo consuma. Es un proyecto graduado de la LF AI & Data Foundation, en desarrollo activo, con versión estable en la rama 1.5x a fecha de septiembre de 2026.
Su aportación es de coordinación más que tecnológica. Antes de que existiera, cada catálogo escribía su propio conector para cada motor y cada motor su propio formato de salida: una matriz de integraciones imposible de mantener y una dependencia práctica del proveedor. Con un estándar de por medio, integrar Spark se hace una vez y lo aprovechan todos los consumidores. Para la selección de plataforma esto tiene una consecuencia concreta: el soporte real de OpenLineage es lo que hace reversible la decisión.
Del lado emisor, la especificación cubre hoy los puntos habituales de una plataforma —Apache Spark, Apache Flink, Apache Hive, Trino, dbt, Great Expectations, Feast y los orquestadores—, más un módulo de análisis de SQL para reconstruir el linaje de sentencias ejecutadas contra motores que no emiten nada por su cuenta. Del lado consumidor, Marquez es una implementación de referencia, también alojada en la LF AI & Data Foundation, y funciona bien como banco de pruebas antes de comprometerse con una plataforma mayor.
Los tres puntos donde se captura, y lo que aporta cada uno
El orquestador es el primer sitio donde instrumentar, porque conoce el mapa de dependencias entre tareas y el resultado de cada ejecución: aporta el cuándo y el si funcionó, que es lo que permite hablar después de frescura y de incidencias, como se planteó al tratar la orquestación de pipelines. Airflow emite a través de su proveedor de OpenLineage; Dagster parte de un modelo de activos que ya es, en la práctica, un grafo declarado; Prefect y las alternativas gestionadas de cada nube ofrecen enganches equivalentes, y la comparativa de herramientas de integración de esta misma parte sitúa a cada una.
El motor de transformación aporta el cómo, que es la parte cara de reconstruir por otros medios. Las herramientas declarativas publican artefactos con el grafo de dependencias y la definición de cada modelo —el manifiesto de dbt es el caso más extendido; SQLMesh y Dataform ofrecen equivalentes—, y de ahí sale un linaje de calidad prácticamente gratis, como subproducto de la compilación. Conviene anotar que el segmento se ha movido: la fusión de Fivetran y dbt Labs se cerró el 1 de junio de 2026 y dbt Core v2.0, con el motor Fusion, se publicó bajo licencia Apache 2.0, lo que concentra ingesta y transformación en un mismo proveedor.
El motor de consulta y la capa de consumo aportan el linaje que casi todos los proyectos olvidan: qué informes, cuadros de mando y extracciones dependen de cada tabla. Un grafo que termina en la última tabla del almacén describe media realidad, justamente la mitad sin consecuencias visibles para el negocio. Cuando alguien pregunta qué se rompe si cambia una columna, la respuesta que sirve habla del informe del comité de dirección que deja de cuadrar, y no de la tabla intermedia que queda afectada por el camino.
Linaje de tabla y linaje de columna
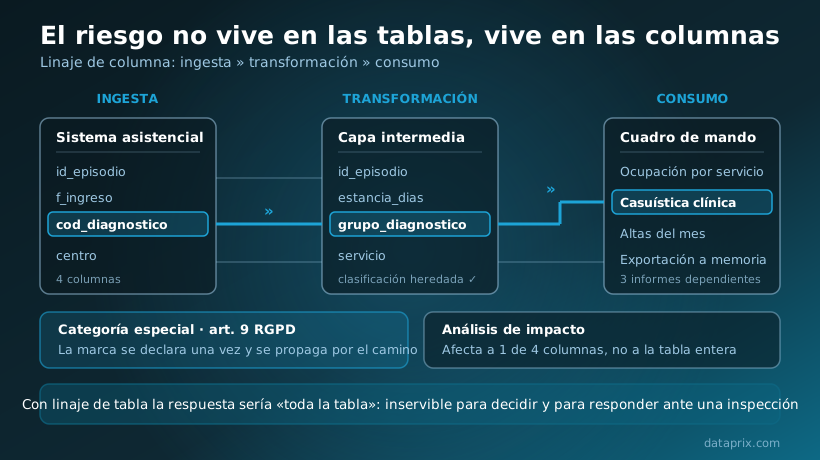
El linaje a nivel de tabla describe dependencias entre activos y basta para orientarse. El de columna sigue la procedencia de cada campo a través de las transformaciones, y es el que hace posibles las dos cosas que justifican una inversión seria: el análisis de impacto preciso —saber que el cambio afecta a tres de las ciento veinte columnas que salen de esa tabla, y no a la tabla entera— y el seguimiento de datos sensibles, porque el riesgo regulatorio no vive en las tablas, vive en las columnas. Una tabla no es de categoría especial; lo es el campo de diagnóstico que viaja desde el sistema asistencial hasta un cuadro de mando de ocupación.
La contrapartida es el coste: exige analizar las sentencias de transformación con precisión —no todos los motores ni todos los dialectos se resuelven igual de bien— y genera un grafo con uno o dos órdenes de magnitud más de nodos. La aproximación sensata es escalonada: linaje de tabla en toda la plataforma, linaje de columna solo en los dominios con datos personales, obligaciones regulatorias o indicadores que llegan al consejo.
Las zonas ciegas del grafo
Ningún grafo de linaje está completo, y conviene decirlo en el comité antes de que lo descubra alguien por su cuenta. Las zonas ciegas habituales son cinco:
- Código opaco. Funciones definidas por el usuario, procedimientos almacenados con SQL dinámico y trabajos que construyen la consulta en ejecución: el analizador ve la sentencia, pero no puede resolver qué tabla acabará leyendo.
- Scripts ad hoc. El proceso que alguien programó fuera del orquestador porque era para una sola vez y lleva tres años ejecutándose. No emite nada porque no pasa por ninguna pieza instrumentada.
- Movimientos por fichero. Exportaciones a un almacenamiento intermedio que otro proceso recoge más tarde: la cadena se corta ahí salvo que se instrumente la entrega.
- La hoja de cálculo final. El informe que se descarga, se cruza a mano con un fichero del proveedor y se envía por correo. Ahí termina buena parte de la cadena real de decisión, y ningún catálogo llega.
- La capa de consumo mal conectada. Herramientas de BI cuyo modelo semántico define sus propios cálculos: el catálogo ve el informe, pero no la fórmula que hay dentro.
Ante estas zonas, la reacción productiva pasa por hacerlas visibles en el propio grafo antes que por intentar cubrirlas todas. Un nodo marcado como «entrada no instrumentada» vale mucho más que un hueco, porque avisa de que la respuesta está incompleta en vez de dejar creer que se ha visto el mapa entero. Es la misma honestidad operativa que rige la observabilidad en la capa de datos: una métrica que falta debe verse como faltante, no como cero.
Lo que ninguna herramienta va a escribir
Automatizado todo lo derivable, queda un residuo que ningún conector produce y que es, precisamente, lo que la gente busca cuando entra en el catálogo. Nadie lo abre para averiguar el tipo de dato de una columna: para eso está el motor. Lo abre para responder preguntas de otra naturaleza.
- Semántica. Qué representa el campo en el mundo real, con sus unidades, su granularidad y sus excepciones. La diferencia entre «fecha de alta» como fecha administrativa de registro y como fecha efectiva del servicio ha provocado más informes incorrectos que cualquier fallo de infraestructura.
- Propósito y vigencia. Para qué se creó el activo, qué decisiones se apoyan hoy en él y si sigue siendo el sitio correcto donde mirar. Tres tablas con nombres parecidos y una sola vigente es el escenario normal, no el patológico.
- Criticidad y responsabilidad. Qué pasa si llega tarde o llega mal —lo que convierte una alerta genérica en una prioridad y permite dimensionar los acuerdos de nivel de servicio tratados al hablar de calidad de datos en el pipeline— y quién decide sobre la definición frente a quién responde de la operación, que no siempre coinciden.
- Reglas y salvedades. Por qué se excluyen ciertos registros, qué corrección histórica se aplicó y qué ocurre con los datos anteriores a la última migración.
Todo esto es metadato atribuible puro. Automatizarlo está descartado por definición, así que la pregunta operativa es cómo abaratarlo lo suficiente para que se escriba y se mantenga. Cuatro palancas funcionan de verdad.
Propagar por el grafo. Una clasificación de sensibilidad o una definición escrita en el origen puede heredarse aguas abajo siguiendo el linaje de columna, con revisión donde la transformación cambia el significado: se escribe una vez y aparece en cincuenta sitios. Es la razón práctica por la que conviene empezar por el linaje y no por el glosario, porque sin grafo cada descripción hay que escribirla tantas veces como copias del dato existan.
Mover la escritura al sitio donde ya se trabaja. Una descripción que vive en el repositorio junto a la definición del modelo y se publica al desplegar se actualiza en la misma revisión de código que cambia el esquema; una que vive en un formulario web aparte se actualiza cuando alguien se acuerda. Los contratos de datos tratados en el capítulo sobre testing de pipelines y datos encajan aquí de forma natural: el contrato ya contiene esquema, semántica, expectativas de servicio y propietario, y es un artefacto versionado que se valida en integración continua. Un catálogo que consume contratos obtiene metadato atribuible con la frescura del código.
Generar borradores y revisarlos. Las plataformas actuales proponen descripciones a partir del nombre, del contenido y de la posición en el grafo. Como acelerador de la primera pasada funciona y ahorra el arranque en frío que hunde tantos proyectos.
Cuidado con la tentación de rellenar. Una descripción generada y no revisada tiene exactamente el mismo aspecto que una correcta, y añade un riesgo que la casilla vacía no tenía: la casilla vacía avisa de que nadie sabe; la descripción plausible pero equivocada invita a decidir sobre ella. Si las sugerencias automáticas se publican sin que una persona las valide, el catálogo no gana cobertura: gana una superficie nueva de error, y además pierde la señal que permitía saber dónde faltaba conocimiento. Lo mismo vale para las campañas de documentación por objetivos: cuando la meta es el porcentaje, el porcentaje se cumple.
Aprovechar la pregunta como momento de captura. El instante en que alguien pregunta por un campo es el único en el que existe a la vez la duda y la persona que sabe. Un catálogo que permite preguntar sobre el activo y convierte la respuesta en documentación aprovecha ese momento; uno que obliga a ir a un formulario aparte lo desperdicia, y la respuesta se queda en un hilo de chat.
Cobertura útil: el criterio que sustituye al porcentaje de activos documentados
Casi todos los proyectos de catalogación se gobiernan con el porcentaje de activos que tienen descripción no vacía. Tiene dos virtudes —es fácil de calcular y sube— y un defecto que las anula: mide exactamente lo que no importa. Un 80 % alcanzado rellenando campos con el nombre de la tabla en prosa es peor que un 12 % honesto, porque el primero cierra la conversación y el segundo la abre.
Criterio de decisión del capítulo. Documenta al 100 % el conjunto pequeño de activos que de verdad se consulta, en lugar de perseguir un porcentaje de cobertura sobre el total. La métrica que hay que llevar al comité no es la cobertura nominal (qué proporción de los activos tiene el campo descripción relleno), sino la cobertura útil: qué proporción de las consultas realmente ejecutadas en el último trimestre aterriza sobre activos con propietario identificado, semántica escrita y linaje al día. La primera se cumple rellenando; la segunda solo se cumple documentando lo que la gente usa.
Cambiar de métrica cambia el proyecto entero, porque cambia el orden de trabajo. Con cobertura nominal se empieza por donde es cómodo: el dominio cuyo responsable colabora, las tablas pequeñas, lo que está más ordenado. Con cobertura útil se empieza por donde duele: los diez activos que concentran la mitad del tráfico de consultas, que casi siempre son tablas grandes, feas, con historia y sin dueño claro.
Cómo se identifica el núcleo consultado
El núcleo no se decide en una reunión, se mide, y las fuentes están disponibles desde el grado 1 del marco anterior:
- Registros de consulta del motor. Qué tablas se leen, con qué frecuencia y desde cuántos usuarios. La distribución es casi siempre muy desigual: una minoría de activos concentra la mayor parte de los accesos y una larga cola no se toca desde hace meses.
- Dependencias de la capa de consumo. Qué alimenta informes con audiencia directiva o procesos operativos. Un activo de tráfico bajo que sostiene el cuadro de mando del comité pertenece al núcleo aunque se consulte una vez al mes.
- Obligaciones regulatorias. Lo que entra en un registro de tratamiento, en una auditoría sectorial o en un procedimiento de ejercicio de derechos pertenece al núcleo por definición, sea cual sea su popularidad.
- Puntos de dolor declarados. Los activos sobre los que más se pregunta al equipo de datos: la lista que mejor predice dónde una descripción ahorrará tiempo real.
La unión de esas cuatro listas suele quedarse entre el 3 % y el 10 % de los activos de una plataforma madura. Ese es el conjunto que se documenta al 100 %, se revisa con periodicidad fija y lleva propietario nombrado. El resto vive del metadato emitido —aparece en el buscador, con esquema, frescura, linaje y estadísticas de uso— y se documenta el día que alguien lo necesite, no antes.
El catálogo como producto con niveles de servicio
Tratado como proyecto, el catálogo tiene fecha de fin y a partir de ahí se degrada; tratado como producto operativo, tiene indicadores que alguien mira. Cuatro funcionan bien y se calculan solos:
| Indicador | Qué mide | Umbral de partida razonable |
|---|---|---|
| Frescura del linaje | Antigüedad máxima del último evento recibido de cada pipeline activo | Ningún pipeline diario sin evento en las últimas 48 horas |
| Cobertura útil | Proporción de consultas del trimestre sobre activos con propietario y semántica | Fijar la línea base real antes de comprometer objetivo |
| Activos del núcleo sin propietario | Huérfanos dentro del conjunto que de verdad se usa | Cero, y con nombre de persona, no de departamento |
| Tiempo de respuesta a una pregunta de impacto | Cuánto tarda alguien en saber qué se rompe si cambia una columna | Minutos desde la interfaz, no un día de análisis |
El último indicador es el que mejor resume si el catálogo sirve. Mientras la respuesta a «¿qué pasa si toco esto?» siga siendo una reunión, el grafo no está haciendo su trabajo por mucho que se vea bonito en pantalla.
Los cuatro usos que pagan la inversión
Un catálogo se justifica mal en abstracto y bien por casos de uso concretos, porque cada uno tiene un ahorro identificable y un responsable interesado en que funcione.
- Análisis de impacto antes de un cambio. Es el retorno más inmediato y el que engancha al equipo de ingeniería, que es quien tiene que alimentar el sistema. El patrón de cambios aditivos reversibles descrito al tratar las migraciones de esquema en producción funciona mucho mejor cuando se sabe de antemano quién consume cada campo.
- Auditorías y registro de actividades de tratamiento. El artículo 30 del Reglamento General de Protección de Datos obliga a mantener un registro de las actividades de tratamiento con sus categorías, finalidades y destinatarios. En la mayoría de las organizaciones se rellena a mano y refleja el diseño aprobado, no el sistema en funcionamiento; alimentado desde el linaje real describe lo que de verdad ocurre, y la diferencia entre ambos documentos suele ser el hallazgo de la inspección.
- Ejercicio de derechos. Localizar todas las copias de los datos de una persona para atender una supresión o una portabilidad es, sin linaje de columna, arqueología con final incierto; con él, es una consulta. Eso sí, sin prometer más de lo que el grafo cubre: una respuesta al interesado que ignore la hoja de cálculo departamental sigue siendo incompleta.
- Incorporación de personas y retirada de activos muertos. El primero es el beneficio que más se cita y menos se mide; el segundo, el que menos se cita y más se paga. Cruzar popularidad con linaje identifica candidatos a retirada con una confianza que ninguna revisión manual alcanza, y ahí el ahorro es de factura, no de percepción.
Ejemplo ilustrativo: trazabilidad de datos clínicos
Ejemplo compuesto a partir de patrones habituales del sector sanitario. No corresponde a ninguna organización concreta ni describe una implantación real.
Un servicio de salud con un sistema de información hospitalaria como origen, un repositorio operativo intermedio alimentado por captura de cambios y un almacén departamental para indicadores asistenciales reúne las tres condiciones que hacen del linaje algo más que una comodidad: los datos de salud son categoría especial en el artículo 9 del Reglamento General de Protección de Datos, el uso secundario para gestión e investigación convive con el asistencial, y la cadena atraviesa sistemas de proveedores distintos con ciclos de vida propios.
En un escenario así el patrón habitual es este. La clasificación de sensibilidad se declara una sola vez en el origen, a nivel de campo, y se propaga aguas abajo siguiendo el linaje de columna: cada activo derivado hereda la marca sin que nadie la reescriba, y los que la pierden por una agregación irreversible quedan identificados de forma explícita en vez de por conjetura. El registro de actividades de tratamiento deja de mantenerse como documento y se genera desde el grafo, de modo que una vía de datos nueva aparece en él por el hecho de existir. Y cuando el proveedor del sistema asistencial modifica la definición de un campo en una actualización, el análisis de impacto dice en minutos qué indicadores dependen de él, en lugar de descubrirse cuando la cifra mensual no cuadra.
La lección que deja este patrón: con datos de categoría especial, el linaje de columna deja de ser una mejora de productividad y pasa a ser el mecanismo que sostiene una afirmación regulatoria. Quien no puede reconstruir el recorrido de un campo no está en condiciones de responder por él, por completo que tenga el glosario.
Plataformas: código abierto, comerciales y catálogos de la propia plataforma
Este mercado se mueve deprisa y conviene fechar lo que se afirma. Las líneas que siguen reflejan la situación a septiembre de 2026.
Código abierto
DataHub, nacido en LinkedIn y liberado en 2020 bajo licencia Apache 2.0, es hoy la opción de código abierto con más tracción: modelo de metadatos extensible, ingesta por conectores, comunidad activa y una empresa detrás que ofrece la versión gestionada. OpenMetadata, también Apache 2.0 y respaldada por Collate, ha ido en la misma dirección y en su versión 2.0 se presenta como capa de contexto para datos e inteligencia artificial más que como catálogo clásico; su modelo unificado y su instalación sencilla la hacen una primera opción razonable para empezar sin negociación comercial. Marquez ocupa otro lugar: implementación de referencia de OpenLineage, es especialmente útil para validar la emisión antes de decidir dónde consolidarla.
Y luego está Amundsen, con el que abre este capítulo. Archivado por inactividad en septiembre de 2026, sigue disponible con fines históricos bajo Apache 2.0 en la LF AI & Data Foundation. Sirve de recordatorio: en código abierto, la licencia permisiva garantiza el derecho a seguir usando el software, no la existencia de alguien que lo mantenga. En una decisión de plataforma, la salud del proyecto —cadencia de publicaciones, diversidad de quienes contribuyen, respuesta a los avisos de seguridad— pesa tanto como la lista de características.
Comerciales
El segmento comercial es donde está la mayor parte del gasto y también donde se han producido los movimientos recientes. Informatica, que encabeza el ranking de plataformas de gobernanza del dato del directorio de Dataprix, es desde noviembre de 2025 propiedad de Salesforce, que cerró la operación por unos 8.000 millones de dólares. Le siguen en esa clasificación IBM con su catálogo de conocimiento, Atlan, Alation, OvalEdge, Collibra y Collate —la empresa detrás de OpenMetadata, presente aquí con su oferta gestionada—, además de data.world, Precisely y Alex Solutions. El ranking recoge el veredicto editorial de cada opción y sirve como punto de partida para una lista corta.
Lo que se compra en este segmento no es la capacidad de dibujar un grafo, que hoy tienen todos, sino tres cosas menos vistosas: la amplitud de conectores mantenidos por el proveedor —donde se va el tiempo de un despliegue—, las funciones de gobierno que acompañan al catálogo (glosario, flujos de aprobación, políticas, informes de cumplimiento) y el soporte cuando algo no ingesta. Quien no vaya a usar la segunda está pagando una suite para usar un buscador.
Catálogos de la propia plataforma
La tercera vía es no comprar nada y usar lo que ya viene con el almacén o la nube. Unity Catalog, de Databricks, liberado como código abierto en 2024, cubre catálogo, permisos y linaje dentro de su ecosistema. Microsoft Purview ha reorganizado su oferta alrededor del Unified Catalog, que sustituye al catálogo clásico y arrastra consigo la integración con el resto del entorno de Microsoft. Y en Google Cloud, lo que durante un tiempo se llamó Dataplex y después Dataplex Universal Catalog pasó a denominarse Knowledge Catalog el 10 de abril de 2026, manteniendo sin cambios los nombres de la interfaz de programación y de los permisos.
La ventaja es evidente —integración nativa, linaje sin instrumentar, coste marginal bajo— y la limitación también: el grafo termina donde termina la plataforma. Para una organización con un único ecosistema dominante suele ser la decisión correcta, y muchos proyectos de catálogo empresarial se habrían ahorrado si alguien hubiera hecho antes esa pregunta. Para una arquitectura repartida entre varios proveedores, un catálogo de plataforma es buen emisor, pero mal consolidador.
Criterios de selección
| Criterio | Qué comprobar | Señal de alarma |
|---|---|---|
| Conectores reales al stack propio | Que exista conector mantenido para cada motor, orquestador y herramienta de BI en uso, con soporte de linaje y no solo de inventario | «Está en la hoja de ruta» para la pieza que concentra la mitad de los datos |
| Soporte de OpenLineage | Que ingiera eventos del estándar, tanto para cubrir lo que no tiene conector como para poder cambiar de catálogo sin reinstrumentar | Formato de linaje propietario sin ruta de importación ni exportación |
| Linaje de columna | En qué motores y dialectos lo resuelve de verdad, y qué pasa con procedimientos almacenados y SQL dinámico | Demostración hecha siempre sobre el mismo ejemplo sencillo |
| Orientación a interfaz de programación | Que todo lo que se hace por pantalla se pueda automatizar: altas, propagaciones y expedientes | Funciones disponibles solo desde la interfaz gráfica |
| Coste total y salud del proveedor | Licencia, cómputo de escaneo, mantenimiento de conectores y tiempo del equipo que lo alimenta; más cadencia de publicaciones, comunidad y movimientos societarios recientes | Comparar solo precio de licencia; proyecto sin publicaciones en varios trimestres o producto absorbido sin hoja de ruta pública |
El anti-patrón más caro de esta categoría es comprar el catálogo antes de instrumentar los pipelines. Una plataforma de gobierno desplegada sobre una arquitectura que no emite nada solo puede ofrecer lo que consiga escanear —inventario y poco más—, y el resto del valor prometido queda pendiente de una instrumentación que nadie presupuestó. El resultado típico es una licencia anual de cinco o seis cifras sosteniendo un buscador de tablas, y una organización convencida de que los catálogos no funcionan. El orden correcto es el inverso: emitir linaje primero con utillaje ligero, comprobar qué preguntas se pueden responder ya y comprar después, con una lista de requisitos escrita desde la experiencia y no desde el folleto.
Anti-patrones del catálogo y el linaje
- El catálogo cementerio. Se cargó una vez, en el arranque del proyecto, y ahí sigue. El síntoma temprano aparece en la fecha del último escaneo, anterior al trimestre pasado, mucho antes que en las casillas vacías. Lección: si el catálogo no tiene un indicador de frescura visible, ya está muriéndose y nadie lo sabe.
- Documentar el 100 % en lugar del núcleo. La campaña de cobertura total consume el presupuesto de atención del año y produce descripciones sin información. Lección: la cobertura que importa se mide sobre las consultas, no sobre los activos.
- Linaje sin responsable. Un grafo precioso en el que nadie corrige los nodos mal resueltos ni cubre las zonas ciegas. Al cabo de unos meses, quien lo consulta aprende a desconfiar y deja de consultarlo. Lección: el grafo necesita dueño operativo igual que un pipeline.
- Ignorar la capa de consumo. El grafo termina en la última tabla del almacén y deja fuera informes, extracciones y modelos semánticos. Lección: el impacto de un cambio se mide en lo que ve el negocio, no en lo que ve el equipo de datos.
- Confundir glosario con catálogo. Un vocabulario de negocio aprobado en comité, sin vínculo con ningún activo real, es un documento de consenso, no un inventario. Lección: un término de glosario que no está enlazado a columnas concretas no cambia ninguna decisión.
- Catalogar lo que debería retirarse. Documentar activos que llevan trimestres sin consultarse en vez de proponer su retirada. Lección: el catálogo es también la herramienta que justifica apagar cosas; usarlo solo para acumular desaprovecha la mitad de su valor.
Checklist operativo
- Medir la distribución real de consultas del último trimestre y publicar qué activos concentran la mayor parte del tráfico.
- Definir el núcleo consultado como unión de cuatro listas: lo más consultado, lo que alimenta informes de dirección, lo que tiene obligación regulatoria y aquello sobre lo que más se pregunta.
- Instrumentar la emisión de linaje en el orquestador antes que en ninguna otra capa, y comprobar que llega un evento por cada ejecución.
- Añadir la emisión desde el motor de transformación aprovechando sus artefactos de compilación, sin escribir el grafo a mano.
- Conectar la capa de consumo —informes, cuadros de mando y extracciones— y asumir que el grafo no vale hasta que llega allí.
- Activar linaje de columna solo en los dominios con datos personales, obligación regulatoria o indicadores de dirección.
- Marcar las zonas ciegas en el propio grafo, con nodos de «entrada no instrumentada», en lugar de dejar huecos silenciosos.
- Asignar propietario con nombre y apellidos a cada activo del núcleo, y dejar el resto sin propietario de forma consciente.
- Mover la escritura de semántica al repositorio, junto a la definición del modelo, y publicarla al desplegar; prohibir la publicación de descripciones generadas sin revisión de una persona identificable.
- Propagar las clasificaciones de sensibilidad por el linaje de columna y revisar los puntos donde una transformación cambia el significado.
- Exponer el análisis de impacto en la revisión de código, para que el productor reciba algo a cambio de alimentar el sistema.
- Publicar los cuatro indicadores del catálogo con la misma visibilidad que los de la plataforma, y generar desde el grafo el registro de actividades de tratamiento para contrastarlo con la versión documental vigente.
- Revisar trimestralmente los activos sin consultas y proponer retirada, no documentación.
- Comprobar, antes de comprar, qué preguntas responde ya el utillaje ligero que se puede desplegar en una semana.
Formación recomendada
Dos itinerarios cortos en español que cubren, respectivamente, el terreno específico de este capítulo y el marco de gobierno en el que encaja:
- Data Governance: Domina Metadatos, Catálogo y Diccionario (Udemy, en español, unas dos horas). Es el curso más alineado con este capítulo: tipologías de metadato, diccionario de datos, glosario, catálogo y trazabilidad, con repaso de las herramientas de gobierno más extendidas.
- Conceptos de Data Governance (DataCamp, en español, dos horas, nivel básico). Marco de gobierno, roles y modelo operativo: el contexto organizativo que este capítulo deja deliberadamente para la Parte VI.
Recursos y lecturas recomendadas
- Documentación de OpenLineage — la especificación, el modelo de facetas y el catálogo de integraciones disponibles. Punto de partida obligado antes de elegir plataforma.
- Marquez — implementación de referencia de OpenLineage; el camino más corto para ver un grafo real emitido por los propios pipelines.
- DataHub y OpenMetadata — las dos plataformas de código abierto con más actividad; ambas bajo licencia Apache 2.0.
- Reglamento General de Protección de Datos — artículos 9 (categorías especiales), 17 (supresión) y 30 (registro de actividades de tratamiento), que son los que convierten el linaje en una obligación y no en una comodidad.
- Joe Reis y Matt Housley, Fundamentals of Data Engineering (O'Reilly) — el capítulo sobre gestión de datos sitúa bien el papel del metadato dentro del ciclo de vida de la ingeniería de datos.
- DAMA International, DAMA-DMBOK: Data Management Body of Knowledge — la referencia de vocabulario para las áreas de gobierno, metadatos y calidad; útil para alinear términos antes de una discusión de comité.
- TOP 10 plataformas de gobernanza del dato y TOP 10 herramientas de integración de datos del directorio de Dataprix, con las fichas de cada opción.
Preguntas frecuentes
¿Qué diferencia hay entre un catálogo de datos y el linaje de datos?
El catálogo es el inventario consultable de los activos de datos de una organización: qué existe, dónde está, qué significa, quién responde de ello y en qué condiciones se puede usar. El linaje es una de las informaciones que contiene, y describe el origen y el recorrido de cada activo: qué leyó y qué escribió cada ejecución, y qué transformaciones median. El catálogo responde a «qué hay»; el linaje, a «de dónde viene y quién depende de ello». Un catálogo sin linaje es una lista; el linaje sin catálogo es un grafo que nadie sabe interpretar.
¿Se puede automatizar el catálogo de datos por completo?
No, y conviene planificar sabiéndolo. La parte derivable del metadato —esquemas, volumetrías, frescura, popularidad y linaje— se automatiza por completo y debe automatizarse siempre, porque se regenera con cada ejecución sin coste marginal. La parte atribuible —significado, propósito, criticidad y responsabilidad— exige que alguien que sabe algo lo escriba, y ninguna herramienta puede deducirla del funcionamiento de los sistemas porque no está contenida en él. La automatización no elimina el trabajo humano: lo concentra en un conjunto de activos mucho menor de lo que suele plantearse al arrancar.
¿Qué es OpenLineage y por qué importa elegir un estándar de emisión?
OpenLineage es una especificación abierta para recoger metadatos de linaje, graduada en la LF AI & Data Foundation, que define un modelo común de eventos de ejecución con sus entradas, sus salidas y facetas extensibles. Importa por dos razones prácticas: el coste, porque integrar cada motor se hace una vez y lo aprovechan todos los consumidores en vez de reimplementarse por cada catálogo; y la reversibilidad, porque si la emisión sigue un estándar, cambiar de plataforma no obliga a reinstrumentar la arquitectura, que es donde se concentra el esfuerzo de estos proyectos.
¿Linaje a nivel de tabla o a nivel de columna?
Ambos, pero no en el mismo alcance. El linaje de tabla es barato, basta para orientarse y conviene tenerlo en toda la plataforma. El de columna cuesta bastante más —exige analizar las transformaciones con precisión y multiplica el tamaño del grafo— y es el único que permite un análisis de impacto preciso y el seguimiento de datos sensibles, porque la sensibilidad y el riesgo regulatorio residen en campos concretos, no en tablas enteras. La pauta razonable es activarlo solo en los dominios con datos personales, obligaciones regulatorias o indicadores que llegan a dirección.
¿Cuánto hay que documentar para que el catálogo sea útil?
Mucho menos de lo que se suele exigir, y mucho mejor. La métrica que orienta bien no es la cobertura nominal —qué proporción de activos tiene el campo descripción relleno— sino la cobertura útil: qué proporción de las consultas realmente ejecutadas aterriza sobre activos con propietario identificado, semántica escrita y linaje al día. En una plataforma madura, el conjunto que concentra la mayor parte del uso, alimenta informes de dirección o tiene obligación regulatoria suele quedarse por debajo del diez por ciento del total. Ese conjunto se documenta al cien por cien; el resto vive del metadato emitido.
¿Conviene un catálogo de código abierto, uno comercial o el de la propia plataforma?
Depende de cuántos ecosistemas haya que abarcar y de qué funciones de gobierno se vayan a usar de verdad. Si la arquitectura vive básicamente dentro de un proveedor, el catálogo nativo de esa plataforma suele ser la decisión más económica y la mejor integrada. Si hay varios ecosistemas y el equipo puede operar una pieza más, las opciones de código abierto con licencia permisiva cubren inventario, linaje y descubrimiento sin negociación comercial, valorando la salud del proyecto además de sus características. Las comerciales se justifican cuando se van a usar las funciones de gobierno que acompañan al catálogo —glosario, políticas, flujos de aprobación, informes de cumplimiento— y cuando los conectores mantenidos por el proveedor ahorran más tiempo del que cuesta la licencia. En los tres casos rige la misma regla: instrumentar antes de comprar.
De la trazabilidad técnica a la responsabilidad organizativa
Este capítulo se ha mantenido deliberadamente en el plano técnico: cómo se emite el linaje, cómo se consolida, qué parte del inventario se automatiza y cuál no. Lo que eso no resuelve es la pregunta que aparece en cuanto el grafo funciona. El catálogo puede decir que una columna llega hasta el cuadro de mando de dirección, pero no decide quién responde si esa columna se equivoca, ni quién autoriza un uso nuevo, ni qué ocurre cuando dos departamentos definen el mismo indicador de forma distinta y ambos tienen razones. Esa conversación —propiedad del dato, administración delegada, políticas y cumplimiento— es el contenido de la Parte VI de esta guía, dedicada a la gobernanza, el cumplimiento y la organización, y llega con mucha mejor base cuando la trazabilidad ya está automatizada: discutir responsabilidades con un grafo delante es otra reunión muy distinta de hacerlo con un diagrama dibujado a mano.
Antes de eso, la Parte III se cierra poniendo a trabajar todo lo visto desde los fundamentos de la integración de datos. El capítulo siguiente narra un caso aplicado de migración de un ETL corporativo a un enfoque ELT en una cadena de retail: el inventario y la clasificación de flujos como paso que decide el resultado, la operación dual entre el sistema antiguo y el nuevo y los criterios para apagar lo viejo sin sobresaltos. Quien llegue hasta allí con el linaje emitiéndose reconocerá algo: el paso más difícil de una migración es saber qué se está migrando, y esa es exactamente la pregunta que un catálogo vivo responde sin convocar una sola reunión.
Siguiente en la Parte III: capítulo 28, Caso aplicado: migración de ETL a ELT en una cadena de retail. · Volver a la Parte III · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 21 de septiembre de 2026.
