Testing de pipelines y datos: qué probar, cuándo y qué no merece la pena

 Capítulo 25 de la Guía práctica para diseñar y operar la arquitectura de datos de tu empresa. Llevamos varios capítulos construyendo piezas: pipelines de ingesta resilientes, flujos CDC casi en tiempo real y controles de calidad que vigilan cada carga.
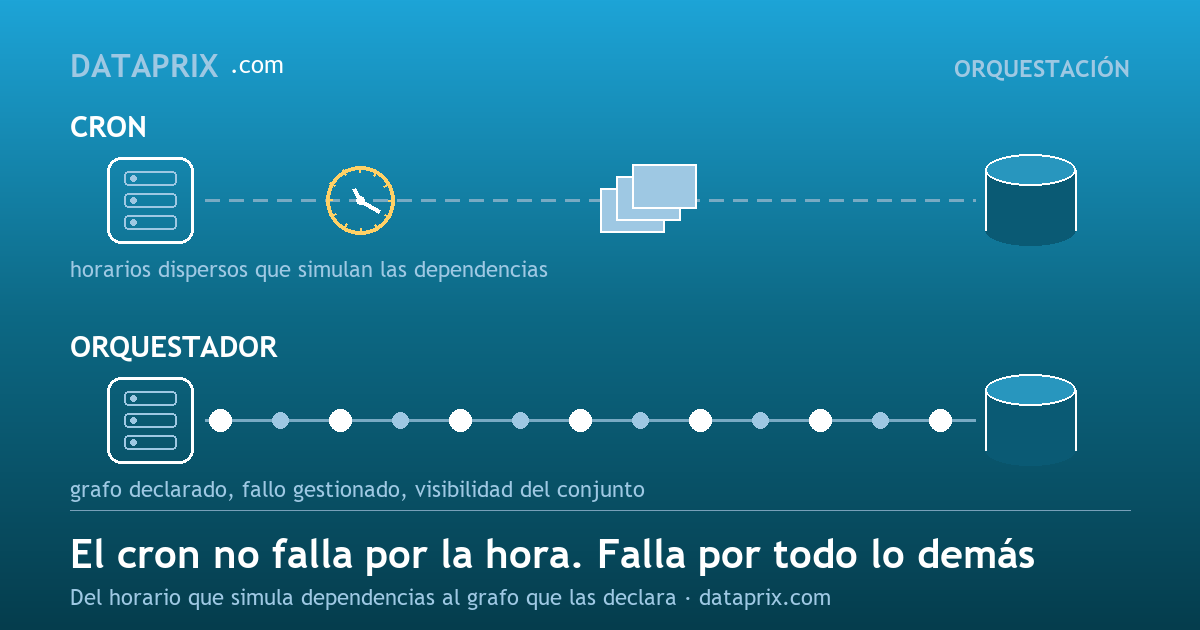
Este capítulo responde a la pregunta que las une todas: ¿quién dirige la orquesta? Hablamos de orquestación de pipelines: DAGs, dependencias, políticas de reintento y alertas..


El Change Data Capture (CDC) es la técnica que detecta y propaga los cambios de una base de datos (inserciones, actualizaciones y borrados) a otros sistemas casi en tiempo real. La aproximación log-based —leer el registro de transacciones de la base de datos— es hoy el estándar de facto porque no impacta en el rendimiento del sistema origen, mientras que las variantes trigger-based y query-based quedan relegadas a casos residuales. Debezium, la plataforma open source (Apache 2.0) del ecosistema Kafka, es la referencia del mercado, con su versión estable 3.5.2 publicada en junio de 2026..
Casi ninguna empresa decide de un día para otro que necesita ayuda con sus datos. El proceso es más lento: los informes empiezan a tardar, cada departamento trae «su» cifra a la reunión, y las decisiones importantes se acaban tomando por intuición porque nadie se fía del todo de los números. Cuando eso se vuelve la norma, el Business Intelligence de la empresa se ha quedado corto —aunque nadie lo haya dicho en voz alta.


 El ELT —cargar primero el dato en crudo y transformarlo después, dentro del propio motor de destino— se ha vendido como una característica del cloud, pero es un patrón arquitectónico, no una función de Snowflake o BigQuery. Se puede hacer —y se hace— on-premise, sobre SQL Server, Oracle o PostgreSQL, y para muchas empresas con datos sensibles o restricciones de coste es una opción perfectamente válida.
Aquí explico qué es, por qué lo confundimos con la nube, cómo se implementa on-premise y cuándo conviene..
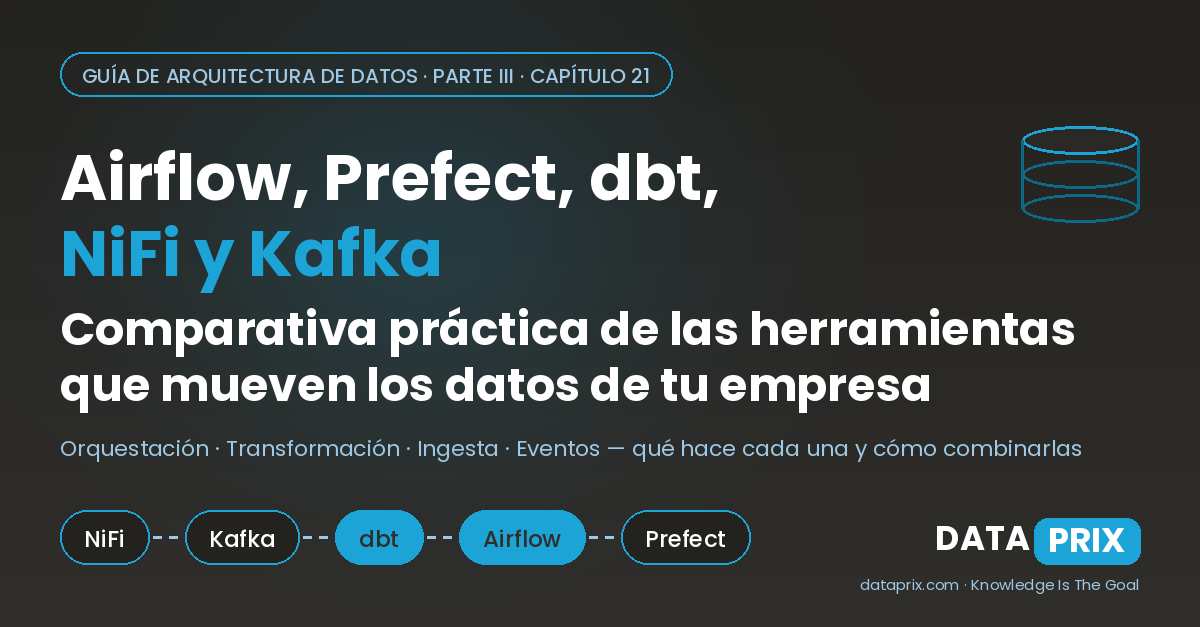 Airflow, Prefect, dbt, NiFi y Kafka son un ejemplo de stack de integración —el del modern data stack open-source, código primero— que este capítulo usa como hilo conductor para entender los cuatro planos de un pipeline: quién orquesta (Airflow, Prefect), quién transforma (dbt), quién mueve los datos (NiFi) y sobre qué viajan los eventos en tiempo real (Kafka).
No son "las mejores" herramientas ni la única vía válida. El mercado ofrece desde plataformas comerciales integradas —Informatica, Azure Data Factory, AWS Glue, Talend y el resto del TOP 10 de Dataprix— hasta decenas de alternativas open-source por cada capa.
La pregunta correcta no es "¿qué cinco herramientas elijo?", sino entender los planos, elegir un arquetipo coherente con tu equipo y tu caso, y no usar una herramienta excelente para el trabajo equivocado..


Las herramientas ETL son el pilar fundamental de cualquier estrategia de datos moderna. En un mundo donde se generan 463 exabytes de datos diariamente, elegir la herramienta ETL correcta puede marcar la diferencia entre insights accionables y un caos de datos dispersos.
En esta guía comparamos las mejores herramientas ETL de 2026, analizamos sus características, precios y te ayudamos a elegir la más adecuada para tu proyecto de Data Warehouse o Big Data..
 Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 | Presentacion | Aviso legal