
Capítulo 29 · Parte IV: Business Intelligence y consumo · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
Con este capítulo arranca la Parte IV de la guía. Las tres partes anteriores dejaron el dato almacenado, integrado, probado y trazado; a partir de aquí la pregunta cambia de sitio: quién lo consume, para qué decisión y quién responde de que esa decisión mejore. La respuesta empieza por la estrategia de Business Intelligence y por una distinción que muchas organizaciones todavía no han hecho: la que separa un informe de un producto de datos.
TL;DR. La mayoría de organizaciones no sufre un problema de herramientas de BI, sino de modelo operativo: fabrica informes como artefactos puntuales que se entregan y se olvidan, cuando lo que necesita es operar productos de datos con dueño nombrado, usuarios y decisiones identificados, un SLO de frescura, métricas de adopción propias y un ciclo de vida que incluye la retirada. Para situarse sirve la escalera informe→producto —informe bajo demanda, dashboard gobernado, autoservicio sobre datasets certificados y producto de datos—, y la madurez real la marca el peldaño donde opera el 80 % del consumo, que casi nunca coincide con el más alto que se ha tocado alguna vez. El salto es organizativo antes que tecnológico, y es lo que separa el BI que se usa del BI que se archiva.
Una de cada cuatro: la cifra de adopción que el BI no consigue mover
En la primavera de 2022, la firma de análisis BARC y Eckerson Group publicaron un estudio dedicado en exclusiva a la adopción de BI y analítica, basado en una encuesta a 214 responsables de datos y analítica realizada a finales de 2021. Su primer hallazgo era una cifra modesta: de media, solo el 25 % de los empleados usaba de forma activa las herramientas de BI de su organización, y los autores advertían de que el indicador apenas había crecido en los siete años que llevaban midiéndolo (BARC, 2022). Las series anuales de la propia BARC, construidas con otra metodología, cuentan una historia parecida desde mucho antes: la mediana de usuarios de BI en las empresas que participaban en su encuesta anual pasó del 10 % en 2014 al 13 % en 2018 (BARC, The BI Survey 18, octubre de 2018). Dos décadas de herramientas cada vez más amables, y la proporción de personas que las maneja se mueve a paso de glaciar.
Lo más interesante del estudio está en la otra mitad. Casi todos los encuestados (el 92 %) afirmaban que el uso de los resultados analíticos había crecido en los cinco años anteriores, y la mitad decía que había crecido mucho. Los autores separaban con cuidado dos conceptos que en los comités suelen mezclarse: la adopción, entendida como personas que manejan activamente las herramientas, y el uso, que incluye a quien consume gráficos, tablas y cuadros de mando sin licencia porque le llegan incrustados en una aplicación operativa o en un portal externo. El crecimiento venía precisamente de ahí: de trabajadores de primera línea y de clientes o proveedores que recibían la analítica en el sitio donde ya trabajaban.
Leídas juntas, las dos cifras desmontan el diagnóstico que más se repite cuando un proyecto de BI decepciona: que la gente no lo usa porque las herramientas son difíciles o porque falta formación. Las herramientas son hoy mucho más sencillas que hace una década, y la adopción apenas se ha movido; mientras tanto, el consumo crece justo donde alguien ha diseñado la entrega pensando en una persona concreta, una decisión concreta y un momento concreto. Dicho de otro modo, crece donde alguien ha pensado la analítica como se piensa un producto. Esa es la tesis de este capítulo: el salto del informe al producto de datos es, antes que nada, un cambio de modelo operativo, y ninguna licencia nueva lo hace por sí sola.
La Parte IV recorre ese camino en ocho capítulos. Tras este, dedicado a la estrategia, llegan la capa semántica que garantiza que una métrica signifique lo mismo en todas partes, la selección de herramientas según el tipo de consumidor, el diseño y el rendimiento de los dashboards, el autoservicio con límites, la monetización de datos mediante APIs, la analítica embebida dentro del producto y, como cierre, la construcción de un centro de control ejecutivo. Todos comparten un punto de partida que conviene fijar ya: el valor de una arquitectura de datos se mide en decisiones mejoradas; los terabytes almacenados y los informes publicados son, como mucho, indicadores de esfuerzo.
Informe y producto de datos: vocabulario para hablar con el comité
Buena parte de la confusión en torno a la estrategia de BI es terminológica. Se usa «informe», «dashboard», «cuadro de mando» y «producto» como sinónimos, y con eso se pierde la distinción que importa, que depende de lo que ocurre después de la entrega y apenas del formato del entregable. Estas son las definiciones que usa el resto de la Parte IV.
Un informe, en el sentido de este capítulo, es un entregable analítico producido para atender una petición concreta, que se entrega y se da por terminado: nadie responde de su vigencia, de su exactitud o de su utilidad una vez que ha salido por la puerta. Puede ser un PDF mensual, una hoja de cálculo o un dashboard interactivo; el formato es indiferente.
Un producto de datos es un activo analítico —un dataset certificado, un cuadro de mando, un modelo o una API— que se opera de forma continuada, con un dueño identificado, usuarios y decisiones definidos, niveles de servicio explícitos, métricas de adopción y un ciclo de vida que incluye su retirada. La expresión tiene historia: DJ Patil la popularizó en 2012 como un producto que facilita un objetivo mediante el uso de datos, y Zhamak Dehghani la convirtió una década después en el primer principio de data mesh, donde el producto de datos debe reunir ocho atributos de usabilidad, como ser descubrible, comprensible o fiable. El sentido que se usa aquí es algo más amplio y más cercano al consumo —en data mesh el producto típico es el dataset que un dominio sirve a otros; en BI también lo es la superficie donde alguien decide—, pero ambos comparten el rasgo decisivo: alguien responde del activo después de entregarlo.
El data product owner es la persona que responde del valor de un producto de datos. Habitualmente pertenece al negocio y no a IT, decide qué entra en su hoja de ruta, a quién sirve, qué nivel de servicio necesita y cuándo se retira. Su trabajo es priorizar y defender el producto; la construcción corresponde al equipo técnico.
El time-to-insight es el tiempo que transcurre entre que surge una pregunta de negocio y que quien debe decidir dispone de una respuesta fiable. El capítulo 6 lo presentaba como métrica de éxito de la plataforma; en BI es la medida más aproximada de cuánto cuesta preguntar.
La adopción analítica es la proporción del público objetivo de un producto que lo usa de forma recurrente para decidir, medida sobre usuarios activos reales y no sobre licencias asignadas. Y un informe zombi es el que sigue refrescándose, consumiendo capacidad y apareciendo en los menús sin que nadie lo abra ni lo use para decidir: el residuo natural de un modelo que sabe crear pero no sabe retirar.
| Dimensión | Informe | Producto de datos |
|---|---|---|
| Unidad de trabajo | Una petición | Una decisión recurrente y sus usuarios |
| Quién responde después de la entrega | Nadie en particular | Un dueño con nombre y apellidos |
| Cuándo termina | Al entregarse | Al retirarse, por decisión explícita |
| Cómo se mide el éxito | Entregado en plazo | Usuarios activos, decisiones soportadas, nivel de servicio cumplido |
| Frescura | La que salga | Pactada y vigilada (SLO) |
| Financiación | Proyecto, con fecha de fin | Construcción más operación, revisada en cartera |
| Qué pasa cuando deja de usarse | Nada: se convierte en zombi | Se detecta, se anuncia y se apaga |
Síntomas de una fábrica de informes
Ninguna organización decide montar una fábrica de informes. Llega a ella por acumulación, una petición razonable detrás de otra, y la reconoce tarde porque cada síntoma, aislado, parece un problema distinto con su propia solución. Conviene verlos juntos.
El primero es el backlog eterno. La cola de peticiones al equipo de BI crece más deprisa de lo que se vacía, los plazos de entrega se miden en semanas o meses, y la prioridad la marca quien más presiona o quien tiene más cargo. El equipo de BI, que debería ser un aliado del negocio, se convierte en un mostrador al que se acude con resignación, y sus mejores analistas dedican la jornada a reproducir variantes de lo que ya existe con otro filtro.
El segundo es la proliferación. Un inventario de la plataforma de BI suele arrojar cientos o miles de objetos publicados, muchos casi idénticos: el informe de ventas por zona, el de ventas por zona con devoluciones, el de ventas por zona para el comité, la copia que alguien hizo para no tocar el original. Cuando se cruza ese inventario con los registros de uso del último trimestre, es habitual descubrir que una parte importante no se ha abierto ni una vez. Nadie los retira porque apagar algo que funciona no tiene patrocinador, y así la plataforma acumula coste de refresco, de capacidad y de confusión.
El tercero es el shadow analytics: la analítica que vive fuera de la plataforma oficial. Hojas de cálculo exportadas que se enriquecen a mano, se cruzan con ficheros de otros sistemas y circulan por correo; cuadros de mando paralelos montados por un departamento con una licencia propia; la célebre «hoja de verdad» del controller que todo el mundo consulta antes de creerse el dashboard. Conviene leer el shadow analytics como la respuesta racional a un backlog que no llega: si la vía oficial tarda tres meses, la gente construye la suya en una tarde.
El cuarto, y el más corrosivo, es la misma métrica calculada en doce sitios. El margen, la venta neta, el cliente activo o la ocupación aparecen en informes distintos con fórmulas ligeramente diferentes, y las reuniones de dirección empiezan dedicando media hora a conciliar cifras en lugar de decidir. El caso de Vandelar en el capítulo 28 lo ilustraba con la venta neta, que tres paquetes calculaban de tres maneras; el capítulo 30 se dedica entero a resolverlo en la capa semántica.
Los cuatro síntomas tienen la misma raíz: cada petición termina con la entrega. Mientras el trabajo del equipo de BI se defina como «producir lo que se pide» y su éxito se cuente en entregables, el sistema generará más informes, más copias y más cifras divergentes, por mucho que se cambie de herramienta.
La escalera informe→producto: dónde opera de verdad el consumo
Para salir de la fábrica sirve un marco sencillo con cuatro peldaños. Describe maneras de entregar y operar la analítica, con independencia de la herramienta, y cada peldaño exige capacidades que el anterior no necesitaba.
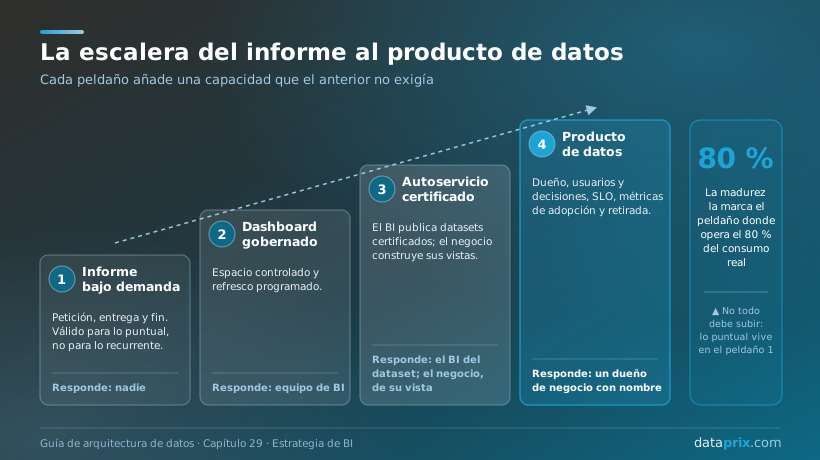
El peldaño 1, informe bajo demanda, es el punto de partida de casi todo el mundo: alguien pide, alguien construye, alguien entrega. Es el modelo correcto para preguntas que se hacen una vez —un análisis para una negociación, una respuesta a un requerimiento puntual— y el incorrecto para cualquier cosa que se vaya a preguntar cada semana. Tener informes bajo demanda es sano; el problema aparece cuando lo recurrente vive aquí.
El peldaño 2, dashboard gobernado, añade recurrencia y control: el contenido se publica en un espacio controlado, se refresca de forma programada, su origen de datos está documentado y alguien del equipo de BI lo mantiene. Es un avance real sobre el peldaño anterior, pero conserva un rasgo del modelo-informe: el dueño sigue siendo el equipo que lo construyó, y su éxito sigue midiéndose en publicaciones.
El peldaño 3, autoservicio sobre datasets certificados, cambia el reparto del trabajo. El equipo de BI deja de producir cada vista y pasa a publicar datasets certificados y modelos semánticos con definiciones únicas; el negocio construye encima sus propios análisis. Es el peldaño que más acelera el time-to-insight y el que más se estropea cuando se salta el anterior: abrir el autoservicio sin contenidos gobernados ni definiciones únicas es la vía más rápida hacia la proliferación de versiones de la verdad.
El peldaño 4, producto de datos, es el que incorpora todo lo que define a un producto: dueño de negocio, usuarios y decisiones identificados, niveles de servicio, métricas de adopción, hoja de ruta y retirada. Un producto puede ser un cuadro de mando, un dataset certificado que alimenta a otros, un modelo o una API; lo que lo hace producto es cómo se opera.
La regla que da utilidad al marco es esta: la madurez de una organización la marca el peldaño donde opera el 80 % de su consumo real; el peldaño más alto que haya tocado alguna vez es una anécdota. Es frecuente encontrar un piloto de peldaño 4 en la presentación al comité mientras la inmensa mayoría de las consultas reales fluye por exportaciones a hoja de cálculo que viven en el peldaño 1. Medirlo es más fácil de lo que parece: las plataformas de BI registran visualizaciones y sesiones por contenido y por usuario, y basta con clasificar cada activo consumido en el último trimestre según su peldaño y repartir el consumo entre ellos. El resultado suele ser incómodo y casi siempre útil.
| Peldaño | Quién construye | Quién responde | Señal de que se está ahí | Riesgo de saltárselo |
|---|---|---|---|---|
| 1. Informe bajo demanda | Equipo de BI, a petición | Nadie tras la entrega | El backlog se mide en semanas | — |
| 2. Dashboard gobernado | Equipo de BI | Equipo de BI | Contenido publicado en espacios controlados, con refresco programado | Autoservicio sin contenido de referencia con el que contrastar |
| 3. Autoservicio sobre datasets certificados | Negocio, sobre datos del equipo de BI | El equipo de BI, del dataset; el negocio, de su vista | Hay sello de certificación y la mayoría de análisis parte de él | Productos sin una definición común de las métricas |
| 4. Producto de datos | Equipo mixto | Un dueño de negocio | Cada producto tiene dueño, SLO y métricas de uso visibles | Productos de escaparate sobre una base que no es fiable |
Dos matices evitan malinterpretar la escalera. El primero, no todo debe subir: un análisis puntual vivirá siempre en el peldaño 1 y está bien que así sea; la estrategia consiste en decidir qué activos merecen convertirse en producto, y casi nunca son la mayoría. El segundo, los peldaños no se saltan sin coste: cada uno se apoya en la capacidad que construyó el anterior, y las organizaciones que intentan pasar del 1 al 4 de un salto acaban con productos impecables en la forma y apoyados en definiciones que nadie ha acordado.
Criterio de decisión. Un activo analítico merece convertirse en producto de datos cuando cumple tres condiciones a la vez: sostiene una decisión recurrente, tiene más de un consumidor y un error en él tendría consecuencias medibles. Si falta alguna, el peldaño 1 o 2 es el sitio correcto, y forzarlo a producto solo añade coste de operación. La cartera de productos de una organización mediana suele ser mucho más corta que su lista de informes, y esa diferencia es exactamente el margen de ahorro.
Los cinco atributos que convierten un dashboard en producto
Un dashboard se convierte en producto cuando reúne cinco atributos verificables, y cualquiera de ellos que falte devuelve el activo al modelo-informe; el nombre que reciba en la presentación es irrelevante.
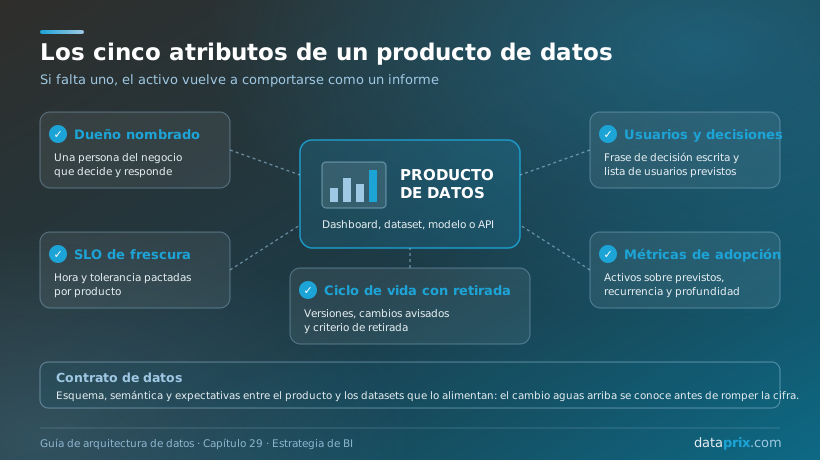
Dueño nombrado. Una persona con nombre y apellidos —un departamento o «el equipo de BI» no cuentan— que responde del valor del producto, decide su hoja de ruta y aprueba los cambios de definición. Lo habitual y lo deseable es que pertenezca al negocio que toma la decisión; IT construye y opera, pero el dueño es quien sufre si el producto no sirve. Un producto con dos dueños tiene, en la práctica, ninguno.
Usuarios y decisiones identificados. Cada producto debe poder describirse con una frase del tipo «la jefa de planta decide cada lunes la asignación de turnos con este producto». Si esa frase no se puede escribir, el activo no tiene una decisión que sostener y probablemente no merece la operación de un producto. La lista de usuarios previstos, además, es el denominador sin el que no se puede medir la adopción.
SLO de frescura y disponibilidad. Cada producto pacta con su dueño cuándo deben estar los datos y con qué tolerancia: «actualizado antes de las 7:30 en días laborables», por ejemplo. El nivel de servicio se vigila con los mismos mecanismos que el capítulo 24 describía para la calidad en el pipeline, y se expresa con la disciplina de SLO y SLI que el capítulo 5 aplicaba a la plataforma. El matiz que más dinero ahorra es que no todo necesita ser diario: pactar la frescura por producto, y no por plataforma, evita pagar cargas horarias para decisiones que se toman una vez al mes.
Métricas de adopción propias. Usuarios activos frente a usuarios previstos, recurrencia, profundidad de uso. Se recogen de forma automática a partir de la telemetría de la plataforma de BI y se revisan con el dueño. Un producto sin métricas de uso es un producto del que nadie sabe si sirve, y por tanto un candidato a zombi.
Ciclo de vida con retirada. El producto tiene versiones, los cambios de definición se comunican antes de aplicarse y existe un criterio escrito para retirarlo. Es el atributo que más se omite y el que más diferencia a un producto de un informe con buena presentación.
Por debajo de los cinco atributos visibles hay una contrapartida técnica: el contrato de datos entre el producto y los datasets que lo alimentan. El capítulo 26 lo trataba como test ejecutable entre productores y consumidores; aquí es lo que permite que el dueño de un cuadro de mando sepa de antemano que un cambio aguas arriba va a afectar a su producto, en lugar de descubrirlo cuando la cifra deja de cuadrar.
La experiencia de usuario también es una decisión de arquitectura
El estudio de BARC señalaba que el consumo crece donde la analítica llega al lugar de trabajo del usuario. Esa observación tiene consecuencias de diseño que conviene incorporar a la estrategia desde el principio, porque varias de ellas no se arreglan después con un rediseño visual.
La primera es el punto de entrada único. Un usuario que tiene que recordar en qué espacio de trabajo, en qué carpeta o en qué herramienta vive cada cuadro de mando acaba preguntando por correo, y la pregunta por correo es el origen del shadow analytics. Un portal o catálogo de productos con buscador, descripción y sello de certificación visible reduce esa fricción más que cualquier mejora gráfica. La segunda es la confianza visible: la fecha y hora del último refresco en pantalla, la definición de cada métrica a un clic y el nombre del dueño a la vista. Un dato del que no se sabe cuándo se actualizó se contrasta con otro, y la reunión vuelve a empezar por la conciliación.
La tercera es el diseño para la decisión: la pantalla inicial responde la pregunta principal del producto en segundos, con comparación y contexto, y deja el detalle para el siguiente nivel. El capítulo 32 desarrolla estos principios y su coste en rendimiento. La cuarta es la coherencia entre productos —mismos colores para los mismos significados, mismas convenciones de filtros y fechas—, que convierte el aprendizaje de un producto en aprendizaje de todos. Y la quinta es llevar el producto donde está el usuario: al móvil del directivo que decide en movimiento o a la aplicación operativa del técnico que no va a abrir otra herramienta. La analítica embebida, que trata el capítulo 35, es la versión más ambiciosa de esta idea.
Ciclo de vida: nacer con una decisión, operar con métricas, retirarse a tiempo
Un producto de datos tiene un ciclo de vida reconocible, y la estrategia de BI consiste en buena medida en gobernar sus transiciones. Muchas organizaciones gestionan bien la construcción y mal todo lo demás.
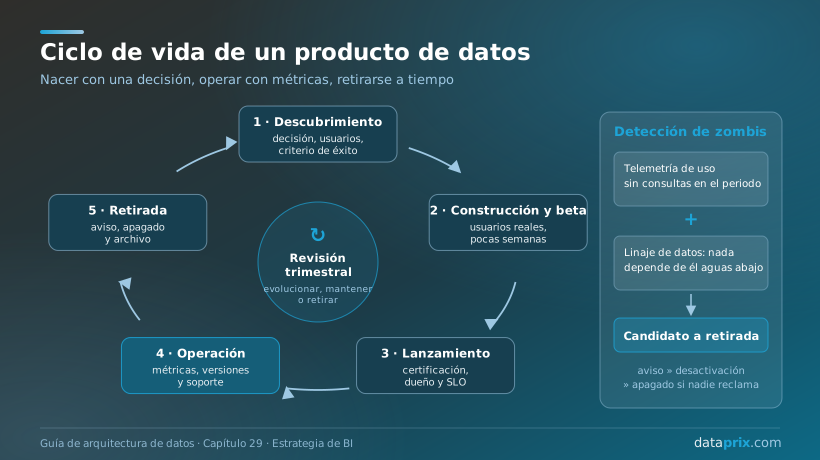
El descubrimiento empieza por escribir, antes de construir nada, la decisión que el producto sostendrá, quién la toma, con qué frecuencia y qué se hace hoy sin él. A esa descripción se añade un criterio de éxito verificable —por ejemplo, que el comité de operaciones deje de pedir el informe semanal en PDF porque usa el producto en la reunión— y un dueño candidato. Si no aparece nadie dispuesto a ser dueño, la señal es clara: el negocio no lo necesita tanto como dice.
La construcción con beta pone una primera versión, deliberadamente incompleta, en manos de un grupo pequeño de usuarios reales durante unas pocas semanas. Es el momento más barato para descubrir que la pregunta estaba mal planteada o que la definición de la métrica no coincide con la que el negocio tenía en la cabeza. El lanzamiento formaliza lo aprendido: certificación, documentación mínima, nivel de servicio pactado y comunicación a los usuarios previstos.
La operación es la fase larga y la que el modelo de proyectos no financia. Incluye vigilar el SLO, atender incidencias, versionar los cambios y, sobre todo, una revisión trimestral con el dueño en la que se miran tres cosas: si el producto se usa, si sostiene la decisión para la que nació y si esa decisión sigue existiendo. La revisión tiene tres salidas posibles: evolucionar, mantener o retirar.
La retirada es la fase más rentable y la menos patrocinada. Un criterio razonable combina uso y dependencia: un producto sin consultas en un periodo pactado y sin dependencias aguas abajo se anuncia como candidato, se desactiva durante un plazo de aviso, se apaga si nadie lo reclama y se archiva su definición por si hiciera falta reconstruirlo. La detección de zombis cruza dos fuentes: la telemetría de uso de la plataforma de BI y el linaje que el capítulo 27 enseñaba a emitir de forma automática, que dice qué depende de cada activo antes de apagarlo. Es la misma lógica que la «regla del apagado» del capítulo 28 aplicada a los flujos de integración, trasladada ahora a la capa de consumo.
Una última transición merece atención propia: el cambio de definición. Cuando una métrica cambia de fórmula —porque se corrige un error antiguo o porque el negocio redefine el concepto—, la cifra que ven los usuarios cambia aunque el negocio no lo haya hecho. Tratarlo como un cambio de producto, con aviso previo, convivencia breve de ambas versiones y explicación de la diferencia, evita la pérdida de confianza que el capítulo 28 describía cuando la nueva venta neta apareció sin previo aviso en los informes de siempre.
Autoservicio gobernado: libertad dentro de un perímetro
El autoservicio es el gran acelerador de la escalera y también su punto de ruptura más frecuente. En el estudio de BARC y Eckerson Group, las herramientas de autoservicio para crear contenido eran, con diferencia, el factor técnico más citado como impulsor del aumento de uso: lo señalaba el 73 % de los encuestados. Es lógico: es la forma de sacar al equipo de BI del camino crítico de cada pregunta. Pero el autoservicio mal planteado produce exactamente los síntomas que se querían curar, multiplicados.
El autoservicio gobernado es la capacidad de los usuarios de negocio para construir sus propios análisis sobre datasets certificados, dentro de espacios y permisos definidos, con un flujo explícito para promover a oficial lo que demuestra valor. Cada elemento de la definición cumple una función. Los datasets certificados garantizan que todos parten de las mismas cifras; la capa semántica, que el capítulo 30 desarrolla, garantiza que las métricas significan lo mismo en cualquier herramienta; los espacios y permisos acotan qué ve cada perfil y dónde puede publicar; y el flujo de promoción evita que un buen análisis de un usuario se quede para siempre en su carpeta personal o, peor, se convierta en la fuente oficial por la puerta de atrás.
Hay dos maneras simétricas de fracasar. La primera es abrirlo todo: licencias para todos, acceso directo a las tablas y confianza en el buen criterio general; en pocos meses hay decenas de versiones de cada cifra y nadie sabe cuál llevar al comité. La segunda es cerrarlo todo: seguridad o el propio equipo de BI bloquean cualquier creación fuera del circuito oficial, y el autoservicio muere de backlog mientras el shadow analytics florece fuera de la plataforma. La estrategia consiste en decidir qué parte del consumo se resuelve con productos y qué parte con autoservicio, y en construir el perímetro antes de abrir la puerta. El capítulo 33 dedica su espacio completo a ese perímetro: seguridad, límites y formación.
Riesgo legal: el shadow analytics con datos personales. Una hoja de cálculo exportada con datos de clientes, empleados o pacientes que circula por correo es un tratamiento de datos personales fuera de cualquier control: sin registro de actividades (art. 30 del RGPD), sin minimización ni plazo de conservación (art. 5) y, si contiene datos de salud, con las exigencias reforzadas de las categorías especiales (art. 9). Un autoservicio gobernado, con permisos por perfil y datasets agregados o seudonimizados por defecto, es también una medida de cumplimiento, y a menudo el argumento que desbloquea su presupuesto. Esto es orientación técnica, no asesoramiento jurídico: conviene validarlo con el delegado de protección de datos.
Quién hace el BI: equipo central, hub-and-spoke o dominios
La pregunta organizativa aparece en cuanto se habla de dueños de producto: ¿dónde viven las personas que construyen y operan la analítica? Hay tres modelos de referencia, con muchas variantes intermedias, y ninguno es universalmente mejor.
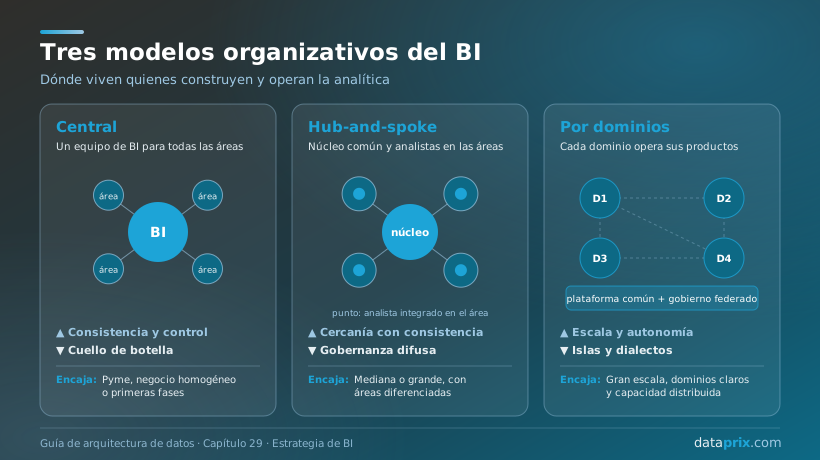
El modelo central concentra en un único equipo —a menudo llamado centro de competencia de BI— la construcción, la operación y el gobierno de toda la analítica. Su fortaleza es la consistencia: una sola forma de calcular, un solo estándar visual, un solo equipo que conoce todos los datos. Su debilidad es la escala: el equipo central se convierte en cuello de botella en cuanto la demanda crece, y su distancia del negocio hace que entienda las peticiones peor que quien las formula. Encaja en organizaciones pequeñas o medianas, con negocio homogéneo, o en las primeras fases de una estrategia de datos.
El modelo hub-and-spoke mantiene un núcleo central responsable de la plataforma, los estándares, la certificación y los datasets compartidos, e integra analistas en cada área de negocio, que construyen y operan los productos de su ámbito con dependencia funcional del área y técnica del núcleo. Es el modelo más extendido en organizaciones medianas y grandes porque equilibra cercanía al negocio y consistencia, a cambio de una gobernanza más trabajosa: hay que pactar qué decide el núcleo y qué decide cada área, y revisarlo cuando cambian las prioridades.
El modelo por dominios lleva la idea al extremo: cada dominio de negocio es dueño de sus productos de datos de punta a punta, sobre una plataforma común de autoservicio y con un gobierno federado que fija estándares mínimos de interoperabilidad. Es el planteamiento organizativo de data mesh. Funciona en organizaciones grandes, con dominios claros y con capacidad técnica distribuida; adoptado sin esas condiciones, produce islas que hablan dialectos distintos de las mismas métricas. Conviene desconfiar del cambio de vocabulario sin cambio de capacidades: llamar «dominios» a los departamentos y «productos» a sus informes no cambia nada.
| Modelo | Dónde viven los dueños de producto | Fortaleza | Riesgo principal | Encaja cuando… |
|---|---|---|---|---|
| Central | En el negocio, atendidos por un único equipo de BI | Consistencia y control | Cuello de botella y distancia del negocio | Tamaño reducido, negocio homogéneo, primeras fases |
| Hub-and-spoke | En cada área, con analistas integrados | Cercanía con consistencia | Gobernanza difusa entre núcleo y áreas | Organización mediana o grande con varias áreas de negocio diferenciadas |
| Por dominios | En cada dominio, con equipos propios de punta a punta | Escala y autonomía | Islas y dialectos distintos de las mismas métricas | Gran escala, dominios claros y capacidad técnica distribuida |
Dos observaciones prácticas completan el cuadro. La primera es que el dueño de producto existe en los tres modelos; lo que cambia es dónde se sientan quienes construyen y operan para él. La organización por squads que proponía el capítulo 5 encaja con cualquiera de ellos y no conviene repetir aquí su desarrollo. La segunda es el ángulo de la pyme: en una empresa de doscientas personas, el «equipo central» pueden ser dos personas y el modelo organizativo es casi irrelevante, pero la lógica de producto se aplica igual, y probablemente con más retorno, porque el recurso escaso es el tiempo de esas dos personas. El artículo de Dataprix sobre Business Intelligence para pymes recorre ese escenario con detalle.
Gestión de la demanda: del buzón de peticiones a una cartera de productos
La forma en que entran las peticiones determina el tipo de BI que sale. Un buzón donde cualquiera pide cualquier cosa produce informes; una puerta de entrada que pregunta por decisiones produce productos. El cambio es pequeño en la forma y grande en el efecto.
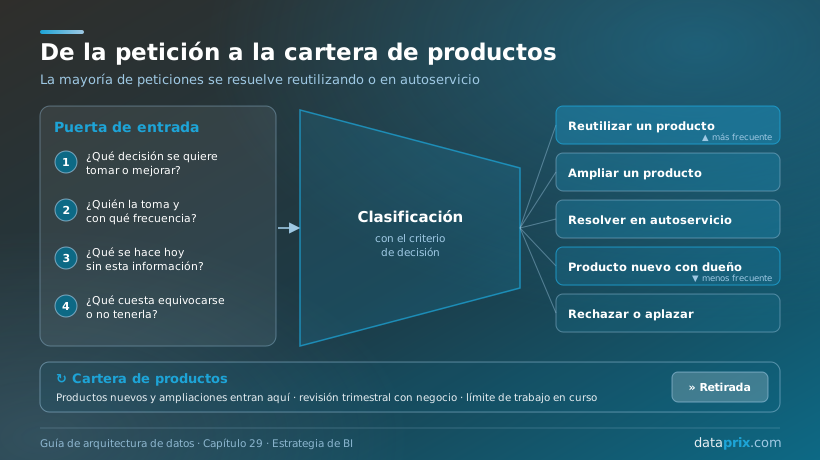
La puerta de entrada funciona con cuatro preguntas obligatorias: qué decisión se quiere tomar o mejorar, quién la toma y con qué frecuencia, qué se hace hoy sin esta información y qué cuesta equivocarse o no tenerla. Las preguntas actúan como primer filtro de una parte de las peticiones, porque obligan a quien pide a pensar para qué lo quiere, y dan al equipo de BI la información que necesita para clasificar.
La clasificación tiene cinco salidas posibles. La más frecuente, si la cartera está bien construida, es reutilizar: la respuesta ya existe en un producto, y lo que hacía falta era encontrarlo. La segunda es ampliar un producto existente con una vista, un filtro o una métrica nueva, con el acuerdo de su dueño. La tercera es resolver en autoservicio, cuando la pregunta es puntual o exploratoria y los datasets certificados la cubren. La cuarta, la menos frecuente, es crear un producto nuevo, solo si se cumplen las tres condiciones del criterio de decisión y aparece un dueño. La quinta es rechazar o aplazar, explicando por qué, que también es una forma de servicio.
La priorización entre productos nuevos y evoluciones se hace por valor, con el mismo razonamiento que el ROI Canvas del capítulo 2 aplicaba a las iniciativas de datos: impacto esperado en la decisión, coste de construir y, sobre todo, coste de operar. Ese último término es el que el modelo de proyectos ignora y el que hace insostenibles las carteras que solo crecen. Dos reglas lo mantienen bajo control: un límite de trabajo en curso, para que el equipo termine antes de empezar, y una revisión trimestral de cartera con representantes del negocio, donde se decide qué entra, qué evoluciona y qué se retira.
Un caso merece mención aparte porque aparece en todas las organizaciones: el comité que pide «un informe de todo». La petición es comprensible —la dirección quiere ver cómo va la compañía— y su ejecución literal es un desastre conocido: decenas de indicadores agregados en una pantalla que nadie abre a las tres semanas. La respuesta útil consiste en aplicar las cuatro preguntas al propio comité: qué decisiones toma cada mes, con qué información, qué echa de menos. Construir un centro de control ejecutivo que funcione es lo bastante exigente como para que el capítulo 36 se dedique entero a un caso.
Medir lo que importa: usuarios activos y decisiones soportadas
Lo que se mide orienta lo que se hace, y en BI se ha medido históricamente lo más fácil: cuántos informes se publican, cuántas peticiones se atienden, cuántas licencias se asignan. Son métricas de esfuerzo, y optimizarlas produce justo la fábrica de informes. La estrategia de producto necesita otras.
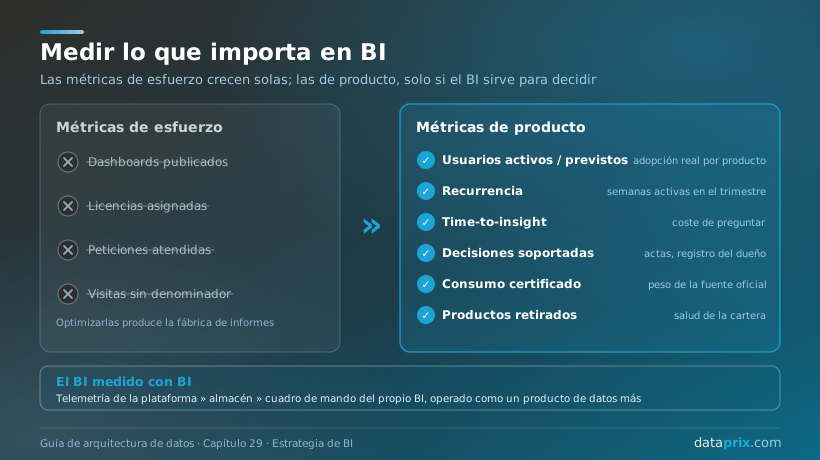
La métrica central es la de usuarios activos sobre usuarios previstos, por producto: de las personas que deberían usarlo según su definición, cuántas lo hacen de forma recurrente. Sin el denominador, el número de visitas no dice nada; un producto con cuarenta usuarios activos puede ser un éxito rotundo si su público objetivo son cuarenta directores de tienda, y un fracaso si son cuatrocientos. Junto a ella, la recurrencia —cuántas semanas del trimestre ha estado activo cada usuario— distingue el uso habitual del curioso que entró una vez, y la profundidad —filtros, navegación al detalle, exportaciones— indica si el producto se usa para analizar o solo para mirar.
Más difícil de medir, y más valiosa, es la proporción de decisiones soportadas. Hay formas prácticas de aproximarla: que el producto aparezca citado en el orden del día o en el acta de la reunión donde se toma la decisión, que el dueño mantenga un registro sencillo de decisiones relevantes apoyadas en él, o que la decisión se tome dentro del propio producto cuando está embebido en un proceso. Ninguna es perfecta; todas son mejores que no preguntarlo.
| Métrica | Qué mide | Cómo se obtiene | Trampa habitual |
|---|---|---|---|
| Usuarios activos / previstos | Adopción real del producto | Telemetría de la plataforma frente a la lista de usuarios previstos | Contar visitas totales sin denominador |
| Recurrencia | Uso habitual frente a uso esporádico | Semanas activas por usuario en el trimestre | Confundir picos de lanzamiento con adopción |
| Time-to-insight | Coste de preguntar | Tiempo entre petición registrada y respuesta disponible | Medir solo las peticiones que pasan por el circuito oficial |
| Decisiones soportadas | Valor del producto | Actas, registro del dueño, decisiones dentro del producto | Darlo por supuesto porque el producto se abre |
| Consumo certificado | Peso de la fuente oficial | Proporción del consumo sobre contenido certificado | Certificar todo para mejorar el indicador |
| Productos retirados | Salud de la cartera | Retiradas por trimestre frente a altas | Retirar solo lo que ya nadie podría reclamar |
Un detalle de implementación cierra el círculo: la telemetría de uso de la plataforma de BI —registros de visualización, sesiones, exportaciones, consultas— se extrae, se carga en el almacén y se trata como un producto de datos más, con su dueño en el equipo de BI y su propio cuadro de mando. Es la forma más directa de que el BI practique lo que predica, y la que permite responder con cifras a la pregunta de si la estrategia está funcionando. Para un diagnóstico de partida más amplio, que sitúe el BI dentro del conjunto de capacidades analíticas, el Test de Madurez Analítica de Dataprix evalúa en unos minutos cultura, infraestructura, gobernanza, equipo y analítica avanzada.
Cuatro sectores subiendo la escalera
Los cuatro escenarios siguientes son ilustrativos, compuestos a partir de patrones habituales de cada sector; no describen organizaciones concretas ni resultados medidos.
Sanidad: del PDF mensual a «ocupación y flujos». La dirección asistencial de un grupo hospitalario recibía cada mes un informe de ocupación en PDF, elaborado a mano por un analista que cruzaba extracciones del sistema de información hospitalaria con hojas de cálculo de cada unidad. Llegaba con tres semanas de retraso y servía para explicar el mes anterior, no para gestionar el siguiente. El cambio empezó por la pregunta del descubrimiento: la decisión real era la gestión diaria de camas, que se tomaba cada mañana en una reunión breve entre admisión y las supervisiones de unidad. El producto resultante, «ocupación y flujos», tiene un dueño clínico —la responsable de gestión de camas—, un SLO de frescura que lo deja actualizado antes de esa reunión y una lista explícita de usuarios. Al tratarse de datos de salud, la mayoría de perfiles ve agregados por unidad sin datos identificativos, y solo el rol de admisión puede bajar al detalle de paciente, con acceso trazado. Lección: el producto empieza a existir cuando hay una reunión que cambia gracias a él.
Industria: una definición de OEE en lugar de cuarenta informes. Un fabricante de componentes con varias plantas acumulaba decenas de informes de eficiencia global de los equipos (OEE), uno o varios por planta, con criterios distintos para las paradas planificadas y los microparos. Comparar plantas era imposible y cada director defendía su cifra. La dirección de operaciones asumió la propiedad de un dataset certificado de OEE con una sola definición escrita y versionada; cada planta construye encima sus propias vistas en autoservicio, y los informes antiguos se retiraron tras un periodo de convivencia. Lección: el autoservicio funciona cuando la definición es única y tiene dueño; sin eso, solo multiplica la discusión.
Sector público: retirar como primera política. Una administración autonómica había acumulado durante años cientos de informes en su plataforma de BI, uno por cada petición de cada servicio, sin que nadie supiera cuáles seguían en uso. El inventario cruzado con los registros de uso mostró que una fracción grande no se había abierto en el último año. La primera decisión de la nueva estrategia fue retirar, antes de construir nada: aviso a los servicios, desactivación durante un trimestre y apagado definitivo de lo que nadie reclamó. Con la capacidad liberada se construyó una cartera corta de productos por servicio, cada uno con su responsable. Lección: retirar es la decisión con mejor retorno de toda la estrategia y la que menos patrocinio tiene; alguien con autoridad debe firmarla.
Agroalimentario: la analítica donde ya está el socio. Una cooperativa agroalimentaria enviaba a sus socios agricultores, por correo y en PDF, las liquidaciones y los informes de calidad de sus entregas. La tasa de apertura era baja y las consultas telefónicas a la oficina, constantes. El producto rediseñado se integró en el portal del socio que ya usaban para otros trámites, con su histórico de entregas, la calidad por parcela y la comparación anónima con la media de la zona. El consumo creció sin una sola licencia nueva de BI, porque la analítica llegó al lugar donde el usuario ya estaba. Lección: es el mismo fenómeno que describía el estudio de BARC; el uso crece cuando la entrega se diseña desde el usuario y su contexto de trabajo.
Anti-patrones: lo que hace caro el BI
El anti-patrón más caro: el producto financiado como proyecto. Se presupuesta la construcción, se lanza con éxito, el equipo pasa al siguiente encargo y nadie queda a cargo. El producto sigue consumiendo capacidad, licencias y soporte, sus definiciones envejecen, su confianza se erosiona y, como no tiene dueño, tampoco hay quien decida retirarlo. Multiplicado por cada proyecto de los últimos años, es la explicación más habitual de por qué el gasto en BI crece mientras la adopción no se mueve. La corrección es presupuestaria antes que técnica: ningún producto se aprueba sin dueño y sin una estimación de su coste de operación anual.
Medir el éxito en dashboards publicados. Es la métrica que convierte al equipo de BI en una fábrica y la que premia exactamente lo que hay que evitar. Un equipo que retira tres productos y mejora la adopción de los restantes ha hecho más por la organización que uno que publica treinta, y el cuadro de mando del propio BI debe reflejarlo.
No retirar nunca nada. Cada informe zombi cuesta poco por separado y mucho en conjunto: capacidad de refresco, ruido en el buscador, riesgo de que alguien tome una decisión sobre una cifra que nadie mantiene. Sin un criterio de retirada escrito y una persona con autoridad para aplicarlo, la cartera solo crece.
Confundir autoservicio con ausencia de gobierno. Abrir licencias y acceso a datos sin datasets certificados ni definiciones comunes multiplica las versiones de la verdad y traslada la conciliación de cifras del equipo de BI a la reunión de dirección.
El comité que pide «un informe de todo». Atender la petición al pie de la letra produce una pantalla con decenas de indicadores sin jerarquía que nadie abre entre reuniones. La respuesta correcta es devolver la pregunta en forma de decisiones y construir pocos indicadores con dueño, definición y umbral.
El cambio de etiqueta. Rebautizar los informes como «productos de datos» y el equipo de BI como «equipo de producto» sin nombrar dueños, pactar niveles de servicio ni medir adopción. La señal es inconfundible: la lista de productos tiene la misma longitud que la antigua lista de informes.
El portal antes que los productos. Invertir meses en un portal corporativo de analítica, con diseño cuidado y buscador, para descubrir al lanzarlo que lo que contiene son los mismos informes de siempre. El punto de entrada único es valioso cuando hay una cartera que merece ser encontrada.
El peldaño 4 de escaparate. Un producto de datos ejemplar, presentado en todos los foros, mientras el 80 % del consumo real sigue circulando por hojas de cálculo exportadas. El piloto tiene valor; el error está en tomarlo por la situación general.
Selección de software: qué pedir a una plataforma de BI pensando en productos
Este es un capítulo de estrategia y las herramientas tienen aquí un papel secundario; la comparativa detallada de plataformas, con su modelo de licenciamiento y su encaje por tipo de consumidor, ocupa el capítulo 31. Aun así, la estrategia de producto añade a la selección de software unos criterios que las demostraciones comerciales rara vez cubren y que conviene llevar escritos a cualquier evaluación.
El primero es la telemetría de uso accesible: registros de visualización y sesión por contenido y por usuario, consultables mediante API y exportables al almacén, con el histórico suficiente para medir recurrencia trimestral. Sin ella no hay métricas de adopción. El segundo es la certificación de contenidos con un sello visible para el usuario y un flujo de aprobación controlado. El tercero es la gestión del ciclo de vida: entornos de desarrollo, pruebas y producción, despliegue entre ellos, control de versiones y, sobre todo, la posibilidad de retirar contenido en bloque mediante automatización. El cuarto es una capa semántica reutilizable, idealmente consumible desde otras herramientas, y con la seguridad a nivel de fila definida una sola vez. El quinto es la capacidad de embeber los productos en aplicaciones operativas y portales. Y el sexto, un licenciamiento alineado con el uso real, que no penalice ampliar el público de un producto que funciona.
Una prueba sencilla para cualquier demostración: pedir al proveedor que muestre, sobre un entorno con contenido real, qué cuadros de mando no ha abierto nadie en el último trimestre y cómo se retirarían todos a la vez. La respuesta dice más sobre la madurez de la plataforma para operar productos que cualquier visualización espectacular.
El ranking de software de Business Intelligence y analítica 2026 del directorio de Dataprix recoge el veredicto editorial de cada opción comercial. Lo encabezan Microsoft Power BI, Tableau, Qlik Sense y Looker, seguidos de SAP Analytics Cloud, Oracle Analytics Cloud, Domo, ThoughtSpot, Strategy One y Pyramid Analytics. Para organizaciones con capacidad de operar su propia plataforma, las alternativas de código abierto como Apache Superset o Metabase cubren buena parte de estos criterios con un modelo de coste distinto: con licencia gratuita y un coste de operación que conviene presupuestar. En cualquier caso, la herramienta debe elegirse después de decidir el modelo operativo y la cartera, nunca antes.
Checklist operativo: de la fábrica de informes a la cartera de productos
- Inventariar todo el contenido publicado en la plataforma de BI y cruzarlo con los registros de uso del último trimestre.
- Clasificar el consumo real por peldaño de la escalera y calcular dónde opera el 80 %; presentar el resultado al comité tal cual sale.
- Retirar, con aviso y plazo de reclamación, el contenido sin uso ni dependencias antes de construir nada nuevo.
- Seleccionar los activos que cumplen las tres condiciones —decisión recurrente, más de un consumidor, consecuencias medibles— como candidatos a producto.
- Nombrar un dueño de negocio, con nombre y apellidos, para cada producto de la cartera; los que no lo consigan no son productos.
- Escribir para cada producto la frase de decisión, la lista de usuarios previstos y el SLO de frescura y disponibilidad.
- Publicar en cada producto la fecha del último refresco, el dueño y el acceso a la definición de cada métrica.
- Sustituir el buzón de peticiones por una puerta de entrada con las cuatro preguntas y las cinco salidas de clasificación.
- Abrir el autoservicio solo sobre datasets certificados, con espacios y permisos por perfil y un flujo de promoción a oficial.
- Cargar la telemetría de uso en el almacén y construir el cuadro de mando del propio BI con usuarios activos sobre previstos, recurrencia, consumo certificado y retiradas.
- Instaurar una revisión trimestral de cartera con el negocio, con un límite de trabajo en curso y presupuesto de operación para cada producto.
- Tratar cada cambio de definición de una métrica como un cambio de producto, con aviso previo y explicación de la diferencia.
- Revisar con el delegado de protección de datos las exportaciones con datos personales y llevarlas a datasets agregados o seudonimizados.
Formación recomendada
Para quienes vayan a impulsar el cambio de modelo operativo, estos recursos en español cubren la estrategia de datos, la alfabetización en datos de los perfiles de negocio y los fundamentos técnicos del BI:
- Estrategia de datos (DataCamp): curso breve, de nivel básico, sobre cómo alinear la estrategia de datos con los objetivos de negocio, implicar a las partes interesadas y conseguir la adopción organizativa. Útil para el CIO y los futuros dueños de producto.
- Habilidades con datos para los negocios (DataCamp): programa sin requisitos técnicos que incluye alfabetización en datos y conceptos de gobernanza, pensado para que los perfiles de negocio decidan con datos y hablen el mismo idioma que el equipo de analítica.
- BI y minería de datos (Udemy): fundamentos técnicos del Business Intelligence para quien necesite asentar la base antes de abordar el cambio de modelo.
Recursos y lecturas recomendadas
- BARC y Eckerson Group, Strategies for Driving Adoption and Usage with BI and Analytics (2022): el estudio que distingue adopción y uso, con sus impulsores y sus barreras.
- Zhamak Dehghani, Data Mesh: Delivering Data-Driven Value at Scale (O'Reilly, 2022): el desarrollo más completo del principio de los datos como producto y de la organización por dominios.
- Zhamak Dehghani, Data Mesh Principles and Logical Architecture (martinfowler.com): la versión breve y gratuita de los principios, buena lectura previa al libro.
- Kiran Prakash, Designing data products: working backwards from use cases (martinfowler.com): un método para diseñar productos de datos partiendo de los casos de uso, en la línea del descubrimiento descrito en este capítulo.
- Data Product Canvas: plantilla colaborativa para describir un producto de datos, sus entradas, su contrato y sus consumidores.
- Business Intelligence para pymes: por dónde empezar y qué evitar (Dataprix): el mismo razonamiento aplicado a organizaciones pequeñas.
- TOP 10 software de Business Intelligence y analítica 2026 y Test de Madurez Analítica (Dataprix): selección de plataforma y diagnóstico de partida.
Preguntas frecuentes sobre estrategia de BI
¿Qué es una estrategia de Business Intelligence?
Es el conjunto de decisiones que determina cómo una organización convierte sus datos en decisiones mejores: qué productos analíticos opera y para quién, cómo se organizan los equipos que los construyen, cómo entra y se prioriza la demanda, qué parte del consumo se resuelve con autoservicio y cómo se mide el éxito. La elección de herramienta llega después, como consecuencia de esas decisiones.
¿Qué diferencia hay entre un informe y un producto de datos?
Un informe se produce para atender una petición y se da por terminado al entregarse; nadie responde de su vigencia después. Un producto de datos se opera de forma continuada: tiene un dueño de negocio, usuarios y decisiones identificados, un nivel de servicio pactado, métricas de adopción y un ciclo de vida que incluye su retirada. El formato puede ser el mismo; lo que cambia es la responsabilidad posterior a la entrega.
¿Qué es un data product owner y quién debe serlo?
Es la persona que responde del valor de un producto de datos: decide su hoja de ruta, a quién sirve, qué nivel de servicio necesita, aprueba los cambios de definición y decide su retirada. Lo recomendable es que pertenezca al área de negocio que toma la decisión que el producto sostiene y que sea una sola persona con nombre y apellidos.
¿Cómo se mide la adopción de BI en una empresa?
Con usuarios activos sobre usuarios previstos, por producto, en lugar de licencias asignadas o informes publicados. Se completa con la recurrencia de uso a lo largo del trimestre, la proporción del consumo que se apoya en contenido certificado y, cuando es posible, el registro de decisiones soportadas. La telemetría de la plataforma de BI, cargada en el almacén, permite calcular todo ello de forma automática.
¿Qué es un informe zombi y cómo se detecta?
Es un informe que sigue refrescándose, consumiendo capacidad y apareciendo en los menús sin que nadie lo abra ni lo use para decidir. Se detecta cruzando la telemetría de uso de la plataforma de BI, que muestra qué contenido no se consulta, con el linaje de datos, que indica si algo depende de él. Los candidatos se anuncian, se desactivan durante un plazo de aviso y se apagan si nadie los reclama.
¿Qué modelo organizativo de BI conviene: central, hub-and-spoke o por dominios?
Depende del tamaño, la homogeneidad del negocio y la capacidad técnica distribuida. El modelo central encaja en organizaciones pequeñas o en fases iniciales; el hub-and-spoke, con un núcleo de plataforma y estándares y analistas integrados en las áreas, es el más extendido en organizaciones medianas y grandes; el modelo por dominios exige escala, dominios claros y equipos técnicos en cada uno. En los tres casos el dueño de producto pertenece al negocio.
Una pregunta para la próxima reunión de dirección
La estrategia de BI se decide pocas veces de forma explícita. Casi siempre se hereda: de la herramienta que se compró, del equipo que se formó alrededor de ella y de la costumbre de atender peticiones. Por eso conviene hacerse una pregunta sencilla antes de la próxima reunión de dirección: si mañana hubiera que escribir el nombre del dueño junto a cada cuadro de mando que se proyecta en esa sala, ¿cuántos nombres aparecerían, y cuántos de esos cuadros podrían decir qué decisión sostienen y cuándo se actualizaron por última vez? La distancia entre esa respuesta y la que la organización necesita es el tamaño real del trabajo pendiente.
El primer obstáculo que aparece al recorrer esa distancia ya ha asomado varias veces en este capítulo: un producto no puede tener una cifra única si la métrica no tiene una definición única. El capítulo siguiente baja un nivel en la arquitectura para resolverlo donde se resuelve, en el modelado semántico y la capa de consumo, que es el contrato entre los datos y todas las superficies donde alguien decide.
Siguiente en la Parte IV: capítulo 30, Modelado semántico y capas de consumo (Data Mart / Semantic Layer). · Parte anterior: Integración de datos y ETL/ELT · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 6 de octubre de 2026.
