Capa semántica: que una métrica signifique lo mismo en todos los equipos

Dataprix — El referente en datos e IT en español
in LinkedIn 𝕏 Follow f Facebook

Cuando dos informes dan dos cifras distintas para la misma métrica, el origen suele estar una capa antes del dashboard. El capítulo 30 de la guía de arquitectura de datos se ocupa de esa capa, la semántica: cómo convive con los data marts, la prueba de la métrica única para saber dónde está cada organización, la matriz para decidir dónde viven las métricas y cómo gobernar la seguridad a nivel de fila y los cambios de definición. Como contrapunto recuperamos el capítulo anterior, que dejó planteada la condición de partida —una cifra única exige una definición única—, y en el directorio acompañamos la edición con Microsoft Power BI, Looker y Denodo Platform, tres formas distintas de resolver la capa.

En el sector, Snowflake lleva a su consola web la gestión de etiquetas y políticas de protección de datos, y Google Cloud abre el catálogo de su entorno Lakehouse a la interfaz de Apache Hive. BigQuery pone en disponibilidad general AI.AGG, una función que resume grandes volúmenes de texto a partir de una instrucción en lenguaje natural, mientras Apache Flink CDC 3.7.0 permite invocar modelos de lenguaje dentro del propio pipeline de replicación. Cierra la semana DuckDB 2.0, cuyo cliente de línea de comandos estrena un modo pensado para los agentes de programación.

Destacado

Capa semántica y data marts

Capa semántica y data marts: cómo lograr que una métrica signifique lo mismo en todos los equipos

Entre el almacén de datos y las herramientas donde alguien decide hay una capa que muchas organizaciones nunca han diseñado de forma explícita. El capítulo 30 propone tratar las métricas como código gobernado —definidas una vez, versionadas, con dueño y con pruebas— y servirlas desde una capa semántica que actúe como contrato con todas las superficies de consumo, del dashboard a la hoja de cálculo y a los agentes de IA. Incluye la prueba de la métrica única, la matriz de ubicación de las métricas y un flujo de seis pasos para cambiar una definición sin romper las series.

Blog de Dataprix


Entradas de blog

Estrategia de Business Intelligence: del informe al producto de datos, con autoservicio y gobernanza

El capítulo que abrió la Parte IV propone la escalera del informe al producto de datos y deja planteada una condición para cualquier producto de datos: una cifra única exige una definición única. El de esta semana baja un nivel en la arquitectura para cumplirla.

Blog de Dataprix


Software empresarial

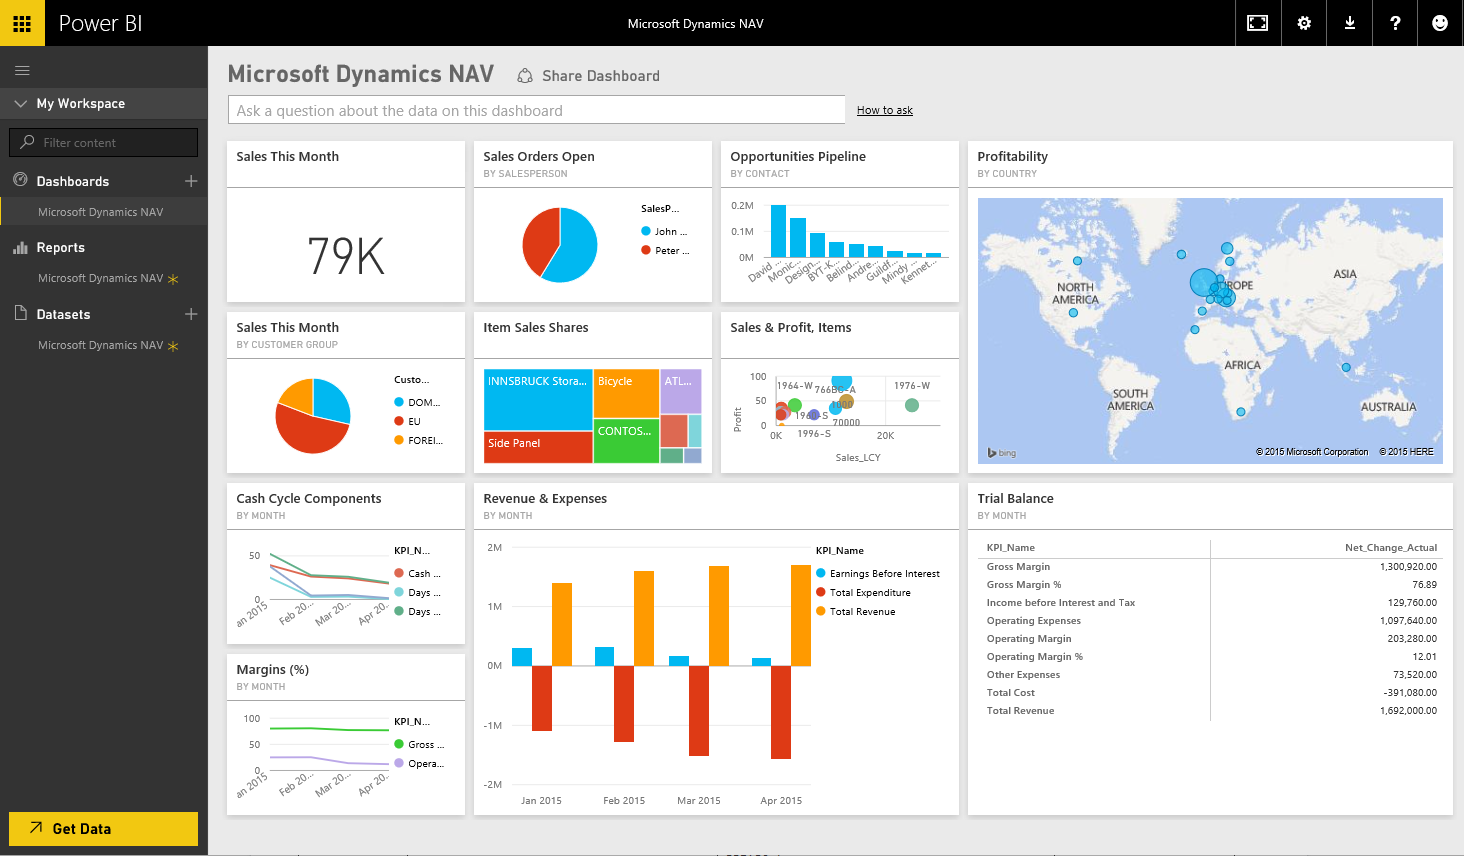
Cuadro de mando de Microsoft Power BI

Microsoft Power BI

La solución de BI de autoservicio de Microsoft. Sus modelos semánticos pueden alimentar muchos informes desde una sola definición y guardarse como texto en un repositorio; el capítulo los sitúa entre las capas integradas en la herramienta de BI con más recorrido en producción.

Cuadro de mando de Looker

Looker

La herramienta de BI de Google trabaja sobre LookML, un modelo como código en el que métricas y dimensiones se definen de forma centralizada. Fue la excepción en la década en que la lógica de negocio se repartió dashboard a dashboard.

Denodo Platform

Denodo Platform

Plataforma de virtualización de datos que ofrece una capa lógica sobre fuentes heterogéneas sin replicarlas físicamente. Otra vía para la capa semántica, sobre fuentes federadas, con un rendimiento que depende de los sistemas de origen.


Noticias del sector datos

Publicado esta semana en Dataprix.net

Logo de Snowflake

Snowflake saca de SQL la gobernanza: etiquetas y políticas de protección de datos ya se gestionan desde Snowsight

Disponibilidad general, desde el 9 de octubre, de la interfaz de Snowsight para etiquetas y políticas de protección de datos. Requiere edición Enterprise o superior y lleva a la consola web un trabajo que hasta ahora se hacía sobre todo con scripts SQL.

Ilustración de una arquitectura data lakehouse

Google Cloud abre su catálogo Lakehouse a Apache Hive y estrena la migración desde Dataproc Metastore

Dos piezas del catálogo de su entorno Lakehouse pasan a disponibilidad general: un endpoint compatible con Hive Metastore, para compartir metadatos con Apache Spark y otros motores, y la migración desde Dataproc Metastore.

Logo de Google Cloud

BigQuery lleva AI.AGG a disponibilidad general: resumir millones de filas de texto con una instrucción en lenguaje natural

Una función que agrega semánticamente datos no estructurados a partir de una instrucción en lenguaje natural, ahora con un argumento para declarar la estructura del resultado.

Logo de Apache Flink

Apache Flink CDC 3.7.0 mete los modelos de lenguaje dentro del pipeline de replicación

La nueva versión de la herramienta de captura de cambios incorpora una API de cliente de modelo conectable, compatible con la interfaz de OpenAI, para generar texto y calcular embeddings desde el propio pipeline.

Logo de DuckDB

DuckDB 2.0 estrena modo agente en su CLI: la base de datos se adapta a quien la consulta desde Claude Code o Cursor

El cliente de línea de comandos cambia cómo devuelve los resultados cuando quien consulta no es una persona sino un agente de programación. No añade capacidades analíticas: adapta la salida a ese nuevo consumidor.


Recurso destacado

Ranking de software de Business Intelligence y analítica 2026 — Directorio Dataprix

Si estás valorando dónde ubicar tu capa semántica, el ranking recoge el veredicto editorial de Dataprix sobre las diez plataformas de BI de su clasificación, de Microsoft Power BI, Tableau, Qlik Sense y Looker a Pyramid Analytics. Un buen punto de partida antes de la comparativa de herramientas que llega en el próximo capítulo de la guía.

Ver el ranking de software de BI →

Dataprix · C/ Font dels Arcs, 10 · La Florida, Barcelona 08130

in LinkedIn 𝕏 Follow f Facebook

Los contenidos de este boletín se elaboran con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.