
Capítulo 30 · Parte IV: Business Intelligence y consumo · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
El capítulo anterior dejó planteada una condición para cualquier producto de datos: una cifra única exige una definición única. Este capítulo baja un nivel en la arquitectura para cumplirla. Entre el almacén de datos y las herramientas donde alguien decide hay una capa que muchas organizaciones nunca han diseñado de forma explícita, la capa semántica, y de ella depende que el margen, el cliente activo o la ocupación signifiquen lo mismo en un dashboard, en una hoja de cálculo y en la respuesta de un asistente de IA.
TL;DR. Cuando dos informes dan dos cifras distintas para la misma métrica, el error rara vez se origina en el dashboard; casi siempre procede de que la métrica se definió varias veces, una por herramienta o por equipo. La solución se sitúa una capa antes del consumo: tratar las métricas como código gobernado —definidas una sola vez, versionadas, con dueño y con pruebas— y servirlas desde una capa semántica que actúa como contrato entre los datos y todas las superficies de consumo. Los data marts siguen haciendo falta como materialización física; la capa semántica añade la definición lógica que los hace coherentes entre sí. Para saber dónde está cada organización basta con la prueba de la métrica única: pedir el margen bruto de marzo a dos herramientas distintas y comparar las cifras.
Más de treinta años de péndulo: de los universos de Business Objects al semantic layer
En 1991, una empresa francesa fundada un año antes por Bernard Liautaud y Denis Payre solicitó en Estados Unidos una patente con un título poco comercial: Relational database access system using semantically dynamic objects. Se concedió en 1996 con el número US 5.555.403 y describía algo que hoy resulta familiar: una capa intermedia que traduce conceptos de negocio —cliente, ingresos, región— a las tablas y uniones de una base de datos relacional, de modo que alguien sin conocimientos de SQL pueda formular su pregunta con las palabras de su oficio. La empresa era Business Objects, y a esa capa la llamó universo. Durante dos décadas, diseñar y mantener universos fue un oficio con nombre propio en los departamentos de BI, y en 2007 SAP anunció la compra de la compañía por 6.800 millones de dólares.
Casi al mismo tiempo, la otra gran familia de la analítica corporativa recorría un camino paralelo. En julio de 1993, Edgar F. Codd, el padre del modelo relacional, firmó con dos coautores un informe publicado por Computerworld que popularizó el término OLAP y proponía doce reglas para los sistemas de análisis multidimensional; la revista lo retiró cuando se supo que lo había patrocinado Arbor Software, cuyo producto, Essbase, encajaba sospechosamente bien con aquellas reglas. La polémica no frenó a la categoría. En noviembre de 1998, Microsoft incluyó OLAP Services en SQL Server 7.0, rebautizado como Analysis Services en la versión 2000, y los cubos se convirtieron en el estándar de facto del análisis corporativo. Un cubo era también una capa semántica: medidas, dimensiones y jerarquías definidas una vez, a las que se conectaban Excel y las herramientas de informes. El archivo de Dataprix conserva artículos de aquella época sobre las variantes MOLAP y ROLAP con las que se debatía entonces cómo materializarlos.
Universos y cubos resolvían bien el problema de la consistencia y mal el de la velocidad. Cualquier cambio —una dimensión nueva, una medida corregida— pasaba por un equipo especializado, una ventana de reproceso nocturno y, a menudo, varias semanas de cola. En la memoria de muchos usuarios de negocio, la capa semántica quedó asociada al cuello de botella, y la hoja de cálculo exportada se convirtió en la vía de escape.
La década siguiente desmontó aquel modelo casi sin proponérselo. Los almacenes en la nube con almacenamiento columnar y cómputo elástico —Redshift, BigQuery, Snowflake, Synapse y sus sucesores— abarataron tanto la consulta que precalcular cubos dejó de compensar en muchos casos; la transformación se trasladó al propio almacén con el patrón ELT que describía el capítulo 20, y las herramientas de visualización de autoservicio aprendieron a lanzar SQL directamente contra las tablas. Ganó la agilidad. Por el camino, la capa semántica se fragmentó en cientos de pedazos, uno por dashboard: cada libro de trabajo, cada informe y cada consulta guardada empezó a llevar dentro su propia versión del margen o del cliente activo. Looker, fundada en 2012 y comprada por Google en una operación anunciada en 2019, fue la excepción notable: mantuvo un lenguaje de modelado propio, LookML, que se versionaba como cualquier otro código.
El péndulo empezó a volver en 2021. En abril de ese año, Benn Stancil, entonces en Mode, publicó un ensayo muy citado, The missing piece of the modern data stack, que identificaba la pieza ausente del stack moderno: una capa central de métricas que cualquier herramienta pudiera consultar para obtener siempre la misma cifra. Los hitos se encadenaron después con rapidez. En febrero de 2023, dbt Labs anunció la compra de Transform, creadora del motor de métricas MetricFlow, para construir su dbt Semantic Layer. En noviembre de ese año, Microsoft renombró los datasets de Power BI como modelos semánticos, un cambio que Chris Webb interpretó como una invitación a reutilizar modelos en lugar de crear uno por informe. En agosto de 2024, Google abrió la capa semántica de Looker a otras herramientas mediante una interfaz SQL y conectores para Tableau, Power BI o las hojas de cálculo de Google; en septiembre, AtScale liberó con licencia Apache su lenguaje de modelado SML, y en abril de 2025 Salesforce presentó Tableau Semantics como capa semántica de la nueva generación de Tableau.
El último año y medio ha añadido la pieza que faltaba: la portabilidad. En septiembre de 2025, Snowflake, Salesforce, dbt Labs, BlackRock y otras compañías lanzaron la iniciativa Open Semantic Interchange (OSI) para definir un formato neutral con el que trasladar definiciones semánticas entre herramientas, y un mes después dbt Labs publicó MetricFlow con licencia Apache 2.0 como parte de ese compromiso. La primera versión de la especificación se publicó en enero de 2026, también con licencia Apache 2.0, y en julio el proyecto entró en la incubadora de la Apache Software Foundation con un nombre nuevo, Apache Ossie. Mientras tanto, las plataformas de datos han incorporado objetos semánticos nativos —las semantic views de Snowflake y las metric views de Unity Catalog en Databricks—, y Microsoft presentó en noviembre de 2025 Fabric IQ, cuya ontología puede construirse a partir de los modelos semánticos de Power BI que ya existen.
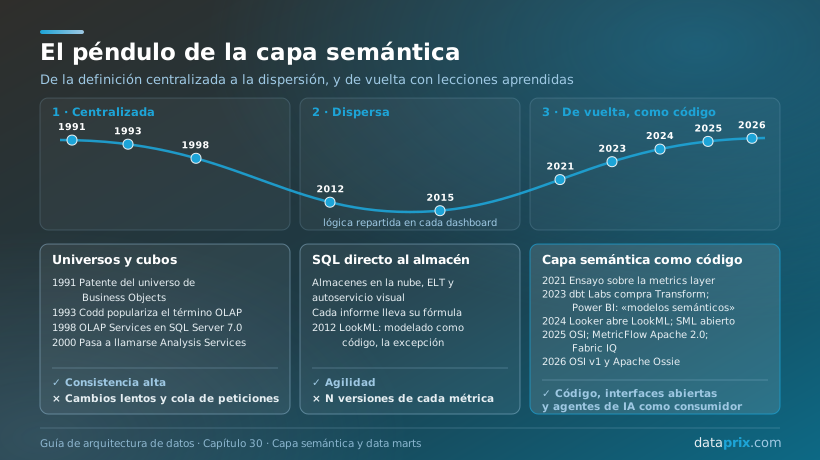
El péndulo vuelve, aunque a un punto distinto del que partió. La capa semántica de 2026 conserva la idea de los universos —definir una vez, consultar desde muchos sitios— e incorpora lecciones aprendidas por las malas. Las definiciones se escriben como código, en ficheros versionados que se revisan y se prueban, en lugar de vivir encerradas en la interfaz gráfica de una herramienta propietaria. La capa ofrece interfaces abiertas —SQL, API, conectores— para que la consulten varias herramientas, porque casi ninguna organización mediana tiene ya una sola. Y ha aparecido un consumidor nuevo que no puede preguntar al analista qué significa «margen»: los asistentes y agentes de IA que generan consultas a partir de lenguaje natural y que, sin definiciones gobernadas, improvisan la suya en cada respuesta.
Esa es la tesis de este capítulo. El problema de «dos informes, dos cifras» se resuelve una capa antes del dashboard: las métricas son código gobernado, definido una vez, versionado y con dueño, y la capa semántica es el contrato entre los datos y todas las superficies de consumo. Sin ella, cada herramienta de BI se convierte en una fuente de verdad paralela, y la reunión de dirección dedica su primera media hora a conciliar cifras.
Capa semántica, métrica gobernada y data mart: definiciones para entenderse
La conversación sobre capas semánticas se enreda pronto porque el vocabulario se solapa: el mercado habla de semantic layer, metrics layer, headless BI, modelos semánticos y data marts como si fueran intercambiables. Conviene fijar los términos antes de seguir.
Una capa semántica es una capa lógica situada entre los datos físicos y las superficies de consumo que define una sola vez las entidades de negocio, sus relaciones, las dimensiones de análisis, las métricas y las reglas de acceso, y que traduce cada pregunta formulada en esos términos a la consulta correcta sobre el almacén. Quien pregunta por los «ingresos netos del trimestre por región» no necesita saber qué tablas intervienen, cómo se unen ni qué filtros excluyen las devoluciones: la capa lo resuelve igual para todos.
Una métrica gobernada es una métrica con un nombre único en la organización, una definición escrita en lenguaje de negocio, una fórmula expresada como código versionado, un dueño que aprueba sus cambios y pruebas que vigilan su comportamiento. Si falta cualquiera de esos cinco elementos, lo que existe es una fórmula más o menos compartida, que funciona hasta el día en que alguien la copia y la modifica.
Un data mart es un subconjunto del almacén orientado a un área o proceso de negocio —ventas, logística, recursos humanos—, normalmente modelado en estrella con tablas de hechos y dimensiones, y materializado físicamente: son tablas que ocupan almacenamiento, se cargan con un pipeline y se consultan. Su relación con la capa semántica es de complemento. El data mart es físico y decide cómo se guardan y organizan los datos para consultarlos bien; la capa semántica es lógica y decide qué significan y cómo se calculan las métricas en el momento en que alguien pregunta.
La metrics layer, también llamada headless BI, es una capa semántica desacoplada de cualquier herramienta de visualización: no tiene interfaz propia y sirve sus definiciones por API o por SQL a cualquier consumidor, igual que un gestor de contenidos headless sirve textos sin imponer cómo se pintan. Es el enfoque de productos como Cube, AtScale o dbt Semantic Layer, que se analizan más adelante.
Y la fuente única de verdad (single source of truth) es la propiedad según la cual cada nombre de métrica tiene una sola definición vigente y todas las superficies que lo usan devuelven la misma cifra ante la misma pregunta. El matiz que más se olvida es que se trata de una propiedad que hay que operar y medir de forma continua: declararla en un documento de arquitectura no la produce, y basta una fórmula copiada en un informe nuevo para perderla.
| Dimensión | Data mart | Capa semántica |
|---|---|---|
| Naturaleza | Física: tablas cargadas y almacenadas | Lógica: definiciones que se compilan en consultas |
| Qué contiene | Hechos y dimensiones a un grano concreto, con su historia | Entidades, relaciones, dimensiones, jerarquías, métricas y reglas de acceso |
| Qué lógica le corresponde | La que se resuelve fila a fila: limpieza, deduplicación, historia de cambios | La que depende de la pregunta: ratios, acumulados, recuentos distintos |
| Cómo cambia | Con un despliegue de pipeline y, a veces, una recarga | Con un cambio de definición versionado, sin mover datos |
| Quién lo consume | Ingenieros, analistas avanzados y la propia capa semántica | Herramientas de BI, hojas de cálculo, aplicaciones y agentes de IA |
| Riesgo típico | Proliferar un mart por cada petición | Convertirse en cuello de botella o quedarse en la capa de un solo equipo |
La prueba de la métrica única
Antes de discutir herramientas conviene saber cuántas capas semánticas tiene de verdad una organización, y para eso hay una prueba que cabe en una frase. Se pide el margen bruto de marzo a dos herramientas distintas de la organización —el BI corporativo y la hoja de cálculo del controller, por ejemplo, o el cuadro de mando comercial y el informe del ERP—, formulando exactamente la misma pregunta. Si las cifras difieren, la organización no tiene una capa semántica: tiene varias.
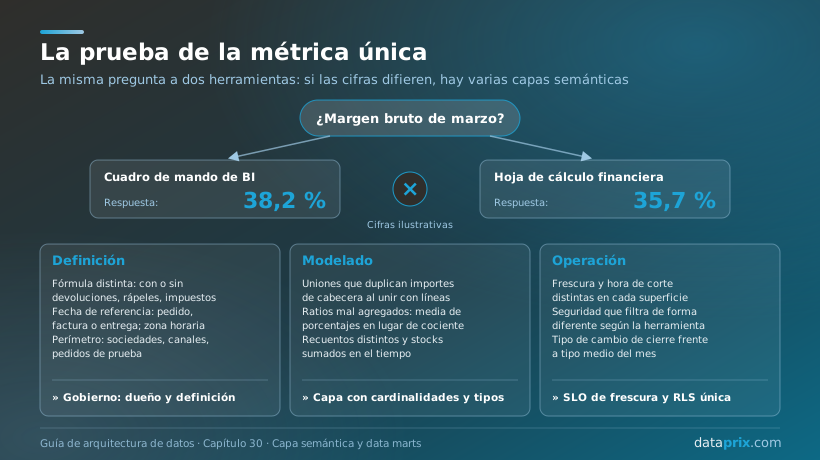
La prueba es deliberadamente sencilla, pero da mucha más información si se ejecuta con método. Se eligen entre cinco y diez métricas de las que llegan al comité de dirección. Se localizan todas las superficies donde aparecen, incluidas las que nadie considera parte del BI: el PDF que se adjunta al acta, la exportación del ERP que alguien retoca, el informe que se envía a un cliente y, cada vez más, el asistente de IA al que un directivo pregunta en lenguaje natural. Se fija la pregunta con precisión notarial —periodo, perímetro, moneda, fecha de corte— y se anotan las cifras en una tabla. Cada discrepancia se clasifica después por su causa, y esa clasificación suele ser más reveladora que el número de discrepancias.
Las causas se agrupan en tres familias. La primera es la definición. La variante evidente son dos fórmulas distintas bajo el mismo nombre: margen con o sin devoluciones, con o sin rápeles, antes o después de impuestos. La variante sutil es la fecha de referencia: el margen de marzo calculado por fecha de pedido, de factura o de entrega da tres cifras distintas, y las tres son defendibles. A ella se suman el calendario (mes fiscal o natural) y la zona horaria, que en España tiene un ejemplo propio: un pedido hecho a las 00:30 del 1 de abril en hora peninsular queda registrado el 31 de marzo si el sistema guarda la hora en UTC, y también si se interpreta en hora canaria. Completa la familia el perímetro: qué sociedades del grupo entran, si se eliminan las operaciones entre ellas, qué canales cuentan y si alguien recordó excluir los pedidos de prueba.
La segunda familia es el modelado, y es la que más sorprende a los equipos de negocio porque las fórmulas son idénticas y aun así las cifras no cuadran. El caso clásico es la unión que duplica importes: si el coste de envío está en la cabecera del pedido y alguien une la cabecera con sus líneas antes de sumar, cada pedido de cinco líneas cuenta su envío cinco veces. Le siguen los ratios mal agregados: la media de los márgenes porcentuales de cada mes no es el margen porcentual del trimestre, que se calcula dividiendo el margen total entre los ingresos totales. Y cierran la familia las métricas no aditivas: los recuentos distintos, como los usuarios activos, no se pueden sumar entre días ni entre regiones, porque la misma persona aparece en varios; y las métricas semiaditivas, como el stock o el saldo, se suman entre almacenes o cuentas, pero en el tiempo se toma el último valor.
La tercera familia es la operación. Una superficie se refrescó a las 7:00 y la otra trabaja con un extracto de la noche anterior. Una aplica seguridad a nivel de fila y la otra no, de modo que un usuario ve una parte de los datos y la toma por el total. Una convierte la moneda con el tipo de cierre y la otra con el tipo medio del mes. Ninguna de estas diferencias está en la fórmula, y por eso sobreviven a cualquier revisión de definiciones.
Cada familia pide un remedio distinto. Las discrepancias de definición son un problema de gobierno: alguien tiene que ser dueño de la métrica y escribir qué significa. Las de modelado se resuelven en la propia capa, que debe conocer las cardinalidades de las relaciones y el tipo de agregación de cada métrica para calcular bien a cualquier granularidad. Y las de operación se resuelven con niveles de servicio de frescura, como los que describía el capítulo 24, y con una seguridad definida en un solo sitio. Repetida cada trimestre, la prueba se convierte además en un indicador: la proporción de métricas del comité que dan la misma cifra en todas sus superficies es la medida más honesta de la salud de una capa semántica, y merece un lugar en el cuadro de mando del propio equipo de BI.
Del data mart físico a la capa lógica: convivencia y reparto del trabajo
La tentación, al descubrir la capa semántica, es pensar que hace innecesarios los data marts. La historia del data warehousing sugiere lo contrario. Ralph Kimball construyó su metodología dimensional sobre la idea de dimensiones conformadas: cliente, producto o fecha se definen una vez y se comparten entre todos los marts, y una matriz de bus cruza procesos de negocio con dimensiones para planificar esa coherencia. Bill Inmon defendía el camino inverso, un almacén corporativo normalizado del que se alimentan marts dependientes. Las dos escuelas coincidían en que la consistencia había que diseñarla de antemano, y el archivo de Dataprix recoge el debate en artículos como Modelos de construcción de Data Warehouses o el manual de la metodología HEFESTO. Las dimensiones conformadas fueron, de hecho, la primera respuesta seria al problema de las dos cifras, resuelta en el plano físico.
Los data marts siguen haciendo falta por razones que la capa semántica no elimina. La primera es el rendimiento: un esquema en estrella al grano correcto, con las uniones resueltas y las columnas que se consultan, responde mucho más deprisa que una capa lógica obligada a reconstruirlo en cada consulta; es la aplicación del diseño por patrón de acceso del capítulo 9 y de la separación entre cargas transaccionales y analíticas del capítulo 10. La segunda son los consumidores que no hablan con la capa semántica: procesos de ciencia de datos que leen tablas, exportaciones regulatorias con formato fijo, otros sistemas que reciben datos. La tercera es el aislamiento por dominio, que permite asignar dueño, presupuesto y coste a cada área. Y la cuarta es el contrato estable: en una arquitectura por capas como la medallion que describía el capítulo 8, los marts son la capa oro, la que se publica y se protege con contratos.
Lo que añade la capa semántica es aquello que el plano físico hace mal. Define las métricas que cruzan marts, como el coste logístico por pedido, que combina el mart de logística con el de ventas a través de dimensiones conformadas. Resuelve la lógica que depende de la pregunta, porque el margen porcentual se calcula de forma distinta por día, por tienda o por trimestre. Concentra la seguridad y los metadatos en un único sitio. Y ofrece interfaces para muchos consumidores a la vez.
La regla práctica para repartir el trabajo es sencilla de enunciar: si un cálculo se puede resolver fila a fila, va en el data mart; si depende del nivel de agregación de la pregunta, va en la capa semántica. Deduplicar clientes, asignar cada venta a su tienda, conservar la historia de cambios de un atributo o convertir la moneda con el tipo del día de la operación son trabajo del pipeline y del mart. El margen porcentual, los usuarios activos de 28 días, las ventas acumuladas del año o el ticket medio son trabajo de la capa. El rendimiento obliga a veces a materializar agregados precalculados, pero incluso entonces la definición vive en la capa, que decide cuándo usarlos; la mayoría de los motores semánticos actuales ofrece algún mecanismo de este tipo, sea en forma de agregaciones, preagregaciones o tablas derivadas persistentes.
El caso de Vandelar del capítulo 28 ilustra la frontera. La migración a ELT consolidó en un único modelo la venta neta que tres paquetes calculaban de tres maneras, y lo hizo en el plano físico. Si después cada herramienta de BI hubiera vuelto a calcular la venta neta con sus propios filtros, el problema habría reaparecido una capa más arriba. La consolidación del mart es condición necesaria para la cifra única; la capa semántica es lo que impide que se deshaga.
Anatomía de una capa semántica
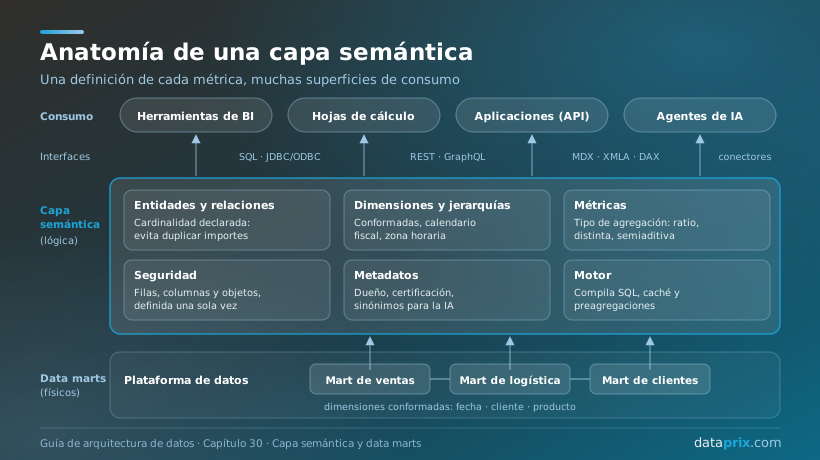
Con independencia del producto, toda capa semántica madura se compone de las mismas piezas. Conocerlas permite evaluar herramientas con criterio y, sobre todo, detectar qué le falta a la capa que ya existe en la organización aunque nadie la haya llamado así.
Entidades y relaciones
La base de la capa son las entidades de negocio —pedido, cliente, producto, sesión— asociadas a las tablas de los marts, y las relaciones entre ellas. El detalle que separa una capa seria de un catálogo de fórmulas es la cardinalidad declarada: si la capa sabe que un pedido tiene muchas líneas, puede detectar que sumar un importe de cabecera después de unir con las líneas lo duplicaría, y reescribir la consulta o negarse a ejecutarla. Es exactamente el error de modelado que la prueba de la métrica única encuentra con más frecuencia en los dashboards construidos a mano.
Dimensiones y jerarquías
Las dimensiones son los ejes de análisis, y las más valiosas son las conformadas, compartidas por todos los marts. La dimensión de tiempo merece un trato propio: calendario fiscal, semanas ISO, festivos por comunidad autónoma y el criterio de zona horaria forman parte de su definición. Las jerarquías ordenan los niveles de agregación —país, comunidad autónoma, provincia; año, trimestre, mes— y las hay de tipo padre-hijo, como un organigrama o un plan contable, que exigen un tratamiento recursivo. Hay además una decisión que suele quedar implícita y conviene escribir: cuando un atributo cambia con el tiempo, ¿se analiza con el valor vigente hoy o con el que tenía en la fecha del hecho? Las ventas por región de un comercial que cambió de zona en junio dan cifras distintas según la respuesta.
Métricas con su tipo de agregación
Las métricas son la pieza central de la capa, y cada una debe declarar su tipo para que el motor la calcule bien a cualquier granularidad. Las simples suman o cuentan. Las de ratio agregan numerador y denominador por separado y dividen al final. Las derivadas se construyen a partir de otras métricas, como el margen a partir de ingresos y coste. Las acumuladas o de ventana resuelven el acumulado del año o los últimos 28 días. Los recuentos distintos no son aditivos y las semiaditivas se suman en unas dimensiones y en otras no. Junto a la fórmula, cada métrica lleva sus metadatos: descripción en lenguaje de negocio, dueño, unidad y formato, estado de certificación y, cada vez más, sinónimos y ejemplos de uso que ayudan a los agentes de IA a elegir la métrica correcta cuando alguien pregunta con otras palabras.
El siguiente esquema muestra qué debe contener una definición completa. Es ilustrativo: no reproduce la sintaxis de ninguna herramienta concreta, aunque los formatos actuales, casi todos basados en YAML, recogen información equivalente.
Del ejemplo importa menos la sintaxis que la información que obliga a escribir: dueño, tipo, aditividad, dimensiones permitidas y versión. Con la línea aditiva_en_el_tiempo: no, la capa se negará a sumar los usuarios activos de cada día para obtener los del mes, que es uno de los errores más frecuentes en los cuadros de mando hechos a mano.
Seguridad
La capa es el lugar natural para la seguridad a nivel de fila (qué registros ve cada usuario), de columna (qué atributos, por ejemplo los datos personales) y de objeto (qué métricas o entidades existen para cada perfil). Por su importancia y por lo mal que suele resolverse, se trata en una sección propia más adelante.
Interfaces y motor
Una capa semántica vale lo que valen sus interfaces, porque de ellas depende cuántas superficies la consultan de verdad. Las habituales son una interfaz SQL accesible por JDBC u ODBC, que en algunos productos es compatible con el protocolo de PostgreSQL para que cualquier herramienta la vea como una base de datos; API REST o GraphQL para aplicaciones; protocolos multidimensionales como MDX, XMLA o DAX para Excel y clientes de la familia de Analysis Services; conectores nativos para herramientas concretas, y una vía para que los agentes de IA consulten métricas por su nombre en lugar de generar SQL contra las tablas. Por debajo, el motor compila cada pregunta en el dialecto SQL del almacén, delega el cálculo en él, guarda resultados en caché y usa preagregaciones cuando existen, con las mismas cautelas sobre invalidación que el capítulo 13 describía para cualquier caché. Y registra quién consulta qué métrica desde dónde: esa telemetría es la que permite medir la adopción, como pedía el capítulo 29, y analizar el impacto de un cambio antes de hacerlo.
Dónde viven las métricas: la matriz de ubicación
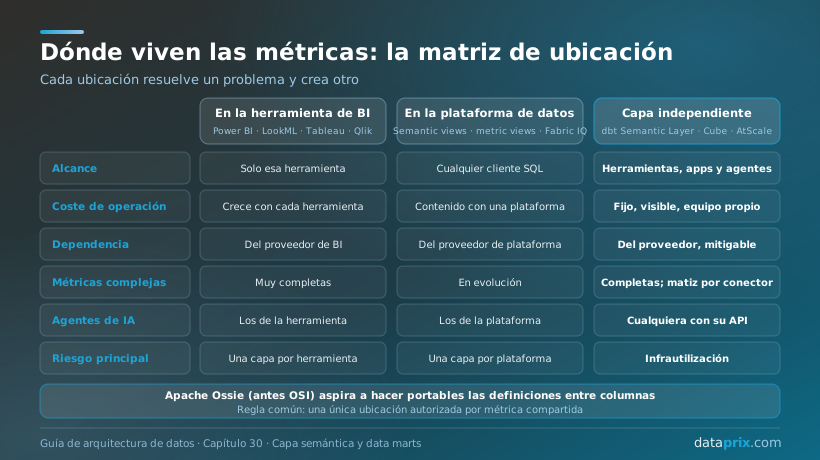
La pregunta práctica que sigue a la anatomía es dónde construir la capa. Hay tres ubicaciones posibles, cada una con sus productos y sus compromisos, y la elección condiciona el coste, el alcance y la dependencia de un proveedor durante años. Los datos de producto que siguen están fechados a octubre de 2026, en un mercado que cambia cada trimestre; los criterios de decisión envejecen bastante mejor.
En la herramienta de BI
Es la ubicación más común porque llega de serie. Los modelos semánticos de Power BI heredan el motor tabular de Analysis Services y el lenguaje DAX; su formato de definición en texto, TMDL, permite guardarlos en Git, y en Microsoft Fabric el modo Direct Lake los conecta a las tablas Delta de OneLake sin importar los datos. Un mismo modelo puede alimentar muchos informes, y el punto de conexión XMLA, en las capacidades que lo habilitan, permite consultarlo desde Excel y otros clientes. LookML es el modelo como código de Looker y, desde 2024, puede consultarse desde otras herramientas a través de su interfaz SQL abierta, anunciada inicialmente para modelos conectados a BigQuery. Tableau ofrece sus orígenes de datos publicados y, en su nueva generación, Tableau Semantics; Qlik mantiene su modelo asociativo con elementos maestros reutilizables.
La ventaja de esta ubicación es la experiencia integrada: el modelo y la visualización hablan el mismo idioma, las funciones de inteligencia temporal son ricas y hay un único proveedor al que reclamar. Su límite es el alcance. La capa llega hasta donde llega la herramienta, y en cuanto la organización incorpora una segunda —porque un área compró otra, porque una aplicación necesita las métricas por API—, aparece una segunda capa semántica.
En la plataforma de datos
La segunda ubicación sitúa las definiciones junto a los datos. Las semantic views de Snowflake son objetos de esquema que guardan tablas lógicas, relaciones, hechos, dimensiones y métricas; las metric views de Databricks separan en Unity Catalog las medidas de las dimensiones para definir cada métrica una vez y consultarla en tiempo de ejecución; y la ontología de Fabric IQ extiende los modelos semánticos de Power BI hacia un modelo formal del negocio. Existe además la versión clásica de esta ubicación: tablas y vistas agregadas que construyen herramientas de transformación como dbt, SQLMesh o Dataform. Funciona para granos fijos y se queda corta para el análisis libre, porque cada nueva combinación de dimensiones exige una tabla nueva.
La ventaja es la cercanía: la capa hereda la seguridad y el catálogo de la plataforma, la consulta cualquier cliente SQL y la usan los asistentes de IA de la propia plataforma. Los inconvenientes son la dependencia de esa plataforma, un soporte desigual en las herramientas de BI y una madurez todavía en evolución para métricas complejas. Una organización con dos plataformas vuelve, además, a tener dos capas.
En una capa independiente
La tercera ubicación es la capa universal o headless, un componente propio entre la plataforma y las herramientas. dbt Semantic Layer se apoya en MetricFlow, de código abierto con licencia Apache 2.0 desde octubre de 2025, mientras que el servicio que expone las métricas a las herramientas forma parte de la plataforma comercial de dbt Labs, que completó en junio de 2026 su fusión con Fivetran. Cube publica su núcleo como código abierto —el backend con licencia Apache 2.0 y el cliente con licencia MIT—, expone las métricas por SQL, REST y GraphQL y ofrece una versión gestionada comercial. AtScale es una plataforma comercial de capa semántica universal que liberó en 2024 su lenguaje de modelado. En una línea distinta, la virtualización de datos de plataformas como Denodo también ofrece una capa semántica sobre fuentes federadas, con un rendimiento que depende de los sistemas de origen.
Su ventaja es el alcance y la neutralidad: cualquier herramienta, aplicación o agente consume las mismas definiciones, y la organización no queda atada al proveedor de BI. El precio es un componente más que operar, con su disponibilidad, su latencia y su coste, una calidad de conector que varía según la herramienta —la experiencia en Excel o en Power BI no siempre está a la altura de la nativa— y la necesidad de un equipo que domine el modelado como código.
Apache Ossie: la portabilidad como seguro
La especificación que nació como Open Semantic Interchange, hoy Apache Ossie en incubación, define un formato neutral basado en YAML para expresar métricas, dimensiones y sus relaciones, de modo que una definición pueda trasladarse de una ubicación a otra. Entre los participantes que listaba la iniciativa en enero de 2026 figuraban dbt Labs, Snowflake, Salesforce, Databricks, Qlik, AtScale, Cube, ThoughtSpot y Sigma, entre otros. Si cumple lo que promete, reducirá el coste de equivocarse de ubicación, que hoy es el principal riesgo de la decisión. A octubre de 2026 el proyecto sigue en incubación y el grado de soporte varía de un proveedor a otro, así que lo razonable es preguntar a cada proveedor por su hoja de ruta de compatibilidad sin convertirla aún en un criterio eliminatorio.
| Criterio | En la herramienta de BI | En la plataforma de datos | Capa independiente |
|---|---|---|---|
| Alcance | Los usuarios de esa herramienta | Cualquier cliente SQL de la plataforma | Cualquier herramienta, aplicación o agente |
| Coste de arranque | Bajo: viene incluida | Bajo o medio, según la plataforma | Medio: un componente nuevo que desplegar |
| Coste de operación | Crece con cada herramienta adicional | Contenido mientras haya una sola plataforma | Fijo y visible, con equipo propio |
| Dependencia | Del proveedor de BI | Del proveedor de la plataforma | Del proveedor de la capa, mitigable con código abierto |
| Métricas complejas | Muy completas dentro de la herramienta | En evolución | Completas, con matices por conector |
| Agentes de IA | Los de la propia herramienta | Los de la propia plataforma | Cualquiera que use su API |
| Riesgo principal | Una capa por herramienta | Una capa por plataforma | Infrautilización si las herramientas no la adoptan |
Criterio de decisión. Si una sola herramienta de BI concentra el consumo y no hay consumidores fuera de ella, la capa de esa herramienta es la opción más barata y razonable, siempre que se use como modelo compartido y no como un modelo por informe. Si hay dos o más superficies con peso real, o consumidores fuera del BI —aplicaciones, hojas de cálculo, agentes de IA—, la capa debe salir de la herramienta: a la plataforma, si la organización vive en una sola y piensa seguir en ella; a una capa independiente, si tiene varias o necesita neutralidad. En cualquier combinación rige la misma regla: cada métrica compartida tiene una única ubicación autorizada, y ninguna otra superficie puede redefinirla con el mismo nombre.
En la práctica, muchas organizaciones acaban en un modelo híbrido: las métricas compartidas viven en una ubicación autorizada y cada herramienta conserva la libertad de crear cálculos locales para explorar. El híbrido funciona si se respeta una convención de nombres que impida que un cálculo local suplante a una métrica certificada, y si existe un camino para promover a la capa compartida lo que demuestra valor, en la línea del autoservicio gobernado que proponía el capítulo anterior.
Seguridad a nivel de fila: definirla una vez
La seguridad a nivel de fila (RLS, por sus siglas en inglés) decide qué registros ve cada usuario: el director regional, los de su región; el jefe de servicio, los de su servicio; el cliente de un portal, solo los suyos. Puede implementarse en tres sitios —en el almacén, en la capa semántica o en la herramienta de BI— y el error más extendido es implementarla en los tres a la vez, cada uno con su propia lógica.
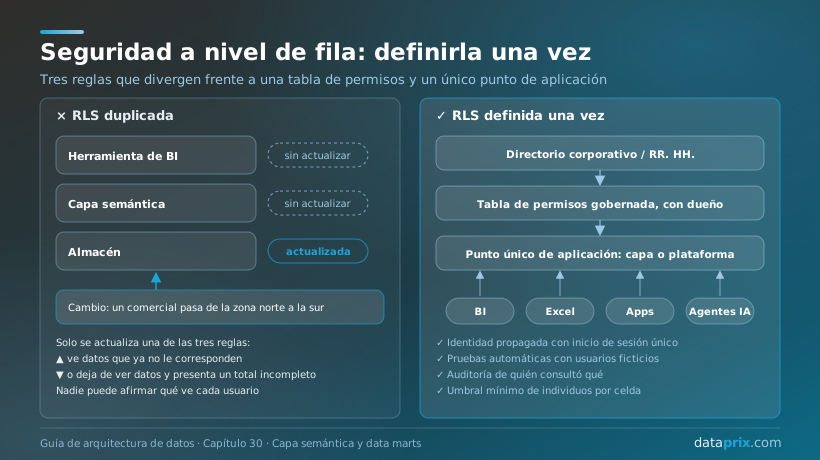
La duplicación es tentadora porque cada equipo protege lo que controla, y peligrosa porque las reglas cambian. Un comercial que pasa de la zona norte a la sur obliga a actualizar su asignación en tres sitios; si se olvida uno, ocurre una de dos cosas, ambas malas: o ve datos que ya no le corresponden, que es un acceso indebido, o deja de ver datos que sí, y presenta en el comité una cifra incompleta convencido de que es el total. Con tres implementaciones, además, nadie puede afirmar con certeza qué ve cada usuario, y esa es la pregunta que hará cualquier auditoría.
El patrón que funciona tiene cuatro elementos. Primero, una tabla de permisos gobernada —quién ve qué— con un dueño y alimentada desde el sistema que conoce la verdad organizativa: el directorio corporativo, recursos humanos o el CRM. Segundo, un único punto de aplicación: la capa por la que pasan todos los consumidores, que suele ser la capa semántica o la plataforma, según la matriz anterior. Tercero, la propagación de la identidad: si la herramienta de BI se conecta al almacén con una cuenta de servicio genérica, el almacén ve un único usuario y su RLS no sirve de nada; la identidad real tiene que viajar hasta el punto de aplicación mediante inicio de sesión único o delegación. Y cuarto, pruebas automáticas: usuarios ficticios con permisos conocidos ejecutan consultas en cada despliegue y verifican cuántas filas ven, con el mismo espíritu que los tests de datos del capítulo 26. Un registro de auditoría de los accesos completa el patrón.
La seguridad de columna sigue la misma lógica para los datos personales: enmascarar o excluir nombres, documentos de identidad o direcciones para los perfiles que no los necesitan, en un único sitio. Y conviene una última precaución: las métricas agregadas también filtran información cuando el grupo es muy pequeño, de modo que en datos sensibles se fija un umbral mínimo de individuos por celda por debajo del cual la capa no devuelve la cifra.
Riesgo legal: RLS duplicada sobre datos especialmente protegidos. Cuando la capa sirve datos de salud, afiliación o cualquier otra categoría especial del artículo 9 del RGPD, una regla de acceso que diverge entre herramientas deja de ser un problema de calidad y pasa a ser un posible incumplimiento de las obligaciones de seguridad del tratamiento (art. 32) y de protección de datos desde el diseño (art. 25). Definir los permisos una sola vez, propagar la identidad y conservar la traza de quién consultó qué es la forma más defendible de demostrar control ante una inspección. Esto es orientación técnica, no asesoramiento jurídico: conviene validar el diseño con el delegado de protección de datos.
Gobernar el cambio de una métrica
Una métrica gobernada cambia, y debe poder hacerlo: el negocio redefine conceptos, aparecen errores antiguos, cambia una regulación o un sistema de origen. El objetivo del gobierno es que el cambio sea deliberado, visible y reversible, y para eso la métrica se trata como cualquier otro código.
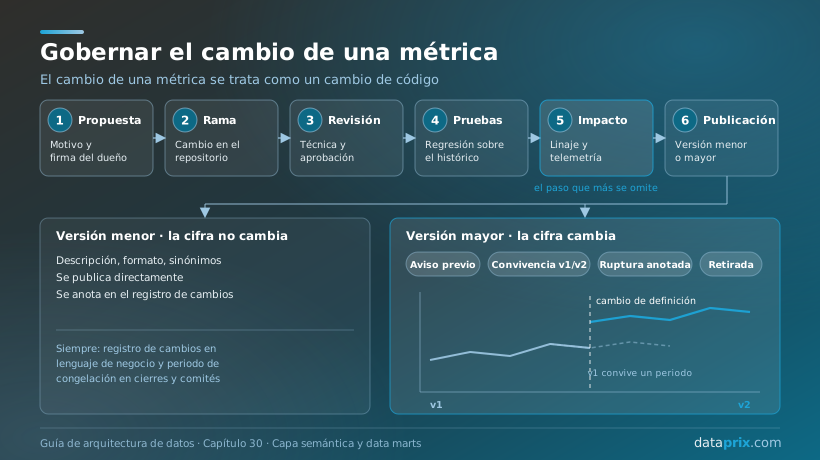
El flujo empieza con una propuesta que explica el motivo y que firma el dueño de la métrica, que en el vocabulario del capítulo anterior es el dueño del producto de datos que la sostiene. El cambio se escribe en una rama del repositorio y pasa una revisión técnica y la aprobación del dueño: la primera garantiza que la fórmula hace lo que dice; la segunda, que lo que dice es lo que el negocio quiere. Después vienen las pruebas de regresión, que calculan la versión nueva y la anterior sobre el histórico reciente y cuantifican la diferencia, y los tests de contrato que el capítulo 26 aplicaba entre productores y consumidores.
El paso que más se omite es el análisis de impacto. Antes de publicar hay que saber qué dashboards, aplicaciones, exportaciones y agentes consumen la métrica, y eso lo dice el linaje que el capítulo 27 enseñaba a emitir de forma automática, completado con la telemetría de consumo de la propia capa. Con esa lista se decide el tipo de versión. Los cambios que no alteran la cifra —una descripción mejor, un formato— son versiones menores y se publican sin más. Los que la alteran son versiones mayores y siguen un protocolo: aviso previo a los consumidores, convivencia de ambas versiones durante un periodo pactado, una nota de ruptura de serie visible en los gráficos en la fecha del cambio y retirada de la versión antigua con fecha anunciada.
Dos prácticas completan el gobierno. Un registro de cambios visible para los usuarios, en lenguaje de negocio, que responda a la pregunta de por qué la cifra de hoy no coincide con la del informe del trimestre pasado. Y un periodo de congelación durante los cierres contables y la preparación de los comités, en el que solo se publican correcciones urgentes. Nada de esto es exótico para un equipo de software; lo exótico es que se aplique a las métricas.
Lo que cuesta mantener N capas semánticas
La situación de partida de la mayoría de organizaciones es la existencia de varias capas semánticas, una por herramienta y a veces una por equipo, que nadie ha contado. Su coste no aparece en ninguna factura porque está repartido.
Cada capa adicional duplica el trabajo de modelado, las reglas de seguridad, las pruebas, la documentación y la formación. Pero el coste que más crece es el de conciliación, y lo hace más deprisa que el número de capas: con N superficies que calculan la misma métrica hay N·(N−1)/2 parejas que pueden discrepar. Dos superficies generan una pareja; cuatro, seis; seis, quince. Cada pareja es una conversación potencial en la que alguien explica por qué su cifra es la buena, y cada conversación retrasa una decisión o, peor, hace que se tome sobre la cifra equivocada. A ello se suma un coste menos visible, la erosión de la confianza: cuando los directivos aprenden que las cifras dependen de quién las presenta, empiezan a pedir la suya, y el ciclo se realimenta.
Los asistentes de IA han añadido un término nuevo a la ecuación. Un agente que genera SQL contra las tablas sin una capa semántica no reproduce ninguna de las definiciones existentes: improvisa una nueva en cada respuesta, con la seguridad de quien no sabe que hay un debate. Conectarlo a la capa convierte al agente en una superficie más que pasa la prueba de la métrica única; dejarlo suelto añade una fuente de discrepancias que, además, se expresa con mucha convicción.
El argumento contrario también merece espacio: una capa central es un componente con coste propio, y para una organización pequeña puede ser excesivo. En una pyme con una sola herramienta de BI, la capa semántica es el modelo de esa herramienta, y la disciplina se reduce a una regla que cuesta poco y rinde mucho: un modelo compartido del que cuelgan todos los informes, en lugar de un modelo por informe. El artículo de Dataprix sobre Business Intelligence para pymes recorre ese escenario, en el que casi siempre el primer paso con más retorno es dejar de copiar modelos.
Caso ilustrativo: tres «usuarios activos» en un grupo de medios
Grupo Ondavera es un grupo de comunicación ficticio pero representativo, compuesto a partir de patrones habituales del sector de medios digitales en España. Ni su nombre ni las situaciones descritas corresponden a una organización real, y las magnitudes se expresan como órdenes de magnitud ilustrativos, no como resultados medidos.
Ondavera edita varias cabeceras regionales digitales, una revista temática y un conjunto de newsletters, y vive de dos fuentes de ingresos que tiran en direcciones distintas: la publicidad, que premia el alcance, y las suscripciones digitales, que premian la fidelidad. En una revisión trimestral, tres áreas presentaron al comité de dirección la evolución de los «usuarios activos» con tres cifras tan alejadas que la discusión sobre la estrategia del muro de pago se convirtió en una discusión sobre quién tenía razón.
La redacción medía navegadores únicos con al menos una página vista en el mes, a partir de la herramienta de analítica web, y los explotaba en un cuadro de mando de Apache Superset que las jefaturas de sección consultaban a diario. Producto digital medía usuarios registrados que habían iniciado sesión en los últimos 28 días, calculados en un cuaderno de análisis a partir de los eventos autenticados. Y el área comercial presentaba la audiencia que publica el medidor externo de referencia para el mercado publicitario, con su propia metodología, en un informe de Power BI que se enviaba a las agencias. La cifra de la redacción multiplicaba varias veces la de producto, y la comercial quedaba entre ambas. Las tres eran correctas dentro de su contexto, y ninguna podía sustituir a las otras.
La prueba, con método
El equipo de datos aplicó la prueba de la métrica única a esa y a otras seis métricas del comité, y la clasificación de las causas resultó más útil que la constatación del desacuerdo. Había, por supuesto, tres definiciones distintas. Pero aparecieron también errores de modelado: una versión del cuadro de producto sumaba los usuarios activos de cada día para obtener los del mes, de modo que una lectora fiel contaba treinta veces. Y aparecieron factores de operación que nadie había considerado: el recuento de navegadores dependía del consentimiento de cookies, y un rediseño del aviso de consentimiento había movido la cifra sin que se moviera la audiencia. A todo ello se sumaba una cuarta cifra, fabricada en finanzas para una presentación, que «corregía» la audiencia del medidor externo con datos propios.
La decisión: tres nombres para tres métricas
El taller con los dueños de cada área llegó a una conclusión que conviene subrayar: forzar una definición única de «usuario activo» habría destruido información que cada área necesitaba. La redacción decide qué temas cubrir con el alcance; producto decide el muro de pago con la fidelidad registrada; comercial vende con la cifra que reconoce el mercado. La solución fue dar a cada métrica su propio nombre y su propio dueño: navegadores únicos, con dueño en la redacción; usuarios registrados activos de 28 días, con dueño en producto; audiencia medida, con dueño en comercial, importada tal como la publica el medidor y etiquetada con su fuente. La expresión genérica «usuarios activos» se retiró de todos los cuadros de mando.
El comité eligió además una de las tres como métrica de referencia para la estrategia —los usuarios registrados activos, porque son el paso previo a la suscripción y se miden con datos propios— y definió una sola vez la tasa de conversión de registro a suscripción, como cociente de sumas sobre cohortes mensuales, para que el proyecto del muro de pago tuviera un indicador que nadie pudiera recalcular a su manera.
La arquitectura
Los eventos de navegación y de sesión llegan al almacén analítico del grupo, donde tres data marts organizan los datos: audiencia, con los eventos agregados por día, cabecera y pieza; suscripciones, alimentado desde la plataforma de pagos; y comercial, con los datos del medidor externo tal como se reciben. Para los navegadores únicos, el mart guarda bocetos (sketches) HyperLogLog, una estructura que permite combinar recuentos distintos aproximados entre días y cabeceras sin volver a los eventos; la capa declara en sus metadatos que esa métrica es aproximada y la definición escrita indica el margen de error asumido.
Como los consumidores eran heterogéneos —Superset en la redacción, Power BI en comercial, cuadernos en producto, una aplicación interna de seguimiento en directo y, más tarde, un asistente de IA para las jefaturas de sección—, Ondavera optó por una capa semántica independiente. Evaluó dbt Semantic Layer y Cube, y eligió la segunda por su API REST para la aplicación de la redacción y su interfaz SQL para Superset y los cuadernos. El área comercial conservó su modelo de Power BI para las métricas que solo usa ella, como los ingresos por campaña, y lee las métricas compartidas a través de la interfaz SQL de la capa, con una regla escrita: ningún nombre de métrica compartida puede redefinirse en el modelo local. El asistente de IA, que responde preguntas como qué piezas del día anterior generaron más registros, consulta la capa por el nombre de la métrica y nunca las tablas directamente.
La seguridad se definió una sola vez en la capa, a partir de una tabla de permisos alimentada por el directorio corporativo: las jefaturas de cada cabecera ven su cabecera, comercial ve el conjunto y solo el equipo de datos de producto accede al nivel de usuario. Los usuarios registrados son datos personales, así que la capa solo sirve agregados a los demás perfiles y los eventos llevan identificadores seudonimizados.
El gobierno y los resultados
Un comité de métricas de media hora al mes reúne a los tres dueños y al equipo de BI para revisar propuestas de cambio y el resultado trimestral de la prueba. Cuando producto cambió la definición de sesión al introducir el inicio de sesión persistente, la métrica pasó a la versión 2.0, convivió un trimestre con la anterior y los gráficos muestran la ruptura de serie con una nota; la versión 2.1.0 que aparece en el esquema de la sección de anatomía corresponde a una corrección posterior de la descripción, sin cambio de cifra. El rediseño del aviso de consentimiento quedó anotado del mismo modo en la serie de navegadores únicos.
En un escenario así, lo habitual es que el comité deje de dedicar el arranque de la reunión a conciliar, porque las tres cifras aparecen juntas, cada una con su nombre, su dueño y su definición a un clic. La conversación se desplaza hacia lo que interesa: qué contenidos convierten, en qué cabeceras y con qué coste.
Lección: la métrica única no siempre es una sola cifra; a veces son tres métricas con tres nombres. Lo que no puede existir es un nombre con tres definiciones. Lección: los recuentos distintos esconden buena parte de las divergencias, y declarar su no aditividad en la capa evita el error más frecuente de los cuadros de mando hechos a mano. Lección: una métrica externa se importa tal cual y se etiqueta con su fuente; recalcularla con datos propios solo fabrica una cifra más.
La misma prueba en otros tres sectores
Los tres escenarios siguientes son ilustrativos, compuestos a partir de patrones habituales de cada sector; no describen organizaciones concretas ni resultados medidos.
Logística: tres «entregas a tiempo». Un operador logístico con presencia en varios países medía la puntualidad de tres maneras. Operaciones comparaba la entrega con la franja que confirmaba el transportista; atención al cliente, con la fecha prometida al destinatario en el momento de la compra; y finanzas, con el plazo del contrato con cada cliente, que es el que activa penalizaciones. Además, cada país registraba la hora en su zona horaria y el agregado europeo mezclaba criterios. La capa semántica fijó tres métricas con nombres distintos, una dimensión de tiempo con zona horaria explícita y una sola definición contractual para el comité. Lección: la fecha de referencia forma parte de la definición, y una métrica que no la declara en su nombre o en su descripción está incompleta.
Energía: cuántos clientes tiene una comercializadora. En una compañía de electricidad y gas, el área comercial contaba contratos, la de operaciones contaba puntos de suministro —cada uno identificado por su CUPS— y atención al cliente contaba titulares. Un hogar con luz y gas son dos contratos, dos puntos de suministro y un titular, de modo que las tres cifras eran correctas y la palabra «cliente» no significaba nada. La solución fue una dimensión conformada de titular compartida por los tres marts y métricas cuyo nombre declara el grano: contratos activos, puntos de suministro activos, titulares activos. Lección: muchos conflictos de métricas son conflictos de grano, y declarar el grano en el nombre los resuelve antes de que lleguen al comité.
Sanidad: actividad asistencial y acceso por rol. Una red de centros sanitarios privados medía la actividad de consultas externas con criterios distintos: unos centros contaban las teleconsultas y otros no, unos separaban primeras visitas y sucesivas y otros las sumaban, y las citas no presentadas entraban o salían según quién hiciera el informe. La capa semántica unificó la definición con su dueño en la dirección asistencial y, sobre todo, concentró el acceso: los analistas de gestión ven agregados por servicio con un umbral mínimo de pacientes por celda, cada jefatura ve su servicio y solo los perfiles autorizados bajan al detalle de paciente, con acceso trazado. Lección: en sanidad, la capa semántica es también el lugar donde se aplica la minimización que exige el artículo 9 del RGPD, y definirla una sola vez es una obligación de cumplimiento además de una buena práctica de ingeniería.
Anti-patrones de la capa semántica
El anti-patrón más caro: la lógica de negocio dentro de cada dashboard. Cada informe incorpora su propia fórmula del margen o de la venta neta. Parece barato, porque escribir una medida cuesta minutos, y el coste llega después: cuando la definición cambia hay N copias que actualizar y nadie sabe dónde están todas, las reuniones empiezan por conciliar, y resulta imposible auditar qué cifra se llevó al consejo y con qué fórmula. La corrección es una regla de diseño sin excepciones: ninguna métrica compartida se define en un informe; el informe referencia la métrica de la capa, y los cálculos locales quedan reservados a la exploración, con una etiqueta visible que los distingue.
La capa semántica de un solo equipo. Finanzas construye un modelo excelente que solo usa finanzas, y el resto de la organización sigue con sus fórmulas. Es una capa semántica en la forma y un silo más en la práctica. Una capa se mide por cuántas superficies la consultan, y su lanzamiento debe incluir la migración de los consumidores, no solo su construcción.
Métricas sin dueño ni definición escrita. La fórmula está en el código, pero nadie sabe qué decisión sostiene, quién aprueba cambiarla ni qué significa exactamente en lenguaje de negocio. Cuando llega la primera discrepancia, no hay a quién preguntar y gana quien más grita.
La seguridad implementada tres veces. Ya descrita en su sección: tres reglas que divergen con el primer cambio organizativo y una pregunta, qué ve cada usuario, que nadie puede responder con certeza.
Modelarlo todo antes de servir nada. Un proyecto de dos años para modelar la empresa entera antes de publicar la primera métrica. Cuando termina, el negocio ha cambiado y los usuarios se han acostumbrado a sus hojas de cálculo. Lo que funciona es empezar por las métricas que llegan al comité, publicarlas en semanas y crecer por demanda, con la prueba de la métrica única como indicador de avance.
La capa como aduana. El equipo central exige aprobar cada cálculo, incluido el exploratorio, y el autoservicio muere de cola mientras la analítica en la sombra florece fuera. La salida es distinguir niveles: métricas certificadas, gobernadas con todo el rigor, y cálculos de exploración permitidos con libertad y etiquetados como tales, con un camino de promoción entre ambos. El capítulo 33 desarrolla esos carriles del autoservicio.
La verdad declarada. La diapositiva de arquitectura proclama una fuente única de verdad que nadie mide. Mientras la prueba de la métrica única no se ejecute cada trimestre y su resultado no se publique, la afirmación es una aspiración.
Olvidar al consumidor que no pregunta. Se despliega un asistente de IA con acceso directo a las tablas del almacén y se descubre al cabo de unas semanas que responde con convicción cifras que no coinciden con ninguna otra. Un agente debe consumir la capa semántica con la misma disciplina que cualquier otra superficie, y conviene incluirlo en la prueba de la métrica única desde el primer día.
Selección de software: qué exigir a una capa semántica
La comparativa de herramientas de BI ocupa el capítulo siguiente, y allí la ubicación de la capa semántica será uno de los primeros criterios. Aquí interesa lo que debe exigirse a la capa en sí, viva donde viva. Los criterios conviene llevarlos escritos a cualquier evaluación, porque las demostraciones comerciales rara vez los cubren por iniciativa propia.
El primero son las interfaces de consumo que cubren las superficies reales de la organización, cada una probada con las consultas habituales y también con Excel, que sigue siendo la superficie de consumo más extendida. El segundo es la definición como código con ciclo de vida completo: repositorio, revisión, integración continua, entornos de desarrollo y producción, y vuelta atrás. El tercero, la expresividad para las métricas difíciles: ratios, recuentos distintos, semiaditivas, ventanas temporales, calendario fiscal y conversión de moneda. El cuarto, el rendimiento y el coste: delegación del cálculo en el almacén, caché, preagregaciones y comportamiento con la concurrencia de las nueve de la mañana, que es cuando todo el mundo abre el mismo cuadro, sin olvidar cuánto factura el almacén por cada consulta que la capa genera.
El quinto criterio es la seguridad con propagación de identidad, con RLS y seguridad de columna definidas en la capa y auditoría de accesos. El sexto, los metadatos y el gobierno: dueños, certificación, descripciones, exportación del linaje al catálogo y telemetría de uso por métrica. El séptimo, la portabilidad: formatos de exportación y hoja de ruta de compatibilidad con Apache Ossie. Y el octavo, el modelo de licencia y de operación, con una mirada específica al ecosistema local: red de partners, soporte en español y comunidad, que en el mercado español pesan tanto como las funcionalidades.
Una prueba sencilla para cualquier demostración: pedir al proveedor que defina, en directo, una métrica de ratio con un recuento distinto en el denominador —los ingresos por usuario activo, por ejemplo— y que la consulte desde dos herramientas distintas y a dos granularidades. Si las cifras cuadran y el proveedor explica sin titubear por qué la suma de los días no coincide con el mes, la capa merece una evaluación seria.
El ranking de software de Business Intelligence y analítica 2026 del directorio de Dataprix recoge el veredicto editorial de cada plataforma. Lo encabezan Microsoft Power BI, Tableau, Qlik Sense y Looker, seguidos de SAP Analytics Cloud, Oracle Analytics Cloud, Domo, ThoughtSpot, Strategy One y Pyramid Analytics. En nuestra valoración, los modelos semánticos de Power BI y LookML son hoy las capas integradas con más recorrido en producción, y varias de las demás compañías del ranking —Qlik, ThoughtSpot, Domo y Strategy, además de Salesforce como propietaria de Tableau— figuraban en enero de 2026 entre los participantes de la iniciativa que hoy es Apache Ossie. Para la ubicación en la plataforma, el ranking de plataformas de datos incluye las fichas de Snowflake y Databricks, cuyos objetos semánticos se han descrito más arriba. Y para quien prefiera código abierto, Cube Core y MetricFlow cubren la capa independiente, mientras que Lightdash y Apache Superset ofrecen visualización con modelos ligeros que pueden apoyarse en ella; gratis de licencia, con un coste de operación que conviene presupuestar desde el principio.
Checklist operativo: de N definiciones a una métrica gobernada
- Ejecutar la prueba de la métrica única sobre las cinco a diez métricas del comité, en todas sus superficies, incluidas hojas de cálculo, PDF y asistentes de IA.
- Clasificar cada discrepancia por familia —definición, modelado u operación— y asignar el remedio que corresponde a cada una.
- Inventariar cuántas capas semánticas existen de hecho: modelos por herramienta, por equipo y por informe.
- Nombrar un dueño de negocio para cada métrica compartida y escribir su definición, su fecha de referencia y su grano.
- Renombrar las métricas que comparten nombre y difieren en significado, y retirar los nombres genéricos ambiguos.
- Decidir la ubicación autorizada de las métricas compartidas con la matriz de ubicación y dejarla escrita.
- Repartir el trabajo entre marts y capa: lo que se resuelve fila a fila, al mart; lo que depende de la agregación, a la capa.
- Declarar en la capa las cardinalidades de las relaciones y el tipo de agregación de cada métrica, incluidas las no aditivas.
- Guardar las definiciones como código en un repositorio, con revisión, pruebas de regresión y entornos separados.
- Definir la seguridad a nivel de fila y de columna una sola vez, sobre una tabla de permisos gobernada, y propagar la identidad del usuario.
- Automatizar pruebas de seguridad con usuarios ficticios y fijar umbrales mínimos de individuos en datos sensibles.
- Aplicar el protocolo de versiones mayores —aviso, convivencia, nota de ruptura de serie y retirada— a todo cambio que altere una cifra.
- Conectar los agentes de IA a la capa semántica y no a las tablas, e incluirlos en la prueba trimestral.
- Publicar cada trimestre la proporción de métricas del comité que pasan la prueba en todas sus superficies.
Formación recomendada
Para analistas, ingenieros y arquitectos que vayan a construir o gobernar la capa, estos cursos en español cubren el modelado dimensional que sostiene los data marts y el modelado semántico en la herramienta más extendida en el ecosistema Microsoft:
- Conceptos de almacenamiento de datos (DataCamp): curso conceptual de nivel intermedio que recorre los enfoques de Kimball e Inmon, los esquemas en estrella y en copo de nieve y la relación entre almacenes y data marts.
- Modelado de datos en Power BI (DataCamp): curso básico sobre cómo construir el modelo semántico de Power BI con esquemas en estrella, el punto de partida para un modelo compartido entre informes.
- Introducción a DAX en Power BI (DataCamp): medidas, columnas y tablas calculadas con DAX, el lenguaje en el que se escriben las métricas del modelo semántico de Power BI.
- Data Analytics y Power BI (Udemy): formación práctica de análisis de datos con Power BI para quien necesite asentar la base antes de abordar el modelado compartido.
Recursos y lecturas recomendadas
- Ralph Kimball y Margy Ross, The Data Warehouse Toolkit, 3.ª edición (Wiley, 2013): la referencia del modelado dimensional, las dimensiones conformadas y la matriz de bus. Las técnicas de modelado dimensional del Kimball Group están resumidas y accesibles en su web.
- Benn Stancil, The missing piece of the modern data stack (abril de 2021): el ensayo que reabrió el debate sobre la capa de métricas en el stack moderno.
- Apache Ossie: el sitio de la especificación abierta para intercambiar definiciones semánticas, antes Open Semantic Interchange, con su estado de incubación y sus grupos de trabajo.
- Documentación de dbt Semantic Layer y repositorio de MetricFlow: el modelado de métricas como código en el ecosistema dbt.
- Documentación de Cube y su repositorio: una capa semántica independiente de código abierto, con preagregaciones e interfaces SQL, REST y GraphQL.
- Modelos semánticos en Microsoft Fabric y seguridad de nivel de fila en Power BI (Microsoft Learn, en español).
- Google Cloud, Opening up the Looker semantic layer (agosto de 2024): cómo se expone LookML a otras herramientas.
- Data Warehouse: guía definitiva 2026 y dbt: qué es y cómo funciona (Dataprix): el contexto de almacén y transformación sobre el que se construye la capa.
Preguntas frecuentes sobre la capa semántica
¿Qué es una capa semántica (semantic layer)?
Es una capa lógica situada entre los datos físicos y las herramientas de consumo que define una sola vez las entidades de negocio, sus relaciones, las dimensiones, las métricas y las reglas de acceso, y traduce cada pregunta formulada en términos de negocio a la consulta correcta sobre el almacén. Su función es que todas las herramientas, aplicaciones y agentes de IA que la consultan obtengan la misma cifra ante la misma pregunta.
¿Qué diferencia hay entre un data mart y una capa semántica?
El data mart es físico: un conjunto de tablas, normalmente en estrella, orientado a un área de negocio, que se carga y ocupa almacenamiento. La capa semántica es lógica: un conjunto de definiciones que se compilan en consultas en el momento de preguntar. Se complementan: lo que se puede resolver fila a fila va en el data mart, y lo que depende del nivel de agregación de la pregunta, como un ratio o un recuento distinto, va en la capa semántica.
¿Dónde conviene definir las métricas: en la herramienta de BI, en la plataforma de datos o en una capa independiente?
Depende de cuántas superficies consumen las métricas. Si una sola herramienta de BI concentra el consumo, su modelo semántico, usado como modelo compartido, es la opción más económica. Si hay varias herramientas o consumidores fuera del BI, como aplicaciones o agentes de IA, conviene sacar las métricas de la herramienta: a la plataforma de datos si la organización trabaja con una sola, o a una capa independiente si tiene varias o necesita neutralidad. En todos los casos, cada métrica compartida debe tener una única ubicación autorizada.
¿Dónde se debe implementar la seguridad a nivel de fila (RLS)?
En un único punto por el que pasen todos los consumidores, que suele ser la capa semántica o la plataforma de datos, a partir de una tabla de permisos gobernada y alimentada desde el directorio corporativo. La identidad real del usuario tiene que llegar hasta ese punto, porque si la herramienta se conecta con una cuenta de servicio genérica la seguridad del almacén no distingue usuarios. Implementarla en varios sitios a la vez provoca divergencias que acaban en accesos indebidos o en cifras incompletas.
¿Qué es la prueba de la métrica única y cómo se aplica?
Es un diagnóstico que consiste en pedir la misma métrica, por ejemplo el margen bruto de marzo, a dos o más herramientas de la organización con exactamente la misma pregunta. Si las cifras difieren, existen varias capas semánticas de hecho. Aplicada con método, se ejecuta sobre las métricas del comité de dirección en todas sus superficies y se clasifica cada discrepancia según su causa: definición, modelado u operación. Repetida cada trimestre, la proporción de métricas que pasan la prueba mide la salud de la capa semántica.
¿Qué es Apache Ossie (antes Open Semantic Interchange)?
Es una especificación abierta, con licencia Apache 2.0 y basada en YAML, para expresar métricas, dimensiones y sus relaciones en un formato neutral que pueda trasladarse entre herramientas y plataformas. Nació en septiembre de 2025 como Open Semantic Interchange, impulsada por Snowflake, Salesforce, dbt Labs y otras compañías; publicó su primera versión en enero de 2026 y en julio de 2026 entró en la incubadora de la Apache Software Foundation con el nombre de Apache Ossie.
El margen de marzo, otra vez
La capa semántica rara vez se decide de forma explícita. Casi siempre se hereda: de la primera herramienta que se compró, del equipo que modeló el primer informe y de la costumbre de copiar una fórmula cuando hace falta otra parecida. Por eso conviene hacer la prueba antes de la próxima reunión de dirección: pedir el margen bruto de marzo a cada herramienta en la que aparece, y anotar cuántas cifras distintas salen y cuánto tarda alguien en explicar por qué. Esa espera mide, con bastante precisión, lo que la organización paga cada mes por no haber decidido dónde viven sus métricas.
Decidido ese lugar, la siguiente pregunta es con qué herramientas se consumen. El capítulo 31 compara las plataformas de BI modernas, de Power BI, Tableau y Looker a las alternativas de código abierto, con un criterio que este capítulo deja preparado: antes de comparar visualizaciones, hay que saber qué herramienta puede consumir la capa semántica elegida y cuál pretende convertirse en la suya.
Siguiente en la Parte IV: capítulo 31, Herramientas BI modernas: Power BI, Tableau, Looker y alternativas open source. · Capítulo anterior: Estrategia de BI · Volver a la Parte IV · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 13 de octubre de 2026.
