
Capítulo 32 · Parte IV: Business Intelligence y consumo · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
Un dashboard eficaz es el que permite a una persona concreta responder una pregunta de negocio en pocos segundos y saber, en la misma mirada, qué tiene que hacer a continuación. Pregunta, respuesta y acción: si falta una de las tres, lo que hay en pantalla es decoración con datos. La definición trae una consecuencia poco intuitiva, y es que la mayor parte del trabajo que hace eficaz un cuadro de mando no se ve. Ocurre por debajo de la superficie, en cómo están agregados los datos, en qué resultados se guardan en caché y en cuántos milisegundos consume cada capa entre el clic y el gráfico. El capítulo anterior se ocupó de elegir la herramienta; este trata de lo que cualquier herramienta necesita para que su usuario no deje de abrirla.
En resumen. Un dashboard se diseña dos veces. En la superficie, con jerarquía visual, un mensaje principal legible en cinco segundos, comparación y umbral en cada KPI y una acción siguiente evidente. Por debajo, con un presupuesto de latencia: los segundos que tolera su usuario se reparten entre almacenamiento, consulta, red y presentación, y cada capa tiene su palanca —tablas de resumen, importación o extracción, caché de resultados, motores de serving analítico y menos elementos en pantalla—. El presupuesto se fija por dashboard, según la decisión que soporta, y se comprueba en el percentil 95 con la concurrencia real de la hora punta, no con un único usuario en la mesa de quien lo ha construido.
Pregunta, respuesta, acción: lo que separa un dashboard eficaz de un mural de gráficos
En 2004, Stephen Few propuso una definición que sigue citándose: un dashboard es una presentación visual de la información más importante para alcanzar uno o varios objetivos, reunida en una sola pantalla para poder controlarla de un vistazo. Dos décadas después, la idea de la pantalla única y la lectura rápida resiste bien. Lo que ha cambiado son las expectativas de quien mira. Ya no se conforma con controlar: espera actuar, a menudo desde el móvil, sobre datos de hace minutos y con una cifra que coincida con la del informe financiero.
Esa distancia entre lo que se diseña y lo que se espera explica una parte grande del desgaste del BI corporativo. Los dashboards no se abandonan por feos: se abandonan porque obtener la respuesta cuesta más que preguntarle a alguien. El coste se compone de varios sumandos que el usuario no separa, pero sí siente: lo que tarda en cargar, lo que tarda en encontrar el número que busca, lo que tarda en interpretarlo y la duda sobre si es el número correcto. Cuando la suma supera lo que cuesta enviar un mensaje al analista de turno, el cuadro de mando pierde la partida, y con él la adopción que el capítulo 29 situaba como la medida real del éxito del BI. La duda sobre la cifra se resuelve en la capa semántica, como explicó el capítulo 30; los otros tres sumandos son materia de este capítulo.
Un concepto ayuda a ordenar las decisiones de diseño. La densidad informativa es la cantidad de información útil para una decisión que ofrece un dashboard por unidad de superficie y de atención. No equivale al número de gráficos. Un velocímetro gigante que muestra un único porcentaje tiene densidad baja: ocupa mucho y dice poco. Cuarenta visuales apretados en una página tienen una densidad aparente altísima y una densidad útil casi nula, porque nadie es capaz de extraer de ellos una conclusión en el tiempo que está dispuesto a dedicarles.
Tres familias de dashboards según quién decide y cada cuánto
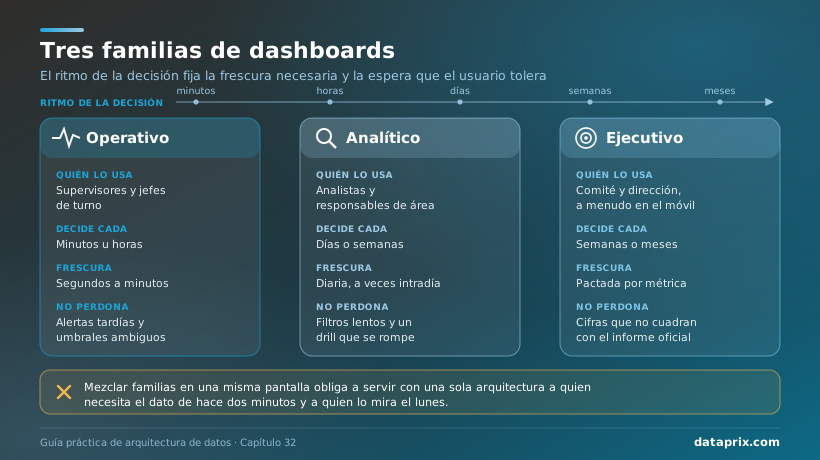
La primera decisión de diseño tiene que ver con el tipo de cuadro, antes que con su aspecto. Un dashboard operativo sigue un proceso que está ocurriendo —la cola de un almacén, el estado de una red, las incidencias de un turno— y lo usan supervisores que deciden en minutos u horas. Un dashboard analítico sirve para entender por qué se mueve una métrica: lo usan analistas y responsables de área, que filtran, comparan y bajan al detalle. Un dashboard ejecutivo resume la marcha del negocio para la dirección, con pocas métricas de definición única, frescura pactada y lectura frecuente en el móvil; el capítulo 36 lo convertirá en caso completo. Cada familia tolera esperas distintas y necesita una frescura distinta, y mezclarlas en la misma pantalla es el primer error de diseño, porque obliga a servir con la misma arquitectura a un jefe de turno que necesita el dato de hace dos minutos y a un consejero que lo mira el lunes.
| Familia | Pregunta típica | Ritmo de la decisión | Frescura razonable | Lo que no perdona |
|---|---|---|---|---|
| Operativo | ¿Qué está fallando ahora y dónde actúo? | Minutos u horas | Segundos a minutos | Alertas tardías y umbrales ambiguos |
| Analítico | ¿Por qué ha cambiado esta métrica? | Días o semanas | Diaria, a veces intradía | Filtros lentos y drill que se rompe |
| Ejecutivo | ¿Cómo va la compañía frente al objetivo? | Semanas o meses | Pactada por métrica | Cifras que no cuadran con el informe oficial |
Tabla orientativa: los rangos son cualitativos y dependen de cada proceso de negocio.
La superficie: cinco decisiones de diseño anteriores a cualquier gráfico
Elegir entre barras y líneas llega al final. Antes hay cinco decisiones que determinan si el cuadro se entiende, y todas se pueden tomar con papel y lápiz.
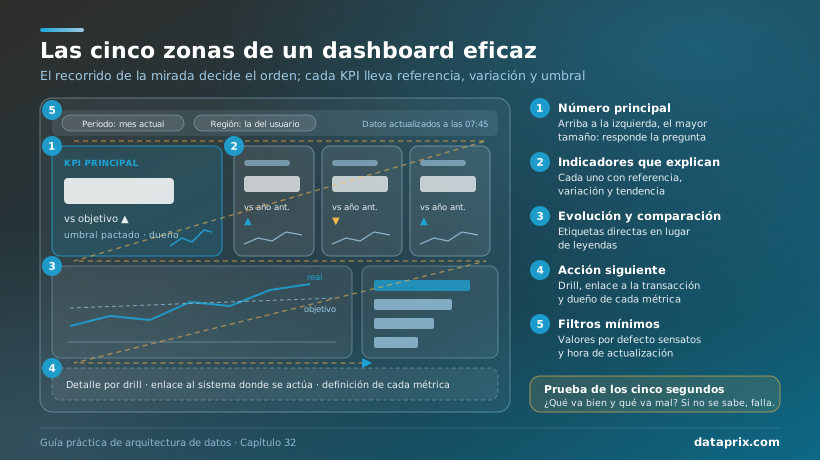
La primera es la jerarquía visual. En las culturas que leen de izquierda a derecha y de arriba abajo, la vista entra por la esquina superior izquierda y recorre la pantalla en zigzag. Ahí va el número que responde la pregunta principal, con el mayor tamaño de la página; debajo, los indicadores que lo explican; al final, o detrás de un clic, el detalle. Cuando todo tiene el mismo tamaño y el mismo peso, el usuario tiene que construir la jerarquía por su cuenta, y eso es exactamente el trabajo que el dashboard debía ahorrarle.
La segunda es el mensaje en cinco segundos. La prueba es sencilla y desarma muchas discusiones de diseño: se enseña el dashboard durante cinco segundos a alguien del público al que va dirigido, se oculta y se le pregunta qué va bien y qué va mal. Si no sabe contestar, la jerarquía ha fallado, por muy correctos que sean los datos. La prueba de los cinco segundos procede del diseño de interfaces y funciona igual de bien con cuadros de mando.
La tercera, y la que más se incumple, es el contexto en cada KPI. Un número solo no es información. Las ventas de la semana valen algo cuando se comparan con el objetivo, con la misma semana del año anterior o con la previsión, y cuando un umbral pactado dice a partir de qué desviación hay que preocuparse. Cada indicador de un cuadro bien diseñado lleva cinco elementos: el valor, una referencia, la variación frente a ella, el umbral y, si cabe, una pequeña línea de tendencia. Los semáforos sin umbral acordado por el dueño de la métrica son opinión pintada de rojo, y generan más reuniones que decisiones.
La cuarta es la acción siguiente. Si un indicador se pone en rojo, el usuario tiene que saber qué hacer sin salir del cuadro: bajar al detalle que explica la desviación, saltar a la transacción del sistema operativo donde se corrige o, como mínimo, saber quién es el dueño del indicador. Es la traducción visual de los atributos de producto de datos del capítulo 29, y conviene que el propio dashboard muestre la definición de cada métrica, enlazada a la capa semántica, para que la pregunta «¿esto incluye devoluciones?» se responda con un clic y no con un correo.
La quinta se resume en menos elementos, mejor elegidos. Las barras comparan categorías; las líneas cuentan evoluciones; las tablas sirven cuando el usuario necesita el valor exacto. Las tartas con muchas porciones, los efectos tridimensionales y los velocímetros consumen superficie sin añadir lectura. El color se reserva para significar —un acento para lo que exige atención sobre una base neutra— y las etiquetas directas sustituyen a las leyendas que obligan a mirar dos veces. Los filtros, pocos, visibles y con valores por defecto sensatos: un dashboard que se abre mostrando «todas las regiones, todos los años» obliga a cada usuario a repetir los mismos cuatro clics cada mañana, y además lanza la consulta más cara posible.
Móvil y accesibilidad: el mismo cuadro con otras condiciones de lectura
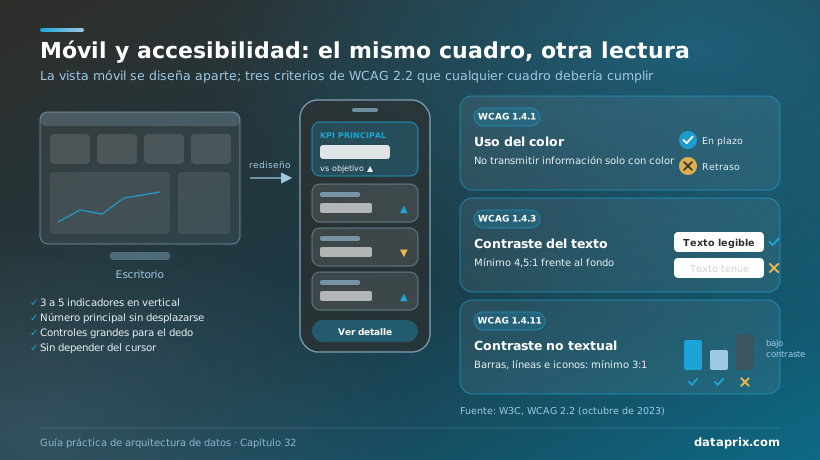
El consumidor ejecutivo de la matriz del capítulo 31 consulta buena parte de sus indicadores en el teléfono, entre reuniones y con una conexión variable. Diseñar para el monitor de 27 pulgadas y confiar en que la herramienta reduzca la página produce gráficos ilegibles y filtros imposibles de pulsar con el dedo. Las herramientas principales permiten construir una vista móvil específica —el diseño móvil de los informes de Power BI, los diseños por dispositivo de Tableau, los paneles adaptables de Qlik o de Looker— y conviene usarla como lo que es: otra pieza de diseño, con tres a cinco indicadores en vertical, sin gráficos que necesiten pasar el cursor por encima para entenderse y con el número principal visible sin desplazarse.
La accesibilidad sigue el mismo razonamiento. Las pautas WCAG 2.2, publicadas por el W3C en octubre de 2023, contienen tres criterios que afectan de lleno a cualquier cuadro de mando: la información no puede transmitirse solo con el color (criterio 1.4.1), el texto necesita un contraste mínimo de 4,5:1 con el fondo (1.4.3) y los elementos gráficos que hay que distinguir —barras, líneas, iconos de estado— necesitan al menos 3:1 (1.4.11). Un semáforo que solo cambia de verde a rojo deja fuera a una parte nada desdeñable de los usuarios, los que tienen alteraciones en la percepción del color; añadir un icono o una palabra al estado lo resuelve sin coste.
Riesgo normativo. En los cuadros de mando internos, la accesibilidad es una buena práctica. Deja de serlo cuando el dashboard se publica en la web o en la aplicación de un organismo público, sujetas al Real Decreto 1112/2018, o cuando forma parte de un servicio al consumidor incluido en la Ley 11/2023, que traspone el Acta Europea de Accesibilidad y cuyas obligaciones se aplican con carácter general desde el 28 de junio de 2025, con un régimen transitorio que hay que revisar caso por caso. El panel de consumo de una aplicación de banca para particulares o el portal de transparencia de un ayuntamiento entran en ese terreno. Antes de publicar analítica dirigida a ciudadanos o clientes conviene validar el encaje con la asesoría jurídica; este capítulo no sustituye ese análisis.
El presupuesto de latencia: los segundos que tolera el usuario, repartidos por capas
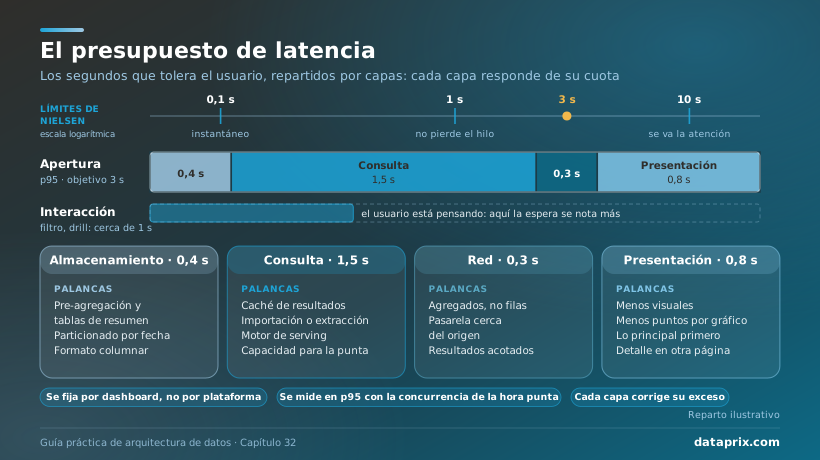
Jakob Nielsen formuló en 1993 tres límites de tiempo de respuesta que siguen siendo la referencia del diseño de interfaces, recogidos en el artículo de Nielsen Norman Group: una décima de segundo se percibe como instantánea; hasta un segundo, el usuario nota la espera pero no pierde el hilo; a partir de unos diez segundos, la atención se va a otra parte. Un dashboard tiene sus particularidades, pero quien lo abre es la misma persona, con la misma paciencia.
El presupuesto de latencia es el tiempo máximo aceptable entre una acción del usuario —abrir el cuadro, aplicar un filtro, bajar al detalle— y la respuesta visual completa, expresado en un percentil alto y repartido de forma explícita entre las capas que lo consumen. El reparto es lo que lo convierte en herramienta de ingeniería. Si el objetivo es que el cuadro abra en tres segundos y nadie ha decidido cuántos corresponden a cada capa, cada equipo optimiza lo suyo y nadie responde del total. Con el reparto escrito, cuando una capa se pasa de su cuota se corrige en esa capa, sin pedir a las demás que compensen.
Las capas son cuatro. El almacenamiento es la lectura física de los datos: cuánto hay que escanear, en qué formato y con qué granularidad. Sus palancas son la pre-agregación, el particionado por fecha y el formato columnar, que el capítulo 10 trató al separar cargas OLTP y OLAP. La consulta incluye el cálculo del motor y, sobre todo, la espera en cola cuando hay muchos usuarios a la vez; sus palancas son la caché de resultados, la importación o extracción de los datos al motor de la herramienta, un motor de serving y una capacidad dimensionada para la hora punta. La red suma el paso por la pasarela hacia los orígenes locales, la distancia y el tamaño de lo que viaja; se reduce devolviendo agregados en lugar de filas. La presentación es el tiempo que el navegador o la aplicación tardan en dibujar: número de visuales, puntos por gráfico, cálculos en el cliente y componentes visuales de terceros. Esta última capa se gobierna con diseño, y es la que más a menudo se olvida cuando se habla de rendimiento.
Conviene distinguir dos tiempos. La apertura es la primera carga del cuadro y admite algo más de margen si el número principal aparece primero y el resto se completa después. La interacción —filtrar, cambiar de periodo, bajar al detalle— debería acercarse al umbral del segundo, porque es ahí donde el usuario está pensando. A modo de ejemplo ilustrativo, un cuadro ejecutivo con una apertura de tres segundos en el percentil 95 podría repartirlos así: algo menos de un segundo para la presentación, unas décimas para la red, en torno a un segundo y medio para la consulta y el resto para el almacenamiento. Las cifras concretas importan menos que la existencia del reparto y que se midan con la concurrencia de la hora en que el cuadro se usa de verdad.
Criterio de decisión. El presupuesto de latencia se fija por dashboard, no por plataforma, y se deriva de la decisión que soporta: un cuadro operativo que dispara una intervención necesita interacciones cercanas al segundo y datos de minutos; uno ejecutivo semanal tolera una apertura algo más lenta y datos del día anterior. Se expresa en el percentil 95, al estilo de los SLO del capítulo 5, y se reparte por capas antes de construir. Si nadie sabe qué decisión depende de un panel, no hay presupuesto que fijar: hay un candidato a retirar.
Las palancas por debajo: agregados, modos de conexión, caché y motores de serving
Con el presupuesto escrito, la pregunta pasa a ser qué palanca usar en cada capa. Hay cuatro familias, y casi todos los problemas de rendimiento de un dashboard se resuelven combinando dos o tres de ellas.
Pre-agregar lo que se pregunta siempre
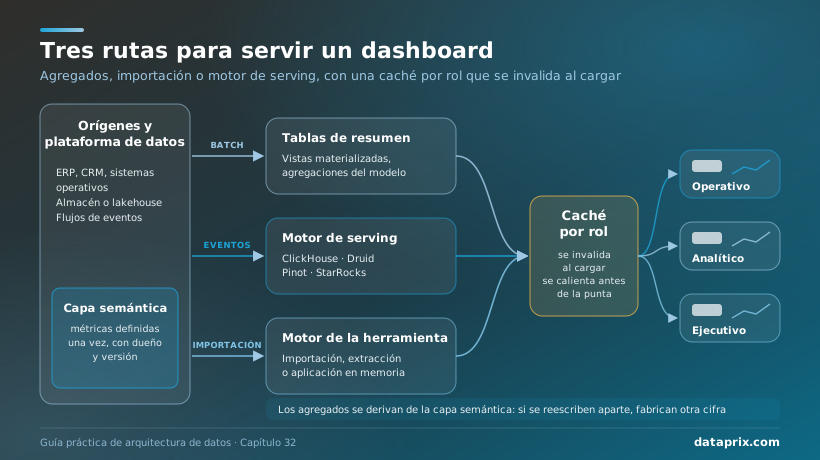
La pre-agregación consiste en calcular y almacenar de antemano el resultado de las consultas que el dashboard repite, a la granularidad que necesita. Si el cuadro muestra ventas por día, tienda y familia de producto, no tiene sentido que cada apertura recorra cientos de millones de líneas de ticket: una tabla de resumen con esa granularidad responde lo mismo leyendo una fracción de los datos. Las formas de hacerlo son variadas. Las vistas materializadas de los almacenes y de motores como ClickHouse, que en su variante incremental se actualizan al insertar; las agregaciones definidas por el usuario de Power BI, que el motor usa de forma transparente cuando la consulta cabe en ellas; o la aggregate awareness de Looker, que elige la tabla agregada más pequeña capaz de responder.
Dos cautelas evitan que la palanca se vuelva contra quien la usa. La primera es que los agregados tienen que derivarse de las definiciones de la capa semántica, no reescribirse aparte: una tabla de resumen con su propia lógica de devoluciones es la manera más rápida de fabricar una tercera cifra para la misma métrica. La segunda es que hay métricas que no se pueden sumar. Los recuentos distintos, los porcentajes y los percentiles no se obtienen agregando agregados: hay que guardar los componentes —numerador y denominador— o estructuras aproximadas como HyperLogLog para los recuentos distintos, que la mayoría de los motores analíticos ya ofrece.
Copiar o preguntar: importación, extracción y consulta directa
Cada herramienta de BI ofrece dos maneras de llegar a los datos, con nombres distintos. En el modo de importación o extracción, la herramienta copia los datos comprimidos en su propio motor y los refresca según un calendario; gana velocidad e independencia del origen, y paga con frescura limitada al último refresco, límites de tamaño y una copia más que gobernar. En la consulta directa —live query, DirectQuery o conexión en vivo—, cada interacción genera SQL contra el origen; gana frescura y una sola copia, y paga con la dependencia de la capacidad del almacén y con su factura de cómputo, el coste trasladado que el capítulo 31 pedía medir durante la evaluación. Entre ambos extremos han aparecido modos híbridos, como los modelos compuestos o la lectura directa de tablas Delta sin importarlas.
| Herramienta | Copia de datos | Consulta al origen | Agregados y caché |
|---|---|---|---|
| Power BI / Fabric | Importación | DirectQuery; Direct Lake lee tablas Delta de OneLake sin importarlas | Modo dual y modelos compuestos, agregaciones definidas por el usuario, caché de consultas en capacidades Premium y Fabric |
| Tableau | Extracciones en formato Hyper | Conexión en vivo | Extracciones agregadas y filtradas, refrescos incrementales |
| Looker | Tablas derivadas persistentes en el propio almacén | Siempre SQL contra el almacén | Caché de una hora por defecto, datagroups ligados a la carga, aggregate awareness |
| Qlik Cloud Analytics | Aplicaciones en memoria con el motor asociativo | Direct Query sobre bases de datos en la nube compatibles | Recargas programadas, modelos en memoria |
| Apache Superset | No copia datos | SQL contra el origen | Caché de datos de gráficos (Redis recomendado), consultas asíncronas y calentamiento de caché |
| Metabase | Persistencia de modelos en el propio origen | SQL contra el origen | Políticas de caché por pregunta, panel o base de datos; las de duración y calendario, en los planes Pro y Enterprise |
Situación a octubre de 2026 según la documentación de cada fabricante. Los nombres y los límites de cada modo cambian con frecuencia: conviene comprobarlos antes de diseñar.
La regla práctica es elegir por la familia del dashboard y no por costumbre. Un cuadro ejecutivo leído por cientos de personas con datos del día anterior es territorio natural de la importación o la extracción. Uno operativo que necesita el dato de hace cinco minutos sobre un volumen grande pide consulta directa, pero contra algo preparado para recibirla: tablas agregadas, un motor de serving o, como mínimo, un almacén con capacidad reservada para esa carga.
Caché: tres niveles y una pregunta incómoda sobre cuándo caduca
La caché existe en tres niveles. En la herramienta de BI, que guarda el resultado de consultas idénticas: Looker lo hace durante una hora por defecto y permite atar la caducidad a la carga de datos mediante datagroups; Superset mantiene una caché de datos de gráficos configurable por gráfico, conjunto de datos o base de datos; Metabase ofrece políticas por duración, por calendario o adaptativas según el tiempo de ejecución; Power BI cachea consultas en las capacidades de pago. En el almacén o motor, que reutiliza resultados recientes si los datos no han cambiado. Y en la capa de aplicación —Redis, una CDN—, útil sobre todo en analítica embebida o pública, con los criterios que ya desarrolló el capítulo 13.
La pregunta incómoda es cuándo caduca. Una caché con caducidad fija de una hora sirve datos viejos durante cincuenta y nueve minutos si la carga termina justo después del último refresco, y desperdicia trabajo si los datos solo cambian una vez al día. Lo correcto es invalidar al terminar la carga, que es para lo que sirven los disparadores ligados al proceso de integración, y calentar la caché a continuación, lanzando las consultas de los cuadros más usados antes de que llegue el primer usuario. Así, quien abre el cuadro a las nueve no paga la consulta en frío de toda la organización.
Hay un tercer matiz, de seguridad. Cuando el dashboard aplica seguridad por filas, la misma consulta devuelve resultados distintos según quién la lanza, y la caché tiene que distinguir por usuario o por rol. Una caché compartida entre roles con permisos diferentes equivale a una fuga de datos con buen tiempo de respuesta.
Motores de serving analítico: cuando el almacén no está hecho para tanta concurrencia
Un motor de serving analítico es una base de datos columnar diseñada para responder consultas agregadas en milisegundos con cientos o miles de consultas simultáneas, a menudo sobre datos que llegan en flujo continuo. Es una categoría distinta del almacén de datos, optimizado para consultas grandes y menos frecuentes. ClickHouse, cuya rama de soporte largo más reciente es la 26.8, combina velocidad de escaneo y vistas materializadas incrementales. Apache Druid y Apache Pinot, ambos de la Apache Software Foundation, están pensados para ingerir eventos en tiempo casi real y servir analítica de cara al usuario con mucha concurrencia; Pinot publicó su versión 1.5 en 2026. StarRocks juega en el mismo terreno. En el extremo opuesto, DuckDB, que estrenó su versión 2.0 de soporte largo el 21 de octubre de 2026, se ejecuta dentro del propio proceso y resuelve con mucha eficiencia volúmenes medianos, y lo usan herramientas de cuadros de mando como código y servicios gestionados que lo llevan a la nube.
La valoración editorial es que estos motores compensan en dos situaciones: analítica dirigida a clientes o socios, donde la concurrencia la marca el número de clientes —el terreno de la analítica embebida del capítulo 35—, y cuadros operativos con datos de segundos sobre volúmenes grandes. Para treinta directivos que miran un cuadro semanal son una sobreingeniería: otro sistema que operar, otra copia que vigilar y otro lugar donde las métricas pueden empezar a divergir.
Frescura: cuándo el tiempo real sobra y cuándo es la mitad del valor
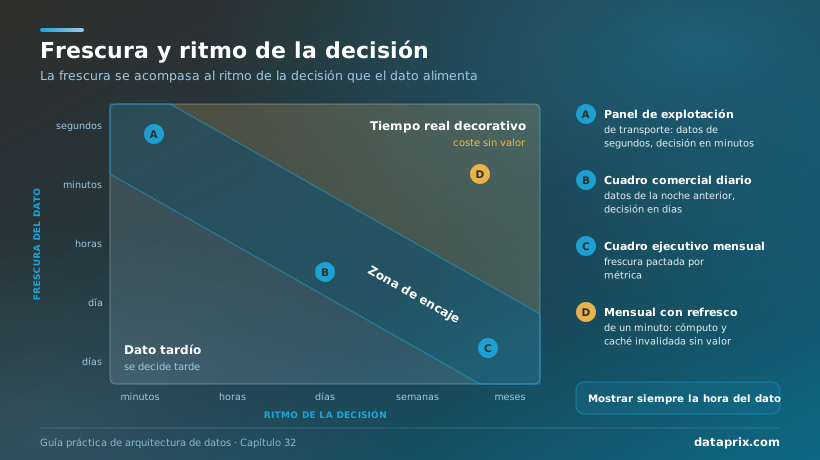
La latencia de la consulta y la frescura del dato se confunden con frecuencia, y no son lo mismo. La primera mide cuánto espera el usuario; la segunda, cuánto tiempo ha pasado desde que ocurrió lo que el cuadro muestra. Un panel puede abrir en un segundo con datos de ayer, o tardar ocho con datos de hace un minuto. El capítulo 19 desarrolló el coste de la latencia en la integración; aplicado al consumo, la regla cabe en una línea: la frescura debe acompasarse al ritmo de la decisión que el dato alimenta.
Cuando la frescura supera lo que la decisión necesita aparece el tiempo real decorativo: un cuadro de seguimiento mensual que se refresca cada minuto. Su coste es real —cómputo continuo, pasarelas saturadas, cachés que se invalidan antes de servir una sola vez y que, paradójicamente, hacen más lento el cuadro— y su valor, nulo, porque nadie va a cambiar una decisión mensual por lo que pasó en los últimos sesenta segundos. En sentido contrario, un cuadro de explotación con datos de la noche anterior llega tarde a todo lo que importa. La solución es pactar la frescura por métrica, con el mismo rigor que el capítulo 24 aplicaba a los acuerdos de servicio de calidad, y mostrar siempre en pantalla la hora de la última actualización. Ese pequeño texto ahorra muchas llamadas y genera una confianza que ningún gráfico consigue.
El presupuesto aplicado: cuatro escenarios sectoriales
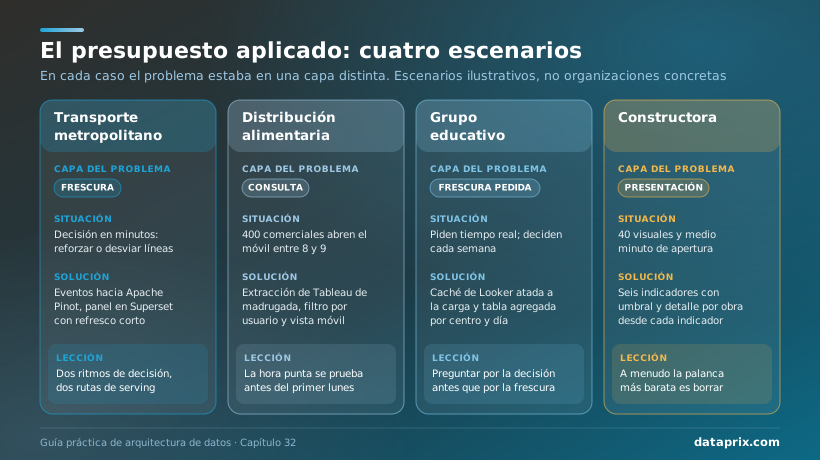
Los cuatro escenarios siguientes son ilustrativos: combinan situaciones habituales en cada sector y no describen organizaciones concretas. Las cifras son órdenes de magnitud.
Transporte metropolitano: cuando la frescura sí lo es todo. Un operador de metro y autobús quiere un panel de explotación que muestre, por línea y franja, la ocupación estimada a partir de las validaciones de billetes y las incidencias en curso. La decisión que soporta —reforzar una línea, desviar autobuses, avisar a los viajeros— se toma en minutos, así que el presupuesto pide datos de menos de un minuto e interacciones cercanas al segundo para unas decenas de usuarios del centro de control. El equipo descarta la consulta directa contra el almacén, que se carga por lotes cada hora, y lleva los eventos de validación por un bus de mensajería —Pulsar, Redpanda o el servicio gestionado de su nube— hasta Apache Pinot, que agrega por línea y por intervalo de cinco minutos al ingerir. Apache Superset dibuja el panel con refresco automático y caché corta. El mismo operador mantiene un cuadro mensual para el consejo de administración que se alimenta del almacén con datos del día anterior. Lección: la misma organización necesita dos arquitecturas de serving porque tiene dos ritmos de decisión, y forzar una sola encarece las dos.
Distribución alimentaria: la hora punta de las ocho de la mañana. Una distribuidora mayorista tiene unos cuatrocientos comerciales que consultan en el móvil, antes de empezar la ruta, las ventas y cobros pendientes de sus clientes. El dashboard se diseñó en consulta en vivo contra el almacén y funcionaba bien en las pruebas, con tres usuarios. El primer lunes en producción, la concurrencia entre las ocho y las nueve multiplicó los tiempos de apertura hasta hacerlo inutilizable. La solución combina una extracción de Tableau en formato Hyper, refrescada de madrugada y con una carga incremental a primera hora, filtros por usuario para que cada comercial vea solo su cartera y un diseño específico para teléfono con cuatro indicadores. Lección: la concurrencia de la hora punta es un requisito de diseño, y se prueba antes del primer lunes.
Grupo educativo privado: el tiempo real que nadie necesitaba. Un grupo con una veintena de colegios pide para la campaña de admisiones un cuadro «en tiempo real» de solicitudes por centro y etapa. Al preguntar qué decisión depende de él, la respuesta es la apertura de nuevas aulas y el refuerzo de las jornadas de puertas abiertas, que se deciden semanalmente. El presupuesto queda en datos actualizados dos veces al día y aperturas de pocos segundos. Sobre Looker, la caché se ata con un datagroup al final de cada carga y una tabla agregada por centro, etapa y día responde la mayoría de las consultas. Lección: preguntar por la decisión antes que por la frescura convierte un proyecto de streaming en una configuración de caché.
Constructora: la sábana de cuarenta visuales. Una empresa con obras en varias provincias tiene un cuadro de cartera de proyectos que reúne en una sola página certificaciones, costes, plazos, seguridad y personal: cuarenta elementos, una veintena de filtros y cerca de medio minuto de apertura. El análisis del presupuesto revela que la mitad del tiempo se va en la presentación, no en la consulta. El rediseño deja una página de resumen con seis indicadores —desviación de coste, desviación de plazo, margen previsto, certificación pendiente, incidencias de seguridad y obras en alerta—, cada uno con su umbral, y lleva el resto a páginas de detalle por obra a las que se llega desde el propio indicador. La apertura baja a pocos segundos sin tocar el almacén. Lección: antes de comprar capacidad conviene medir dónde se va el tiempo; a menudo la palanca más barata es borrar.
Probar el rendimiento antes de que lo pruebe el comité de dirección
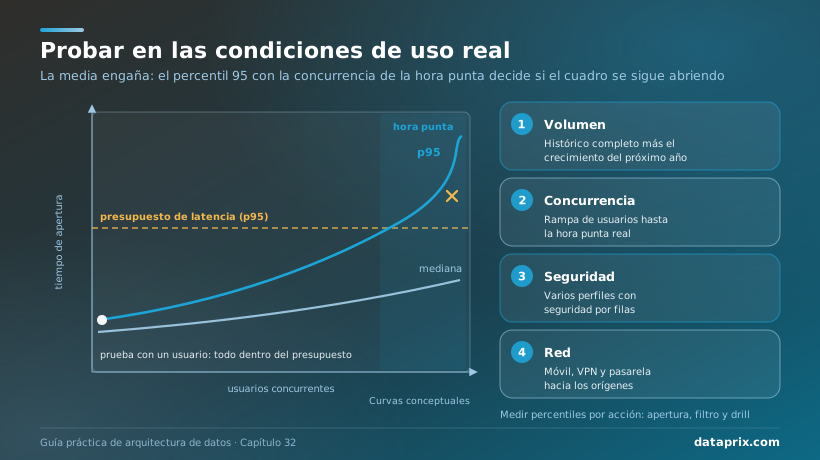
La prueba típica de un dashboard la hace una sola persona, con una muestra de datos, desde la red de la oficina y con permisos de administrador. La realidad llega con el histórico completo, trescientos usuarios en la misma media hora, teléfonos con cobertura irregular y seguridad por filas, que cambia los planes de consulta y reduce el aprovechamiento de la caché. Por eso una prueba de rendimiento útil reproduce cuatro condiciones: volumen real, con el crecimiento previsto para el próximo año; concurrencia de la hora punta, con una rampa de usuarios y no un único golpe; contexto de seguridad real, con usuarios de distintos perfiles; y red realista, incluida la conexión móvil o la VPN. El resultado se expresa en percentiles por acción —apertura, filtro, bajada al detalle— y se compara con el presupuesto, en línea con la idea de medir percentiles y no promedios que el capítulo 6 aplicaba a la plataforma.
Las herramientas ayudan a encontrar dónde se va el tiempo: el analizador de rendimiento de Power BI, la grabación de rendimiento de Tableau o la actividad del sistema de Looker desglosan cada visual y cada consulta, y los registros de Superset y Metabase permiten lo mismo con algo más de trabajo. Para la concurrencia hacen falta generadores de carga o navegadores automatizados, y aquí hay un detalle práctico: algunos fabricantes publican utilidades de prueba de carga para su servicio y otros limitan este tipo de pruebas en sus condiciones de uso. Conviene leerlas antes de lanzar quinientos usuarios sintéticos contra un servicio en la nube. Una vez en producción, la latencia de los cuadros más usados se incorpora a la observabilidad de la plataforma, con alertas cuando el percentil 95 rebasa el presupuesto, y los cambios del modelo semántico pasan por las pruebas de regresión que el capítulo 26 describía para los pipelines.
Anti-patrones: cuando abrir un panel cuesta más que preguntar a un compañero
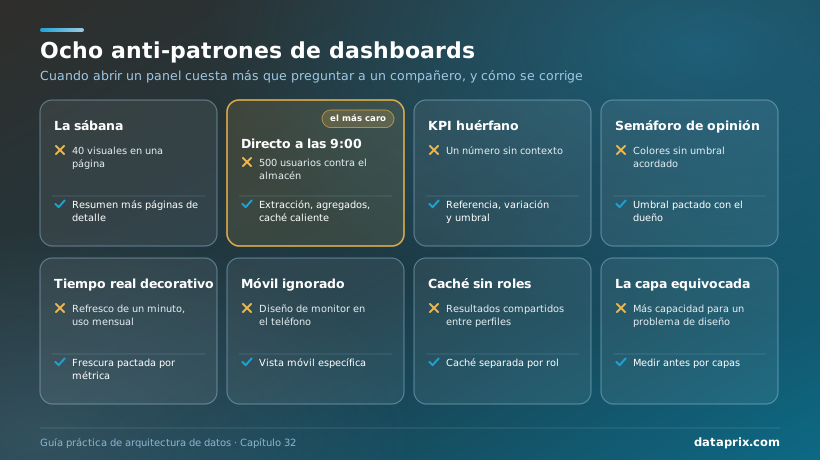
La sábana. Cuarenta visuales en una página, porque cada departamento pidió el suyo y nadie se atrevió a decir que no. El resultado es un cuadro lento en la capa de presentación e ilegible en la superficie. Se corrige con una página de resumen y páginas de detalle, y con alguien que tenga autoridad para decidir qué entra.
El anti-patrón más caro: consulta en directo contra el almacén para quinientos usuarios a las nueve. Funciona en las pruebas y se hunde el primer día laborable. Cada apertura lanza decenas de consultas, las colas del almacén se llenan, los tiempos se disparan y la factura de cómputo crece con cada usuario que pulsa «actualizar» porque cree que el cuadro se ha colgado. El coste se reparte entre una mala experiencia y un gasto que nadie había previsto, cuyo reparto entre áreas es materia del capítulo de FinOps de la Parte VI. La alternativa combina importación o extracción para los cuadros de consumo masivo, tablas agregadas, caché invalidada al cargar y calentada antes de la hora punta, y una capacidad dimensionada con la prueba de concurrencia.
El KPI huérfano. Un número enorme sin objetivo, sin periodo de comparación y sin umbral. Obliga al usuario a recordar cuánto era el mes pasado, y nadie lo recuerda. El semáforo de opinión es su pariente: verde, ámbar y rojo sin un umbral pactado con el dueño de la métrica, de modo que cada reunión empieza discutiendo los colores.
El tiempo real decorativo. Refrescos de un minuto en cuadros que soportan decisiones mensuales. Encarece la plataforma y, al invalidar la caché sin descanso, empeora justo lo que pretendía mejorar. Ignorar el móvil del directivo es el error simétrico en la superficie: el cuadro se diseña para el monitor y se consulta en el teléfono, donde los filtros no se pueden pulsar y los gráficos necesitan pasar el cursor por encima.
La caché sin roles. Resultados cacheados compartidos entre perfiles con seguridad por filas distinta. Es raro, pero cuando ocurre se convierte en un incidente de protección de datos. Por último, optimizar la capa equivocada: ampliar la capacidad del almacén cuando el tiempo se va en dibujar cuarenta visuales, o rediseñar la página cuando el problema es una consulta sin agregados. El presupuesto por capas existe para evitarlo.
Selección de software: seis preguntas de rendimiento para la demostración
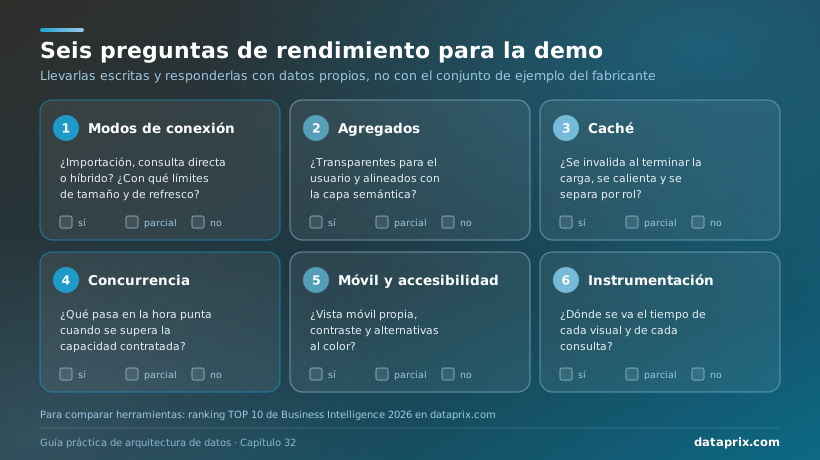
El capítulo 31 ordenó la elección de herramienta por consumidor y por coste por usuario activo. El rendimiento añade seis preguntas que conviene llevar escritas a cualquier demostración y responder con datos propios, no con el conjunto de ejemplo del fabricante. La primera, qué modos de conexión ofrece y con qué límites de tamaño, frecuencia de refresco y funciones disponibles en cada uno. La segunda, si admite agregados transparentes para el usuario y cómo garantiza que respetan las definiciones de la capa semántica. La tercera, cómo se controla la caché: si puede invalidarse al terminar la carga, calentarse y separarse por rol. La cuarta, qué ocurre con la concurrencia: en los modelos por capacidad, cómo se comporta la plataforma cuando se supera lo contratado, porque las capacidades compartidas aplican limitaciones que se notan precisamente en la hora punta. La quinta, cómo resuelve el móvil y la accesibilidad: vistas específicas, contraste, alternativas al color. Y la sexta, qué instrumentación trae para saber dónde se va el tiempo de cada visual y de cada consulta.
El ranking de herramientas de Business Intelligence de 2026 del directorio de Dataprix recoge el veredicto editorial de cada opción, encabezado por Microsoft Power BI, Tableau, Qlik Sense y Looker, seguidos por SAP Analytics Cloud, Oracle Analytics Cloud y Domo. En la valoración editorial, las cuatro primeras cubren con solvencia las seis preguntas, cada una con su enfoque: Power BI y Qlik apoyan el rendimiento en sus motores en memoria; Tableau, en las extracciones; Looker, en el almacén y en su gestión de la caché y los agregados. Superset y Metabase resuelven bien el consumo interno si alguien opera la caché y la base de datos que tienen detrás. Los motores de serving merecen una prueba propia, con los datos y la concurrencia de la organización, antes de incorporar un sistema más a la plataforma.
Checklist operativo: antes de publicar un dashboard
- Escribir la pregunta de negocio, el público y la decisión que soporta el cuadro; si no hay decisión, no se publica.
- Clasificar el dashboard como operativo, analítico o ejecutivo, sin mezclar familias en la misma pantalla.
- Fijar el presupuesto de latencia en el percentil 95 para la apertura y para la interacción, y repartirlo entre almacenamiento, consulta, red y presentación.
- Pactar con el dueño de cada métrica la frescura necesaria y mostrar en pantalla la hora de la última actualización.
- Dar a cada KPI referencia, variación, umbral pactado y acción siguiente, y enlazar su definición en la capa semántica.
- Pasar la prueba de los cinco segundos con usuarios reales del público al que va dirigido.
- Diseñar la vista móvil aparte y comprobar contraste y alternativas al color con los criterios de WCAG 2.2.
- Elegir el modo de conexión por familia y volumen, y crear tablas agregadas derivadas de la capa semántica para las consultas repetidas.
- Invalidar la caché al terminar la carga, calentarla antes de la hora punta y separarla por rol cuando haya seguridad por filas.
- Probar con volumen, concurrencia, perfiles de seguridad y red reales, y medir percentiles por acción.
- Incorporar la latencia de los cuadros más usados a la observabilidad, con alerta cuando superen el presupuesto.
- Revisar el uso cada trimestre y retirar o rediseñar los cuadros que nadie abre.
Formación recomendada
Para los equipos que diseñan o revisan cuadros de mando, estas opciones en español cubren la parte de superficie y la construcción práctica sobre las herramientas más extendidas:
- Conceptos de diseño de paneles (DataCamp): curso básico de unas dos horas sobre estructura de un dashboard, elección de métricas, análisis visual, tipos de paneles y cómo medir su rendimiento. Independiente de la herramienta.
- Creación de paneles en Tableau (DataCamp): curso básico de unas tres horas que recorre contenedores, acciones, elementos explicativos y la adaptación del panel a dispositivos móviles.
- Data Analytics con SQL Server y Power BI (Udemy): recorrido práctico de extremo a extremo, de la base de datos al informe, útil para entender cómo afecta el modelo de datos al rendimiento del cuadro.
Enlaces de afiliado: Dataprix puede recibir una comisión si contratas a través de ellos.
Recursos y lecturas recomendadas
- Stephen Few, Information Dashboard Design (2.ª edición, Analytics Press, 2013): la referencia clásica sobre diseño de cuadros de mando para la lectura de un vistazo. Su biblioteca de artículos en Perceptual Edge es de acceso libre.
- Steve Wexler, Jeffrey Shaffer y Andy Cotgreave, The Big Book of Dashboards (Wiley, 2017): una colección de casos reales de dashboards comentados, con lo que funciona y lo que no en cada uno.
- Cole Nussbaumer Knaflic, Storytelling with Data (Wiley, 2015): contexto, jerarquía y eliminación de ruido visual, aplicables a cualquier cuadro.
- Jakob Nielsen, Response Time Limits (Nielsen Norman Group): los tres umbrales de tiempo de respuesta que sustentan el presupuesto de latencia.
- W3C, Pautas de Accesibilidad para el Contenido Web (WCAG) 2.2 y la explicación del criterio 1.4.1, uso del color.
- Documentación de rendimiento de los fabricantes: la guía de optimización para Power BI y sus modos de almacenamiento, Optimizar el rendimiento de los libros de trabajo de Tableau, caché y datagroups de Looker, la configuración de caché de Apache Superset y las políticas de caché de Metabase.
- TOP 10 Software de Business Intelligence y Analítica en 2026 (Dataprix): el ranking editorial del directorio, con las fichas de cada herramienta.
Preguntas frecuentes
¿Qué es un dashboard eficaz?
Es el que permite a un público concreto responder una pregunta de negocio en pocos segundos y saber qué hacer a continuación. Combina una superficie bien diseñada —jerarquía visual, contexto y umbral en cada indicador, acción siguiente clara— con un rendimiento que respeta un presupuesto de latencia fijado según la decisión que soporta. Si obtener la respuesta en el cuadro cuesta más que preguntarle a un compañero, el dashboard deja de usarse.
¿Cuánto debe tardar en cargar un dashboard?
Depende de la decisión que soporta, pero los límites de tiempo de respuesta de Jakob Nielsen dan la referencia: hasta un segundo el usuario no pierde el hilo y a partir de unos diez su atención se va. Las interacciones —filtrar, bajar al detalle— deberían acercarse al segundo, y la apertura puede tomar unos pocos segundos si el número principal aparece primero. Lo importante es fijar el objetivo en el percentil 95, con la concurrencia real de la hora punta, y repartirlo entre almacenamiento, consulta, red y presentación.
¿Es mejor importar los datos o consultar en directo desde el dashboard?
Depende de la familia del cuadro. La importación o extracción da velocidad e independencia del origen y encaja con cuadros de consumo masivo con datos del día anterior. La consulta directa ofrece frescura y una sola copia, pero traslada la carga y el coste al almacén y sufre con mucha concurrencia. Los cuadros operativos con datos de minutos necesitan consulta directa contra algo preparado para recibirla, como tablas agregadas o un motor de serving analítico.
¿Cuándo hace falta un motor como ClickHouse, Druid o Pinot para servir dashboards?
Cuando hay mucha concurrencia y poca tolerancia a la espera: analítica dirigida a clientes o socios, donde los usuarios se cuentan por miles, y cuadros operativos con datos de segundos sobre volúmenes grandes. Para cuadros internos con decenas de usuarios y datos diarios suele bastar con importación, tablas agregadas y caché. Un motor de serving añade un sistema que operar y una copia más que mantener alineada con la capa semántica.
¿Cuántos gráficos debe tener un dashboard?
Los que permitan entender el mensaje principal en cinco segundos, que en la práctica suelen ser pocos. Una página de resumen con un puñado de indicadores, cada uno con su referencia y su umbral, y páginas de detalle accesibles desde ellos funcionan mejor que una sola página con decenas de visuales, que además penaliza el rendimiento en la capa de presentación.
¿Cómo se prueba el rendimiento de un dashboard antes de publicarlo?
Reproduciendo las condiciones reales: el volumen completo de datos con el crecimiento previsto, la concurrencia de la hora punta con una rampa de usuarios, varios perfiles con seguridad por filas y la red que usarán, incluida la móvil. Se miden percentiles por acción y se comparan con el presupuesto de latencia. Las herramientas de diagnóstico de cada fabricante indican qué visual o qué consulta consume el tiempo, y conviene revisar sus condiciones antes de lanzar pruebas de carga contra un servicio en la nube.
Un cronómetro como herramienta de diseño
Hay un ejercicio que cuesta media hora y suele ser revelador. El próximo lunes, a la hora en que más gente abre los cuadros, alguien del equipo de datos toma un teléfono con la red móvil, abre los tres dashboards más usados de la organización y anota tres cosas: cuánto tarda cada uno en mostrar el número principal, si se entiende en cinco segundos qué va bien y qué va mal, y si la pantalla dice de cuándo son los datos. Después compara lo anotado con el presupuesto de latencia de cada cuadro. En muchas organizaciones, el hallazgo más frecuente es la constatación de que ese presupuesto no existe y de que nadie ha decidido cuánto debía esperar un directivo para saber cómo va su negocio.
Esa constatación tiene una lectura incómoda para cualquier dirección de sistemas: si los cuadros que más se usan no tienen presupuesto ni dueño, ¿cuántas decisiones de la compañía se están tomando fuera del BI, por teléfono o en una hoja de cálculo, porque preguntar sale más rápido? Y el ejercicio se complica cuando los cuadros dejan de construirlos unos pocos especialistas y empiezan a hacerlo cientos de personas en autoservicio, cada una con su propia idea de cuántos gráficos caben en una página. Cómo poner carriles a esa libertad sin frenarla es la materia del capítulo 33.
Siguiente en la Parte IV: capítulo 33, Self-service analytics: seguridad, límites y formación. · Capítulo anterior: Herramientas BI modernas · Volver a la Parte IV · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 30 de octubre de 2026.
