
Capítulo 33 · Parte IV: Business Intelligence y consumo · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
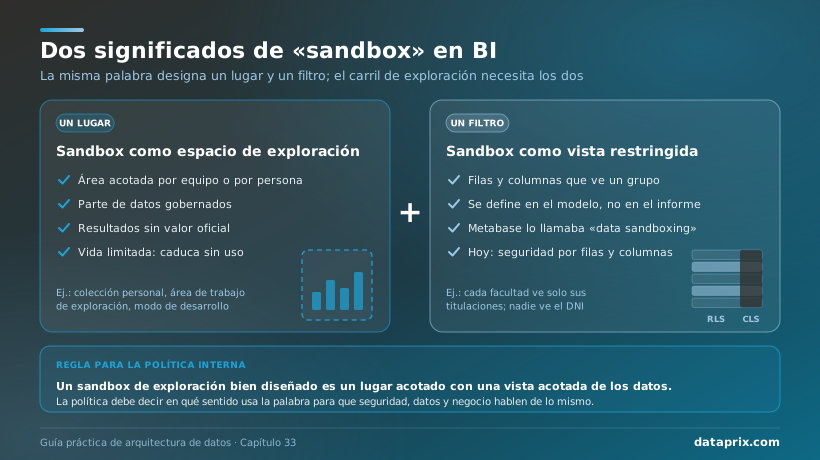
La petición llegó al comité de sistemas de información de la Universidad de Valmora en forma de hoja de cálculo: doscientos nombres, cada uno con su centro, su cargo y una justificación de dos líneas. Valmora es una universidad pública ficticia, compuesta a partir de situaciones habituales en el sector, y servirá de hilo a lo largo del capítulo. Su cuadro piloto sobre el abandono en primer curso había funcionado mejor de lo previsto: el vicerrectorado de estudiantes lo revisaba cada semana y tres facultades habían reorganizado sus tutorías a partir de él. Ahora decanatos, departamentos, servicios de gestión y grupos de investigación pedían lo que habían visto en la demostración, la posibilidad de construir sus propios análisis. Nadie en el comité discutía la conveniencia de abrir. Lo que había que decidir era el cómo: qué podría ver cada perfil, dónde podría publicar sus resultados, quién pagaría la capacidad que consumieran y qué tendría que saber cada persona antes de empezar. Este capítulo trata de esa decisión, que casi siempre llega después del primer éxito del BI.
En resumen. El self-service analytics rara vez fracasa por falta de herramientas: fracasa por falta de límites. Sin ellos degenera en un caos de versiones, con cada área publicando su propia verdad, o se apaga por miedo, con seguridad bloqueándolo todo mientras la analítica en la sombra crece fuera de la plataforma. El autoservicio que funciona se organiza en tres carriles —certificado, exploración y personal—, cada uno con sus permisos, su soporte y su caducidad, y con un flujo de promoción que lleva lo valioso de un carril al siguiente. La seguridad se define una vez en la capa semántica y se hereda; la capacidad de la exploración se separa y se limita con cuotas; y el permiso para crear se gana con formación, mediante un carné de creador que precede a la licencia. El programa se mide por la proporción del consumo que se apoya en contenido certificado y por el contenido que caduca a tiempo, nunca por las licencias compradas.
Después del piloto: por qué el autoservicio se rompe por los bordes
El self-service analytics, o analítica de autoservicio, es la capacidad de los usuarios de negocio para obtener, explorar y publicar análisis por sí mismos, sin pasar por el equipo de BI en cada pregunta, sobre datos que la organización pone a su disposición con reglas explícitas. La última parte de la definición es la que suele olvidarse. El capítulo 29 advertía de las dos maneras simétricas de fracasar, abrirlo todo o cerrarlo todo, y planteaba la estrategia; aquí toca construir el perímetro.
Lo que ocurre cuando ese perímetro no existe tiene nombre. La analítica en la sombra (shadow analytics) es el conjunto de análisis que se producen y circulan fuera de la plataforma gobernada: hojas de cálculo alimentadas con exportaciones, bases de datos de escritorio, cuadros construidos con cuentas personales en servicios en la nube. Rara vez nace de la mala fe. Nace de que preguntar al circuito oficial cuesta más que resolverlo por cuenta propia, y su coste se reparte entre cifras que no cuadran, datos personales que salen del perímetro sin control y decisiones que nadie puede reconstruir después.
En la práctica, el autoservicio se rompe por los bordes, y son cuatro. El primero es el de los datos: qué puede ver cada perfil y con qué nivel de detalle. El segundo, la publicación: dónde se comparte un análisis y qué valor tiene una vez compartido. El tercero, la capacidad: cuánto puede consumir cada usuario de una plataforma que se paga entre todos. El cuarto, el conocimiento: qué sabe hacer quien construye y qué sabe interpretar quien lee. Las herramientas de BI actuales ofrecen controles para los tres primeros; el cuarto solo se resuelve con personas. Las secciones siguientes recorren los cuatro con una misma pregunta de fondo: dónde poner cada límite para que proteja sin frenar.
En Valmora, cerca de noventa peticiones venían de decanatos y departamentos, que querían seguir sus titulaciones con más detalle que el cuadro institucional; unas sesenta, de servicios de gestión que llevaban años trabajando con exportaciones de los sistemas académico y de personal; y el resto, de grupos de investigación que querían cruzar datos institucionales con los suyos. Tres colectivos con necesidades, permisos y niveles de conocimiento muy distintos, y una tentación evidente: darles a todos la misma licencia y el mismo acceso, porque era lo más rápido.
Sandbox, dataset certificado, alfabetización: el vocabulario antes que los permisos
Muchos desencuentros entre el equipo de datos, seguridad y negocio son de vocabulario: cada parte usa las mismas palabras con sentidos distintos y la política acaba aprobada sobre un malentendido. Conviene fijar cinco términos por escrito antes de discutir un solo permiso.
Un dataset certificado es un conjunto de datos o un modelo semántico que un dueño identificado ha revisado y declarado apto para decisiones oficiales: sus métricas coinciden con las de la capa semántica, pasa las pruebas de calidad, hereda la seguridad corporativa y tiene una fecha de próxima revisión. La certificación es una promesa con fecha de caducidad, y la marca visible —el sello, la insignia, la marca de verificación— es solo la forma de comunicarla al usuario.
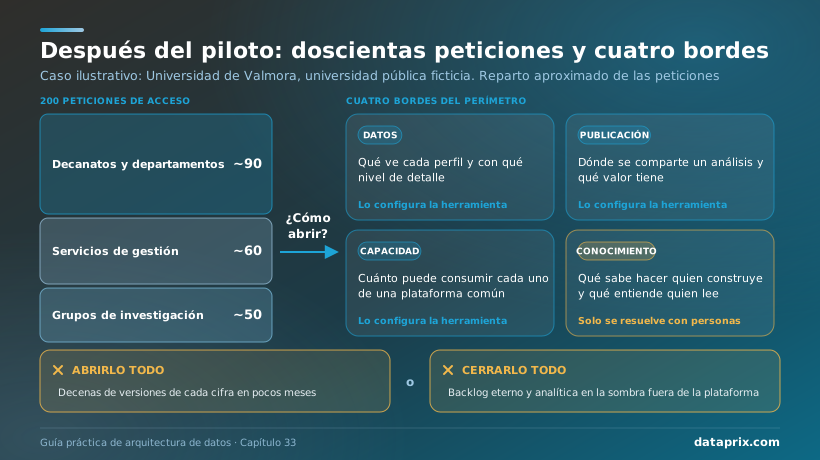
Un sandbox analítico es un espacio acotado donde un usuario o un equipo explora datos gobernados con libertad para crear, sin que sus resultados tengan valor oficial y con una vida limitada. La palabra arrastra un equívoco que conviene conocer. En algunas herramientas, «sandbox» ha designado otra cosa: Metabase llamó durante años data sandboxing a lo que su documentación denomina hoy seguridad por filas y columnas, es decir, la vista restringida de una tabla que ve un grupo de usuarios. En el primer sentido, un sandbox es un lugar; en el segundo, un filtro. Un sandbox de exploración bien diseñado necesita las dos cosas, y la política interna debería decir en cuál de los dos sentidos usa la palabra.
Dentro de la plataforma, la contrapartida de la analítica en la sombra es el contenido no gobernado: lo que se crea en la herramienta oficial fuera de cualquier flujo de certificación, sin dueño declarado ni caducidad. Es donde nacen los análisis nuevos, y solo se vuelve un problema cuando nadie sabe cuánto hay ni quién lo usa.
La alfabetización de datos (data literacy) es la capacidad de una persona para leer, interpretar, cuestionar y comunicar información basada en datos en el contexto de su trabajo. Va más allá de saber usar una herramienta: alguien puede dominar los filtros de un cuadro de mando y no distinguir una media de una mediana, o no preguntarse nunca de dónde sale una cifra. Y por último, el perímetro de autoservicio es el conjunto de reglas que delimitan, para cada perfil de usuario, los cuatro bordes del apartado anterior: datos, publicación, capacidad y conocimiento. Es el documento que aprueba el comité y lo que después configuran las herramientas.
Los tres carriles del autoservicio
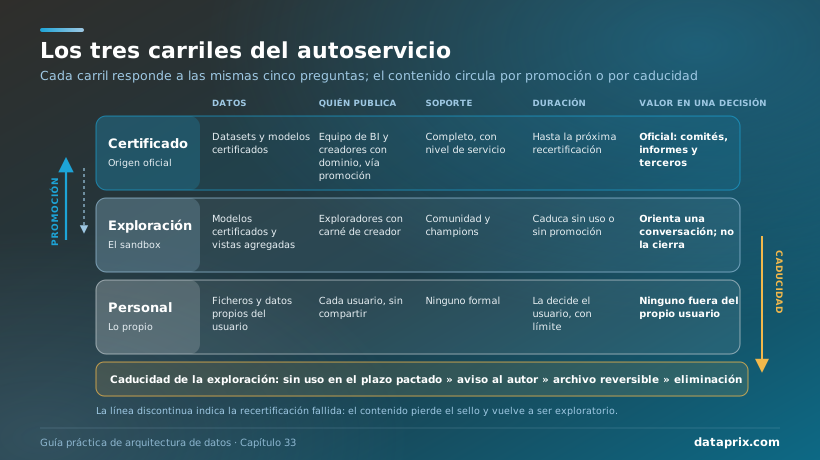
Para organizar el perímetro, este capítulo propone un marco con nombre propio: los tres carriles del autoservicio. Todo contenido analítico circula por uno de tres carriles —certificado, exploración o personal—, y cada carril se define con las mismas preguntas: de qué datos parte, quién publica en él, qué soporte recibe, cuánto dura lo que contiene y qué valor tiene en una decisión. La intuición tiene precedentes: la guía de gobierno Tableau Blueprint describe organizaciones donde el contenido certificado convive con el ad hoc y algunos usuarios crean en proyectos sandbox. Lo que aporta el marco es convertirla en reglas simétricas, aplicables con cualquier herramienta, que caben en una página.
El carril certificado contiene los datasets, modelos semánticos y cuadros que un dueño ha certificado, y es el único origen válido para las decisiones oficiales: lo que se lleva a un comité de dirección, a un informe regulatorio, a una memoria pública o a un tercero. Se publica en él a través del flujo de promoción, recibe los niveles de servicio y la frescura pactada que el capítulo 29 atribuía a los productos de datos, y sus métricas viven en la capa semántica que describió el capítulo 30. Su caducidad se expresa como un plazo de revisión: cada elemento se recertifica periódicamente o pierde el sello.
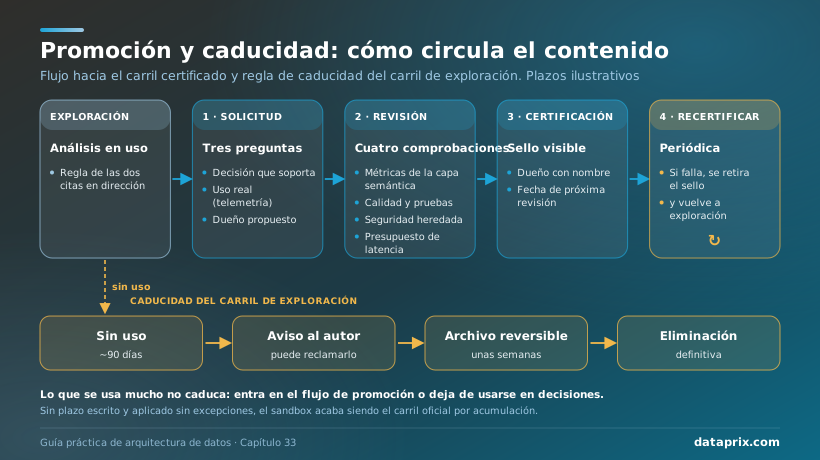
El carril de exploración es el sandbox en sentido amplio: espacios de trabajo por equipo o por área donde los usuarios formados crean análisis nuevos a partir de datasets certificados y de vistas preparadas para explorar, normalmente agregadas o seudonimizadas. Sus resultados se comparten dentro del equipo con una marca de contenido exploratorio y no valen como cifra oficial. Lo que no se usa en un plazo pactado se archiva, y lo que se usa mucho entra en el flujo de promoción o deja de usarse en decisiones.
El carril personal es el espacio propio de cada usuario: sus borradores, sus hojas de cálculo, los datos que trae de fuera. Existe porque negarlo solo lo empuja fuera de la plataforma, donde se vuelve invisible, y lo define una regla explícita: lo que está en el carril personal no entra en ninguna decisión que afecte a otros, no se comparte desde la plataforma y no contiene datos personales de terceros extraídos de los sistemas corporativos, salvo excepción documentada.
| Pregunta | Carril certificado | Carril de exploración | Carril personal |
|---|---|---|---|
| ¿De qué datos parte? | Datasets y modelos semánticos certificados | Modelos certificados y vistas agregadas o seudonimizadas | Ficheros y datos propios del usuario |
| ¿Quién publica? | Equipo de BI y creadores con dominio delegado, vía promoción | Exploradores con carné de creador | Cada usuario, sin compartir desde la plataforma |
| ¿Qué soporte recibe? | Completo, con nivel de servicio y frescura pactada | Comunidad interna y champions | Ninguno formal |
| ¿Cuánto dura? | Hasta su próxima recertificación | Caduca sin uso o sin promoción | Lo decide el usuario, con límite de almacenamiento |
| ¿Qué valor tiene en una decisión? | Oficial: comités, informes, terceros | Orienta una conversación; no la cierra | Ninguno fuera del propio usuario |
| ¿Qué datos sensibles admite? | Detalle individual para roles autorizados | Agregados con supresión de celdas pequeñas | Ninguno extraído de sistemas corporativos |
Criterio de decisión. Una cifra puede llevarse a un comité, a un informe oficial o a un tercero solo si procede del carril certificado; lo demás puede abrir una conversación, pero no cerrarla. Para la frontera entre carriles basta una regla de tráfico: si un análisis de exploración se cita dos veces en una reunión de dirección, entra en el flujo de promoción o se retira de esa reunión.
En Valmora, el carril certificado arrancó pequeño a propósito: cinco modelos semánticos —matrícula, rendimiento académico, abandono, personal docente e investigador y de administración y servicios, y presupuesto—, con sus métricas definidas en la capa semántica, un dueño de negocio en cada vicerrectorado o en la gerencia y una revisión semestral. El carril de exploración se organizó con un espacio por facultad y otro por servicio, con acceso a esos cinco modelos y a dos vistas preparadas para explorar con datos agregados. El carril personal se habilitó para todos, con un límite de almacenamiento modesto y un aviso visible al entrar: lo que hay aquí no es una cifra de la universidad.
Promoción, certificación y caducidad: el contenido también circula
Los carriles no son compartimentos estancos. Buena parte del valor del autoservicio está en que un buen análisis nacido en exploración llegue a ser oficial, y en que lo que deja de servir desaparezca. Sin un flujo entre carriles ocurre lo contrario: los buenos análisis se quedan para siempre en la carpeta de quien los hizo, o se vuelven oficiales por la puerta de atrás, a fuerza de reenviarlos.
El flujo de promoción tiene cuatro pasos. Empieza con una solicitud que responde a tres preguntas: qué decisión soporta el análisis, quién lo usa hoy —la telemetría de la plataforma lo dice sin necesidad de encuestas— y quién será su dueño cuando sea oficial. Sigue una revisión con cuatro comprobaciones: que las métricas sean las de la capa semántica, o que las nuevas se incorporen a ella con su definición escrita; que los datos pasen las validaciones del pipeline que describía el capítulo 24 y las pruebas de regresión del capítulo 26; que la seguridad sea la heredada del modelo y no una reconstruida en el informe; y que el rendimiento cumpla el presupuesto de latencia del capítulo 32. Si todo cuadra, llega la certificación, con un sello visible, el nombre del dueño y la fecha de la próxima revisión. El cuarto paso, el que más se olvida, es la recertificación periódica: el dueño confirma que el contenido sigue siendo correcto y útil, o el sello se retira.
Quién certifica depende del modelo de gobierno. Con un único equipo central que lo revisa todo, el flujo se convierte en un cuello de botella en cuanto el autoservicio despega. Escala mejor el modelo federado: cada dominio de negocio tiene sus certificadores —los data stewards del dominio— y un comité central se reserva las métricas transversales. Algunas plataformas ya soportan ese reparto; en Microsoft Fabric, la certificación la habilita un administrador, que designa a quién puede certificar y puede delegar esa tarea en los administradores de cada dominio. La Parte VI de la guía desarrollará los roles de gobierno; para el autoservicio basta una regla: sin certificadores con nombre y apellidos no hay carril certificado.
El sello conserva su valor mientras es escaso. Certificarlo todo para mejorar los indicadores del programa, o para contentar a cada área, lo vacía de significado. Ayuda fijar un número orientativo de elementos certificados por dominio y exigir que cada certificación nueva justifique por qué no basta con ampliar algo ya certificado. Conviene saber, además, qué hace la herramienta cuando alguien edita contenido certificado: en Metabase, cambiar la consulta de una pregunta, un modelo o una métrica verificados les retira la verificación, pero la de un panel se mantiene; Looker, con la certificación de contenido en vista previa, la revoca automáticamente ante cambios significativos. Comportamientos distintos obligan a procedimientos distintos.
La otra mitad del flujo es la caducidad. El contenido de exploración que nadie abre en un plazo pactado —noventa días es una referencia habitual— genera un aviso a su autor; si nadie lo reclama, se archiva de forma reversible y, pasado otro plazo, se elimina. Metabase, en sus planes Pro y Enterprise, trae de serie la retirada de elementos sin uso de una colección; en el resto de herramientas, la telemetría de actividad cargada en el almacén permite automatizar la misma regla. Lo que importa es que el plazo esté escrito y se aplique sin excepciones silenciosas, porque un sandbox sin caducidad acaba siendo, por pura acumulación, el carril oficial de facto.
En la universidad, el primer trimestre dejó una lección sobre el flujo. Una técnica del servicio de gestión académica construyó en exploración un análisis de tasas de rendimiento por asignatura que, a las pocas semanas, aparecía en las juntas de tres facultades. Por la regla de las dos citas entró en el flujo de promoción, y la revisión encontró que contaba como no presentados a los estudiantes con convocatoria anulada, una definición distinta de la del modelo certificado. Se corrigió, la métrica se incorporó a la capa semántica y el análisis se certificó con el vicerrectorado de ordenación académica como dueño. Sin flujo, cada facultad habría seguido comparando sus asignaturas con un criterio distinto del institucional.
Seguridad práctica: heredar los permisos y vigilar las salidas
La regla que ordena la seguridad del autoservicio se enuncia en una línea: la seguridad se define una vez, lo más cerca posible de los datos, y se hereda en todos los carriles. La seguridad por filas (RLS) y por columnas (CLS) vive en la capa semántica o en la plataforma, como explicó el capítulo 30, y cualquier análisis de exploración construido encima la respeta sin que su autor tenga que hacer nada. Cuando la seguridad se reconstruye en cada informe, con filtros que un creador añade y el siguiente puede quitar, el carril de exploración se convierte en el hueco por donde sale lo que el carril certificado protegía.
Para que la herencia funcione se necesitan dos condiciones técnicas. La primera es la propagación de la identidad: la consulta debe llegar al modelo con la identidad del usuario que la lanza, a través del inicio de sesión único de la organización, y no con una cuenta de servicio compartida que lo ve todo. La segunda es separar el permiso de consumir del de construir. Varias herramientas distinguen un permiso de construcción —crear análisis nuevos a partir de un modelo sin poder modificarlo— del permiso de edición; en Power BI se llama permiso de compilación (Build), y es lo que permite abrir el carril de exploración sobre modelos certificados sin ceder el control del modelo.
Sobre esa base, los permisos se organizan por perfil y por carril. Cinco perfiles cubren la mayoría de organizaciones: el consumidor, que lee contenido certificado; el explorador, que construye en su espacio sobre modelos certificados; el creador certificado, que además propone contenido al carril certificado; el steward o champion, que revisa y certifica en su dominio; y el administrador de plataforma, que configura la herramienta y designa a los certificadores, pero no certifica contenido de negocio porque no es dueño de ninguna definición.
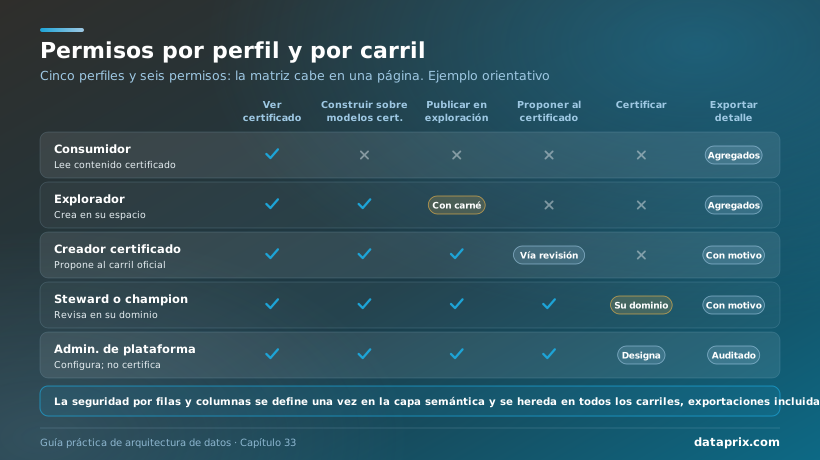
El punto débil de casi cualquier diseño de seguridad en BI son las salidas: la exportación a Excel o CSV, la descarga del fichero del informe, la suscripción por correo, la copia de un resultado al carril personal. Un análisis que respeta la seguridad por filas dentro de la herramienta pierde toda protección en cuanto su detalle se exporta y empieza a circular. Funcionan tres medidas. Limitar la exportación de datos subyacentes en los modelos sensibles y dejar solo la de agregados. Etiquetar la sensibilidad para que la etiqueta viaje con el fichero: en Power BI, las etiquetas de confidencialidad de Microsoft Purview protegen las exportaciones a Excel, PDF y PowerPoint (en este caso, al exportar como imagen), pero no las exportaciones a CSV, un matiz que conviene conocer antes de dar el asunto por resuelto. Y auditar: los registros de actividad dicen quién exportó qué y cuándo, y merecen la misma revisión periódica que los accesos.
La última pieza es la minimización por defecto. El carril de exploración no necesita el detalle de cada persona para la mayoría de sus preguntas. Las vistas preparadas para explorar pueden servir datos agregados o seudonimizados, con una regla de supresión de celdas pequeñas que oculta los grupos por debajo de un tamaño mínimo, para que nadie pueda deducir quién está detrás de un recuento de tres personas. El detalle individual queda en el carril certificado, para los roles que lo necesitan y con justificación.
Riesgo legal: categorías especiales de datos en el sandbox. Algunos datos llegan a los sandboxes sin que nadie los haya buscado. Las bajas por incapacidad temporal en un modelo de recursos humanos o las adaptaciones por discapacidad en un modelo de estudiantes son datos de salud, una de las categorías especiales del artículo 9 del RGPD, con exigencias reforzadas de base jurídica, minimización (art. 5.1.c), protección de datos desde el diseño (art. 25) y seguridad del tratamiento (art. 32). La seudonimización reduce el riesgo, pero no vuelve anónimos los datos para quien conserva la forma de reidentificarlos: el Tribunal de Justicia de la UE recordó en septiembre de 2025 (asunto C-413/23 P) que la calificación depende de quién puede reidentificar. En el sector público se suma el Esquema Nacional de Seguridad (Real Decreto 311/2022), que exige control de acceso y trazabilidad acordes con la categoría del sistema. Esto es orientación técnica, no asesoramiento jurídico: conviene validarlo con el delegado de protección de datos.
Valmora excluyó del carril de exploración cualquier dato individual de estudiantes con necesidades específicas de apoyo y de bajas del personal. En las vistas de exploración, los recuentos inferiores a diez personas se muestran como «menos de 10», y el detalle por persona solo existe en los modelos certificados, para los roles que lo tienen asignado y con registro de cada acceso. El delegado de protección de datos participó desde el primer borrador de la matriz, y no al final, cuando su intervención suele llegar en forma de veto.
Cuotas y capacidad: que la exploración no frene al comité de dirección
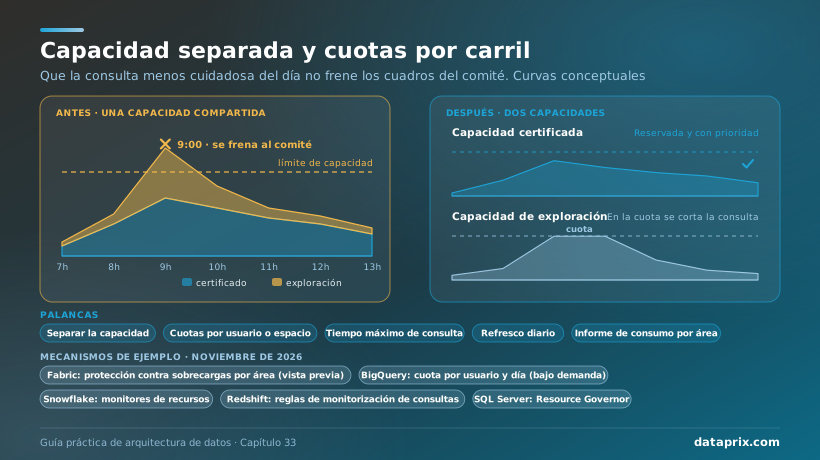
El tercer borde es el más prosaico y, en las plataformas en la nube, el que antes se nota en la factura. Un usuario de exploración puede lanzar sin saberlo consultas que recorren tablas enteras, cruzar dos tablas de hechos sin condición de unión o refrescar su modelo cada quince minutos porque la opción estaba disponible. A la lista se suman los asistentes de IA integrados en las herramientas de BI, que generan consultas a partir de preguntas en lenguaje natural y que el capítulo 31 presentaba como un cuarto consumidor emergente. Inocentes por separado, juntos pueden dejar sin capacidad, a las nueve de la mañana, los cuadros certificados que la dirección abre a esa hora.
Las palancas son cuatro, y conviene aplicarlas antes de abrir el carril, porque después del primer susto cada límite se negocia como una pérdida. La primera es separar la capacidad: el carril de exploración trabaja en su propia capacidad, almacén virtual o grupo de recursos, de modo que su consumo no compita con el del carril certificado. La segunda son las cuotas por usuario o por espacio de trabajo. La tercera, los tiempos máximos de consulta y los límites de filas en las exportaciones. La cuarta, acotar la frecuencia de refresco en exploración, donde un modelo rara vez necesita más de una actualización diaria.
Cada plataforma ofrece sus mecanismos, y a fecha de noviembre de 2026 merece la pena conocer algunos. Microsoft Fabric incorpora una protección contra sobrecargas (surge protection) que, a nivel de capacidad, rechaza nuevas operaciones en segundo plano cuando el uso se acerca a un umbral configurado, y a nivel de área de trabajo —todavía en vista previa— limita las unidades de capacidad que un área puede consumir en una ventana de 24 horas y permite marcar áreas como críticas o bloquearlas. BigQuery, en su modelo de precios bajo demanda, admite cuotas personalizadas de datos procesados por día, tanto para el proyecto como para cada usuario. Snowflake ofrece monitores de recursos que suspenden un almacén virtual al agotar el crédito asignado; Amazon Redshift, reglas de monitorización de consultas dentro de su gestión de cargas; y SQL Server, el Resource Governor, que reparte CPU y memoria entre grupos de carga. En las herramientas de BI con conexión directa, la conexión que usa el grupo de exploración puede apuntar a una réplica o a un almacén distinto del que sirve al carril certificado.
Las cuotas protegen la plataforma; el reparto del coste cambia el comportamiento. Un informe trimestral de consumo por área —showback, sin factura interna— suele bastar para que cada responsable vea qué modelos de su equipo consumen más. Pasar al chargeback, con imputación real del coste, es una decisión de más calado que el capítulo de FinOps de la Parte VI tratará con detalle.
En Valmora, la capacidad de exploración se dimensionó en torno a una cuarta parte de la certificada, con cuota por facultad y un tiempo máximo de consulta de pocos minutos. El primer informe de consumo por centro ordenó más que cualquier circular: una facultad descubrió que tres modelos casi idénticos, refrescados cada hora por tres personas distintas, sumaban la mitad de su consumo.
Formación por perfiles: el carné antes que la licencia
El cuarto borde no se configura en ninguna consola. Una organización puede tener los carriles mejor diseñados y descubrir que la mitad del contenido de exploración duplica métricas certificadas porque sus autores no sabían que existían, o que un directivo decide sobre un gráfico cuyo eje no empieza en cero. Por eso la formación forma parte del perímetro, con el mismo rango que la seguridad o las cuotas.
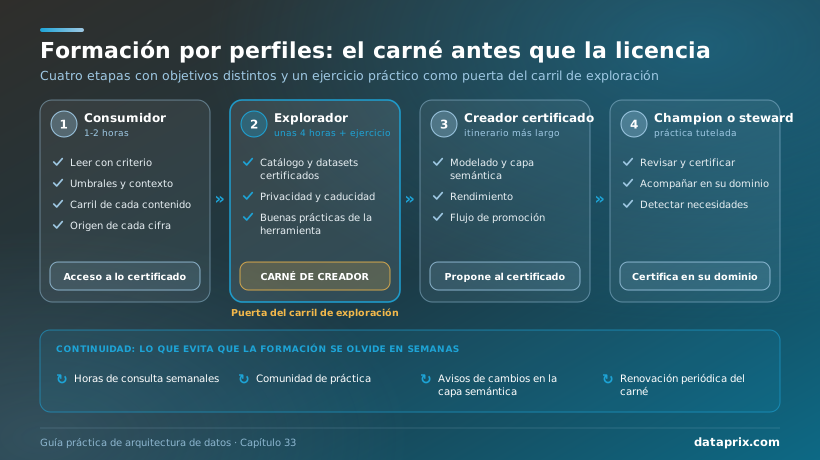
Un programa que funciona forma por perfiles, con objetivos distintos para cada uno. Al consumidor le hace falta leer con criterio: entender qué significa un umbral, saber en qué carril está lo que mira, de dónde sale una cifra y a quién preguntar. El explorador necesita encontrar y usar los datasets certificados —el catálogo que el capítulo 27 enseñaba a mantener vivo es su puerta de entrada—, conocer las reglas de privacidad y caducidad y aplicar las buenas prácticas de la herramienta. El creador certificado suma modelado, rendimiento y el flujo de promoción. Y el champion, además, aprende a revisar el trabajo de otros y a acompañarlos.
La pieza que más ordena el programa es lo que este capítulo denomina el carné de creador: el permiso para crear y compartir en el carril de exploración se concede tras una formación breve y un ejercicio práctico con los datos de la propia organización, y se renueva periódicamente. Invertir el orden habitual, en el que la licencia llega primero y la formación quizá después, garantiza un mínimo común entre quienes publican y convierte la formación en algo que el usuario quiere completar, porque le da acceso. Y es frecuente que parte de quienes pidieron licencia de creador descubran durante el curso que les bastaba con aprender a usar bien los cuadros certificados.
La formación de incorporación, por sí sola, se olvida en pocas semanas. Lo que sostiene el nivel es la continuidad: horas de consulta semanales con el equipo de BI, una comunidad de práctica que se reúne para compartir análisis y errores, avisos cuando cambia una definición de la capa semántica y una red de champions, personas de negocio con buen nivel técnico que actúan como primera línea de ayuda en su área. Los champions son además el canal por el que el equipo de BI conoce las necesidades antes de que lleguen como petición formal, y la cantera natural de los certificadores de cada dominio.
Para situar el punto de partida, el Test de Madurez Analítica de Dataprix permite a cada área estimar su nivel y contrastar la percepción del negocio con la del equipo de datos; repetido al cabo de un año, da una medida de progreso que no depende de la herramienta. El plan de capacidades del propio equipo de datos, con sus perfiles y su plan de contratación, corresponde al capítulo sobre organización y gestión del cambio de la Parte VI.
La universidad diseñó un itinerario de cuatro horas para el carné, con un ejercicio final sobre el modelo de matrícula, y nombró un champion por facultad —casi siempre un técnico de gestión con soltura en hojas de cálculo— con una reducción de carga reconocida formalmente, porque un champion sin tiempo asignado deja de serlo en cuanto llega la matrícula. En torno a un tercio de las doscientas peticiones se resolvieron sin licencia de creador: bastaba con usar los cuadros certificados y pedir una vista nueva al champion.
Medir el programa: señales de un autoservicio sano
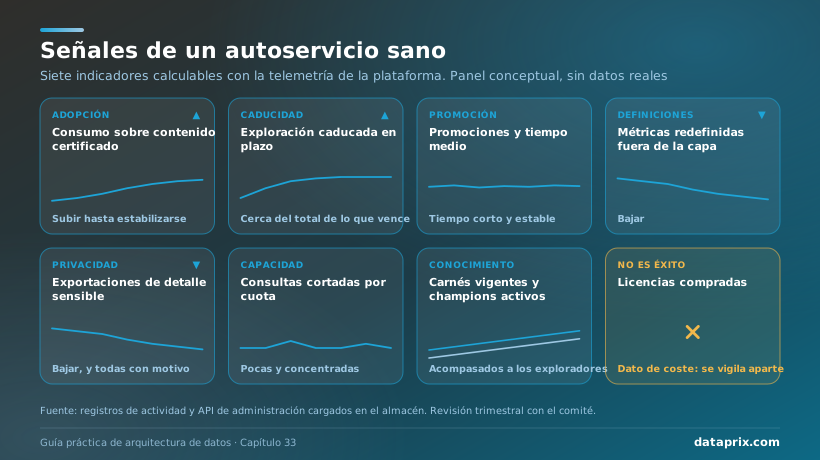
El capítulo 29 proponía medir el BI por usuarios activos, recurrencia, consumo certificado y retiradas. Un programa de autoservicio necesita, además, indicadores propios que digan si los carriles funcionan. Ninguno de ellos es el número de licencias compradas, que es un dato de coste y como tal debe tratarse.
| Indicador | Qué revela | Dirección deseada | Trampa habitual |
|---|---|---|---|
| Proporción de consumo sobre contenido certificado | El peso real de la fuente oficial en el uso | Subir hasta estabilizarse | Inflarla certificando de más |
| Contenido de exploración caducado en plazo | Si la caducidad se aplica | Cerca de la totalidad de lo que vence | Excepciones silenciosas |
| Promociones y tiempo medio de promoción | Si el flujo funciona sin ser un cuello de botella | Tiempo corto y estable | Promover sin revisar para cumplir el plazo |
| Métricas redefinidas fuera de la capa semántica | Duplicación de definiciones | Bajar | No detectarlas por falta de linaje |
| Exportaciones de detalle sensible | Riesgo de fuga por las salidas | Bajar, y todas con motivo | Contar solo las que deja trazar la herramienta |
| Consultas cortadas por cuota o tiempo máximo | Presión sobre la capacidad y necesidades de formación | Pocas y concentradas | Subir la cuota en lugar de formar |
| Carnés vigentes y champions activos | Salud del borde del conocimiento | Acompasados al número de exploradores | Contar asistencias sin ejercicio práctico |
Casi todos se calculan con la telemetría de las plataformas —registros de actividad, API de administración, informes de uso— cargada en el almacén. Es un buen primer producto para el propio equipo de BI: un cuadro de salud del autoservicio que se revisa cada trimestre con el comité y que obliga al equipo a aplicarse las reglas que pide a los demás.
Un año después de la decisión del comité, el cuadro de salud de Valmora mostraba, en órdenes de magnitud ilustrativos, el patrón de un programa que funciona: el consumo apoyado en contenido certificado había pasado de menos de la mitad a cerca de dos tercios, una docena de análisis habían subido de exploración a certificado y varios centenares de elementos habían caducado sin que nadie los reclamara. La cifra más comentada en el comité fue otra: las hojas de cálculo con datos de estudiantes que circulaban por correo entre servicios, según la encuesta anual a los propios servicios, habían bajado de forma notable. Esa cifra no sale de la plataforma, y sin embargo es la que mejor justifica el programa ante la gerencia y ante el delegado de protección de datos.
Cuatro escenarios: dónde se rompe el autoservicio en otros sectores
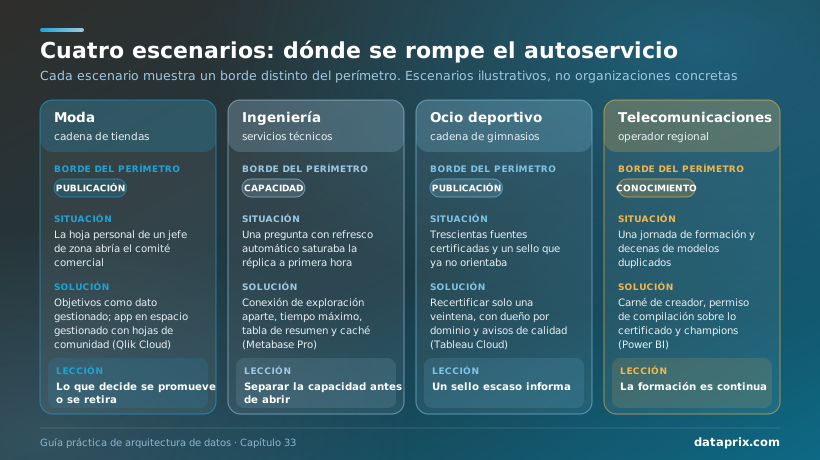
Los cuatro escenarios siguientes son ilustrativos: combinan situaciones habituales en cada sector y no describen organizaciones concretas. Las cifras son órdenes de magnitud, y cada escenario muestra un borde distinto del perímetro.
Moda: la hoja del jefe de zona que se convirtió en la cifra del comité. Una cadena de tiendas de moda con venta en línea trabaja con Qlik Cloud. Un jefe de zona combinó en una hoja de cálculo personal las ventas de la aplicación oficial con un fichero propio de objetivos por tienda, y empezó a enviarla cada lunes; a los pocos meses era la cifra con la que se abría el comité comercial. Cuando dejó la empresa, nadie supo reconstruir los objetivos ni explicar por qué sus ventas no coincidían con las de finanzas: su fichero trataba las devoluciones de otra manera. La corrección llevó los objetivos a la plataforma como dato gestionado, publicó la aplicación comercial en un espacio gestionado y dejó las hojas de los usuarios en el área de comunidad, visibles pero diferenciadas del contenido base. Como Qlik Cloud, a diferencia de la versión que gestiona el propio cliente, no tiene un paso de aprobación de hojas de comunidad, la promoción se hace incorporando la hoja revisada a la aplicación de origen y volviendo a publicarla. Lección: lo que se usa en una decisión se promueve o se retira; un carril personal que alimenta un comité es un carril certificado sin dueño ni controles.
Ingeniería: la pregunta que se lanzaba cada diez minutos. Una empresa de ingeniería con varios cientos de profesionales usa Metabase en su plan Pro, instalado en sus propios servidores, sobre una réplica de lectura de su base de datos de proyectos y partes de horas. Cada mañana, los jefes de proyecto consultan cuadros verificados de horas imputadas frente a presupuesto. Un analista creó en exploración una pregunta que cruzaba cinco años de partes de horas con las tarifas de cada categoría y la puso en un panel con refresco automático; con varios compañeros usándolo, la réplica se saturaba justo cuando los jefes de proyecto abrían sus cuadros. La solución combinó una conexión aparte para el grupo de exploración, contra otra réplica y con tiempo máximo de consulta, una tabla de resumen mensual que respondía lo mismo con una fracción del coste y una política de caché para los paneles compartidos. Como en la disyuntiva entre operar o contratar gestionado que el capítulo 12 analizaba para las bases de datos, en la instalación propia la capacidad la dimensiona el propio equipo. Lección: la capacidad de exploración se separa antes de abrir el carril; compartirla deja la experiencia del comité en manos de la consulta menos cuidadosa del día.
Ocio deportivo: trescientas fuentes certificadas. Una cadena de gimnasios con centros en varias comunidades autónomas adoptó Tableau Cloud y, para acelerar la adopción, certificó cada fuente de datos publicada que cumplía unos mínimos técnicos. Dos años después había unas trescientas fuentes con el sello, con definiciones distintas de «socio activo» según se contaran las bajas temporales o los pases de prueba, y el sello ya no orientaba a nadie. La corrección retiró todas las certificaciones y las volvió a conceder solo a una veintena de fuentes, con un dueño por dominio, una definición única de socio activo y advertencias de calidad en las fuentes con problemas conocidos. Un matiz para el presupuesto: en Tableau, certificar fuentes publicadas no requiere el complemento Data Management, que sí hace falta para el resto de etiquetas de datos, como esas advertencias. Lección: un sello que lo cubre todo no informa de nada; la escasez es lo que le da valor.
Telecomunicaciones: la formación de un solo día. Un operador regional de telecomunicaciones abrió Power BI a unos cuatrocientos usuarios tras una jornada de formación. Un año después, el inventario reveló decenas de modelos semánticos que reproducían con pequeñas variaciones el modelo certificado de clientes y bajas, porque sus autores no lo encontraron o no supieron construir encima; cada uno con su definición de cliente activo, y dos de ellos alimentando informes que llegaban al consejo. El operador cambió el orden: reservó la creación de modelos a quien tuviera el carné de creador, dio permiso de compilación sobre los modelos certificados a todos los exploradores, nombró champions en cada dirección y empezó a publicar cada mes los cambios de definiciones. Lección: la formación tiene que ser continua; una jornada de incorporación reparte licencias y deja pendiente todo lo demás.
Anti-patrones: del grifo abierto al candado
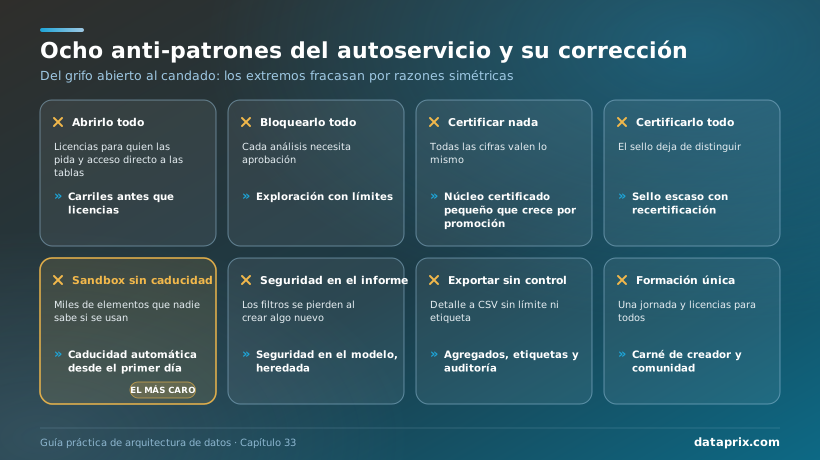
Abrirlo todo y esperar lo mejor. Licencias de creador para quien las pida, acceso directo a las tablas y confianza en el buen criterio general; se corrige invirtiendo el orden, primero los carriles y después las licencias. Bloquearlo todo es su simétrico: cada análisis necesita aprobación, el autoservicio se ahoga en la cola y la analítica en la sombra florece fuera, donde no hay control alguno. Entre ambos extremos, el carril de exploración con límites es lo que permite decir que sí sin perder el control.
Certificar nada o certificarlo todo. Sin carril certificado, cada análisis vale lo mismo que cualquier otro y las reuniones empiezan conciliando cifras. Con todo certificado, el sello pierde el significado, como en el escenario de los gimnasios. El punto de equilibrio es un núcleo certificado pequeño, con dueños y recertificación, que crece por promoción y no por decreto.
La seguridad en el informe. Filtros de seguridad aplicados en cada cuadro en lugar de en el modelo. Funciona mientras nadie construye nada nuevo; en cuanto un explorador crea un análisis sobre el mismo modelo, los filtros desaparecen. Su pariente es la exportación como coladero: la seguridad del modelo es impecable, pero el detalle se puede exportar a CSV sin restricción y sin etiqueta.
El anti-patrón más caro: el sandbox sin caducidad. Durante los primeros meses no causa ningún problema visible. Al cabo de dos o tres años, el carril de exploración acumula miles de elementos: una parte se usa en decisiones sin que nadie lo sepa, otra consume capacidad con refrescos programados que nadie mira y otra contiene datos personales que nadie recuerda haber copiado. El coste aparece de golpe y en el peor momento: cuando la organización decide cambiar de herramienta y descubre que no puede migrar lo que no sabe si alguien usa, o cuando una auditoría de protección de datos pide el inventario de tratamientos y nadie puede darlo. La caducidad automática desde el primer día, escrita en la política y aplicada sin excepciones silenciosas, cuesta muy poco en comparación.
La formación única, como en el escenario del operador de telecomunicaciones, suele ir acompañada de medir las licencias compradas como indicador de éxito, una cifra que crece mientras el programa se deteriora. Y queda una variante discreta: la política sin dueño, aprobada con entusiasmo y nunca revisada, que al cabo de un año describe una organización que ya no existe. La política de autoservicio también necesita su fecha de revisión.
Selección de software: cómo resuelve cada herramienta los tres carriles
Las herramientas de BI resuelven los carriles con piezas parecidas y nombres distintos, y la diferencia práctica está en los detalles: quién puede certificar, qué ocurre al editar algo certificado, si existe un paso de aprobación o si la limpieza del contenido sin uso viene de serie. La tabla resume cómo lo hacen seis herramientas habituales a fecha de noviembre de 2026. La comparativa general está en el capítulo 31, y el ranking de software de Business Intelligence 2026 del directorio de Dataprix recoge la valoración editorial de cada opción, encabezado por Microsoft Power BI, Tableau, Qlik Sense y Looker, seguidos de SAP Analytics Cloud y Oracle Analytics Cloud.
| Herramienta | Carril personal | Carril de exploración | Certificación | Detalles que cambian el procedimiento |
|---|---|---|---|---|
| Power BI / Microsoft Fabric | Área de trabajo personal | Áreas de trabajo con roles (Admin, Member, Contributor, Viewer) y permiso de compilación sobre modelos certificados | Aprobación (endorsement) en tres niveles: promocionado, certificado y datos maestros; los dos últimos los habilita un administrador, que designa certificadores y puede delegar en los administradores de dominio | Etiquetas de confidencialidad que viajan en exportaciones a Excel, PDF y PowerPoint, no en CSV; protección contra sobrecargas por área de trabajo en vista previa |
| Tableau | Espacio personal, privado y no compartible, con límite de almacenamiento fijado por el administrador | Proyectos con permisos por grupo; la guía Tableau Blueprint contempla proyectos sandbox | Certificación de fuentes de datos publicadas, bases de datos, tablas, flujos y conexiones virtuales, a cargo de administradores y responsables de proyecto | Certificar fuentes publicadas no requiere Data Management; las advertencias de calidad y el resto de etiquetas de datos, sí |
| Qlik Cloud | Espacio personal | Espacios compartidos; hojas privadas que se hacen públicas en aplicaciones publicadas en espacios gestionados | Contenido base de la aplicación publicada en un espacio gestionado | Sin paso de aprobación de hojas de comunidad (sí lo hay en la versión gestionada por el cliente) |
| Looker | Carpeta personal; modo de desarrollo para los cambios en LookML | Carpetas compartidas sobre exploraciones gobernadas por el modelo LookML | Certificación de paneles, Looks y exploraciones de autoservicio, en vista previa, con el permiso certify_content |
Los cambios significativos revocan la certificación de forma automática |
| Metabase | Colección personal | Colecciones con permisos por grupo | Contenido verificado y colecciones oficiales, en los planes Pro y Enterprise | Cambiar la consulta retira la verificación de preguntas, modelos y métricas, no la de los paneles; limpieza de elementos sin uso y seguridad por filas y columnas en Pro y Enterprise |
| Apache Superset | Paneles en borrador, visibles solo para sus editores | Paneles publicados, con visibilidad según los permisos sobre los datos | Campos de certificación (quién certifica y detalle) en paneles, gráficos y métricas | La certificación es un metadato sin flujo de aprobación: el procedimiento tiene que ponerlo la organización |
Las funciones cambian con cada versión; las preguntas para la demostración, hecha con datos y perfiles propios, se mantienen. Dónde vive un borrador y quién lo ve. Cómo pasa un análisis de exploración a certificado y si queda traza de quién lo revisó. Qué ocurre con la certificación cuando alguien edita el contenido. Si la seguridad del modelo se hereda en exploraciones, exportaciones y suscripciones, comprobado con un usuario de prueba de cada perfil. Si se puede limitar el consumo por espacio o por usuario sin comprar otra capacidad. Y qué telemetría de uso ofrece para aplicar la caducidad sin trabajo manual. La valoración editorial es que estas seis respuestas pesan más en el éxito del autoservicio que la diferencia de precio por licencia entre dos herramientas del mismo nivel.
Checklist operativo: antes de abrir el autoservicio
- Escribir la política de autoservicio con los tres carriles, sus cinco atributos y la regla de las dos citas, y nombrar a su dueño y su fecha de revisión.
- Arrancar el carril certificado con pocos modelos semánticos, cada uno con dueño de negocio, métricas en la capa semántica y fecha de recertificación.
- Designar certificadores por dominio y un comité para las métricas transversales.
- Definir la seguridad por filas y columnas en el modelo, con propagación de la identidad del usuario, y comprobar que se hereda en exploraciones, exportaciones y suscripciones.
- Conceder permiso de construcción sobre los modelos certificados en lugar de permiso de edición.
- Preparar vistas de exploración agregadas o seudonimizadas, con supresión de celdas pequeñas, y excluir los datos de categorías especiales.
- Limitar la exportación de detalle en los modelos sensibles, etiquetar la sensibilidad y revisar los registros de exportación.
- Separar la capacidad del carril de exploración y fijar cuotas, tiempos máximos de consulta y frecuencia de refresco.
- Publicar un informe de consumo por área cada trimestre.
- Condicionar la publicación en exploración al carné de creador y fijar su renovación.
- Nombrar champions por área con tiempo reconocido y poner en marcha horas de consulta y una comunidad de práctica.
- Automatizar la caducidad del contenido de exploración con aviso, archivo reversible y eliminación.
- Cargar la telemetría de uso en el almacén y revisar el cuadro de salud del autoservicio cada trimestre.
- Implicar al delegado de protección de datos desde el primer borrador de la matriz de permisos.
Formación recomendada
Para los equipos que diseñan un programa de autoservicio y para los usuarios que van a crear en él, estas opciones cubren la alfabetización de datos, el gobierno y la publicación segura de contenido:
- Data Literacy Professional (DataCamp, en español): itinerario de unas quince horas y ocho cursos, desde la introducción a los datos y la alfabetización de datos hasta la formulación de preguntas analíticas y la narración con datos. Encaja como base del carné de explorador.
- Implementación y mantenimiento de recursos en Power BI (DataCamp): curso intermedio de unas dos horas sobre áreas de trabajo y aplicaciones, seguridad por filas, etiquetas de confidencialidad, permisos y la promoción y certificación de contenido.
- Conceptos de Data Governance (DataCamp): curso básico de unas dos horas sobre marcos de gobierno, roles, comités y modelos operativos, útil para quienes van a ejercer de certificadores.
- Power BI DevOps: PBIP, Git, CI/CD y Microsoft Fabric (Udemy): control de versiones y despliegue entre entornos para el contenido de Power BI, la base técnica de un flujo de promoción con traza.
Enlaces de afiliado: Dataprix puede recibir una comisión si contratas a través de ellos.
Recursos y lecturas recomendadas
- Tableau, modelos de gobierno de Tableau Blueprint: la descripción de los modelos centralizado, delegado y autogobernado, con el papel de los proyectos sandbox y del contenido certificado en cada uno.
- Microsoft, hoja de ruta de adopción de Microsoft Fabric: doce áreas de adopción, entre ellas la propiedad y el alcance del contenido, la comunidad de práctica, la mentoría y el soporte a usuarios. Útil aunque la herramienta sea otra.
- Documentación de certificación y espacios de los fabricantes: la aprobación de contenido en Fabric y la protección contra sobrecargas, el espacio personal de Tableau, la certificación de contenido de Looker, y la verificación de contenido, las colecciones y la seguridad por filas y columnas de Metabase.
- Google Cloud, cuotas personalizadas de consulta en BigQuery: un ejemplo concreto de límite de consumo por usuario y por proyecto.
- AEPD y Supervisor Europeo de Protección de Datos, 10 malentendidos relacionados con la anonimización, y CEPD, directrices 01/2025 sobre seudonimización: lectura recomendable antes de decidir qué datos entran en un sandbox.
- Real Decreto 311/2022, por el que se regula el Esquema Nacional de Seguridad, para organizaciones del sector público y sus proveedores.
- Jordan Morrow, Be Data Literate (Kogan Page, segunda edición): una introducción práctica a la alfabetización de datos pensada para profesionales sin perfil técnico.
- TOP 10 de plataformas de gobernanza del dato (Dataprix): catálogos y herramientas de gobierno que sostienen la certificación y el linaje cuando el autoservicio crece.
Preguntas frecuentes
¿Qué es el self-service analytics?
Es la capacidad de los usuarios de negocio para obtener, explorar y publicar análisis por sí mismos, sin pasar por el equipo de BI en cada pregunta, sobre datos que la organización pone a su disposición con reglas explícitas. Funciona cuando esas reglas existen: datasets certificados como origen de las cifras oficiales, espacios de exploración con permisos y caducidad, seguridad heredada del modelo, cuotas de consumo y formación por perfiles.
¿Qué es un dataset certificado?
Es un conjunto de datos o un modelo semántico que un dueño identificado ha revisado y declarado apto para decisiones oficiales. Sus métricas coinciden con las de la capa semántica, pasa las pruebas de calidad, hereda la seguridad corporativa y tiene una fecha de próxima revisión. La certificación se renueva periódicamente; si nadie la renueva, el sello se retira.
¿Qué es un sandbox analítico y cuánto tiempo debe durar lo que contiene?
Es un espacio acotado donde un usuario o un equipo explora datos gobernados con libertad para crear, sin valor oficial y con vida limitada. Una referencia habitual es avisar al autor cuando un elemento lleva unos noventa días sin uso, archivarlo de forma reversible si nadie lo reclama y eliminarlo pasado otro plazo. Lo que se usa con frecuencia en decisiones debe entrar en el flujo de promoción al carril certificado.
¿Cómo se evita que el autoservicio dispare el coste de la plataforma de datos?
Separando la capacidad del carril de exploración de la del carril certificado y aplicando cuotas por usuario o por espacio, tiempos máximos de consulta y límites a la frecuencia de refresco. Las plataformas ofrecen mecanismos propios, como la protección contra sobrecargas de Microsoft Fabric, las cuotas personalizadas de BigQuery o los monitores de recursos de Snowflake. Un informe trimestral de consumo por área completa las cuotas, porque cambia el comportamiento de cada equipo.
¿Se pueden usar datos personales o de salud en el autoservicio?
Con cautela y normalmente no en el carril de exploración. Lo recomendable es que la exploración trabaje con datos agregados o seudonimizados, con supresión de celdas pequeñas, y que el detalle individual quede en modelos certificados para roles autorizados y con registro de accesos. Los datos de salud son una categoría especial del artículo 9 del RGPD y exigen garantías reforzadas, y la seudonimización no los convierte en anónimos para quien puede reidentificarlos. Conviene validar cada caso con el delegado de protección de datos.
¿Cómo se mide si un programa de autoservicio funciona?
Con indicadores calculados a partir de la telemetría de la plataforma: la proporción del consumo que se apoya en contenido certificado, el contenido de exploración que caduca en plazo, las promociones y su tiempo medio, las métricas redefinidas fuera de la capa semántica, las exportaciones de detalle sensible, las consultas cortadas por cuota y los carnés y champions activos. El número de licencias compradas es un dato de coste y no mide el éxito.
Noventa días de contenido como punto de partida
Hay una consulta que cualquier equipo de BI puede lanzar esta misma semana sobre los registros de actividad de su plataforma: todo el contenido creado en los últimos noventa días, clasificado según se apoye o no en un dataset certificado, con su número de visualizaciones y el número de personas distintas que lo han abierto. El resultado suele dibujar el mapa real del autoservicio de la organización, que rara vez coincide con el de la política: análisis personales con decenas de lectores, copias del modelo oficial con una definición cambiada, contenido certificado que nadie abre. Ese mapa es el mejor punto de partida para trazar los carriles, porque muestra por dónde circula ya el tráfico. Y deja una pregunta incómoda para la dirección de sistemas: de las cifras que se presentaron en el último comité, ¿cuántas salieron del carril certificado, y quién podría reconstruir las demás si su autor faltara mañana?
Los carriles ordenan el consumo dentro de la organización. Cuando quien consume es un socio, un proveedor o un cliente, las mismas preguntas —qué datos, con qué garantías, cuánto consumo y a qué precio— pasan de la política interna al contrato. El capítulo 34 aborda ese salto: los datos servidos como producto, con APIs, cuotas, acuerdos de nivel de servicio y un gobierno que ya no termina en la frontera de la empresa.
Siguiente en la Parte IV: capítulo 34, Monetización y APIs de datos para consumo interno y externo. · Capítulo anterior: Dashboards eficaces · Volver a la Parte IV · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 3 de noviembre de 2026.
