
Capítulo 34 · Parte IV: Business Intelligence y consumo · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
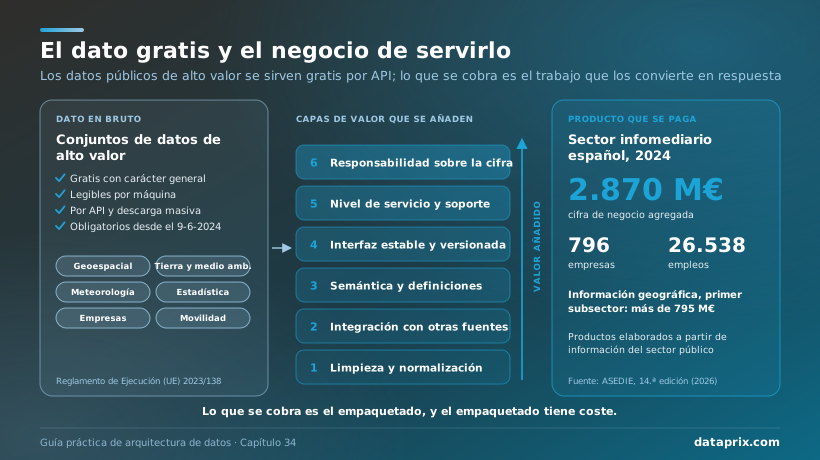
Desde el 9 de junio de 2024, las administraciones públicas de la Unión Europea están obligadas a publicar sus conjuntos de datos de alto valor —información geoespacial, meteorológica, estadística, medioambiental, de empresas y de movilidad— gratis con carácter general, en formatos legibles por máquina y a través de APIs, como exige el Reglamento de Ejecución (UE) 2023/138. En España, la Dirección General del Dato abrió a finales de octubre de 2026 una consulta para ampliar esa lista con conjuntos nacionales. Sobre la información pública, buena parte de ella gratuita, vive un sector entero: según la decimocuarta edición del informe de ASEDIE, presentada en abril de 2026, el sector infomediario español reúne 796 empresas, alcanzó en 2024 una cifra de negocio agregada de 2.870 millones de euros y empleaba a 26.538 personas; solo el subsector de información geográfica superó los 795 millones (resumen del informe en datos.gob.es). Lo que cobran esas empresas es el trabajo que separa un fichero público de una respuesta útil: limpiar, integrar, enriquecer, servir con garantías y atender a quien lo usa. Esa distancia explica mejor que cualquier definición qué significa monetizar datos, y es el terreno de este capítulo.
En resumen. La monetización de datos casi nunca consiste en vender datos: consiste en empaquetarlos como producto con contrato y en cobrar, o ahorrar, por el servicio que los rodea. Se recorre en cuatro niveles —eficiencia interna, producto interno con showback o chargeback, servicio externo por API o portal, y mercado—, con exigencias técnicas, contractuales y legales crecientes, y saltarse alguno explica la mayoría de los fracasos. Una API de datos es el contrato de datos elevado a producto: interfaz, semántica, nivel de servicio, cuotas, precio, condiciones de uso y ciclo de vida, tras una pasarela que identifica, limita y mide cada consumo. Cuando el consumidor tiene plataforma propia, el data sharing nativo comparte sin copiar. El precio se fija entre el coste de servir y el valor para quien paga, y el RGPD, el Data Act y la Ley de Gobernanza de Datos deciden hasta qué nivel puede llegar cada conjunto de datos.
Qué se cobra cuando se cobra por datos
El capítulo anterior terminaba en la frontera de la organización: cuando quien consume es un socio, un proveedor o un cliente, las preguntas del autoservicio pasan de la política interna al contrato. Antes de diseñar ese contrato conviene fijar el vocabulario, porque «monetizar datos» se usa para cosas tan distintas como abaratar compras con una previsión, cobrar una suscripción por una API o publicar un conjunto de datos en un mercado.
La monetización de datos es la obtención de un beneficio económico medible a partir de activos de datos. Es indirecta cuando el beneficio llega por dentro —un proceso más barato, una decisión mejor, un ingreso que no se pierde— y directa cuando un tercero paga por acceder a los datos, a análisis derivados o a un servicio construido sobre ellos. La investigación del MIT CISR que recogen Barbara Wixom, Cynthia Beath y Leslie Owens en Data Is Everybody's Business (MIT Press, 2023) distingue tres vías —mejorar procesos, enriquecer productos con datos y vender soluciones de información— y precisa que vender incluye vender conocimiento que resuelve problemas, además de ceder datos.
Una API de datos es una interfaz programática, documentada y gobernada por la que una organización sirve datos o métricas a consumidores internos o externos bajo un contrato explícito. Se distingue de la API transaccional —la que crea un pedido o modifica una reserva— en que su materia es la lectura: series, agregados, históricos, indicadores. Esa diferencia condiciona el diseño entero, desde la caché hasta la forma de cobrar.
El producto de datos del capítulo 29 tenía dueño, usuarios identificados, compromiso de frescura, métricas de adopción y ciclo de vida. Su vertiente comercial le añade un cliente que firma, un precio (aunque sea cero), un soporte con horario y una factura o, en el consumo interno, un informe de coste por área. El data sharing es el intercambio de datos entre organizaciones o dominios sin que el consumidor tenga que copiarlos ni reconstruirlos: el proveedor concede un acceso de lectura gobernado y revocable, normalmente desde su propia plataforma. Y el contrato de consumo es el acuerdo, técnico y jurídico a la vez, que fija qué se sirve, con qué significado y garantías, cuánto puede consumir cada cliente, a qué precio y para qué usos.
Con esas definiciones, las cifras del sector infomediario se leen de otra forma: quien factura sobre datos públicos gratuitos vende la normalización, el cruce con otras fuentes, la frescura garantizada, una interfaz estable y la responsabilidad de que la cifra sea correcta. El valor está en el empaquetado, y el empaquetado cuesta dinero. Quien se plantea vender sus datos suele olvidar alguna de las dos mitades de esa frase.
Los cuatro niveles de monetización del dato
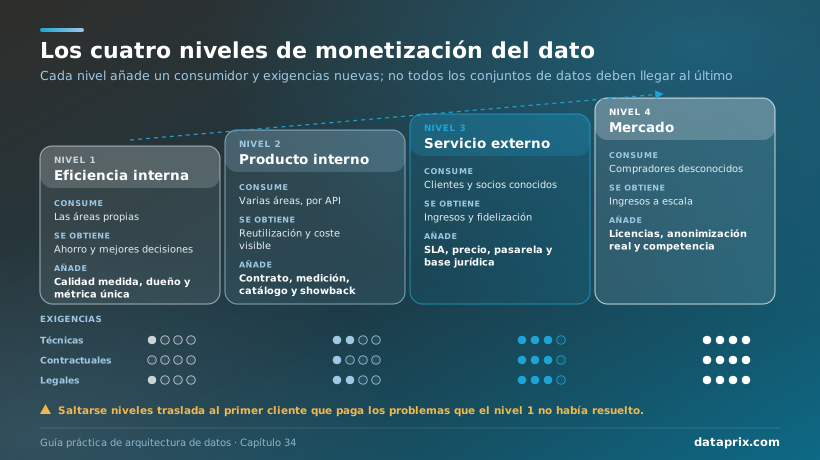
La pregunta «¿cuánto ganaríamos vendiendo nuestros datos?» suele llegar al comité de dirección antes que otra más útil: en qué nivel opera hoy cada conjunto de datos y qué le falta para el siguiente. Los cuatro niveles de monetización del dato ordenan la respuesta. Cada nivel añade un tipo de consumidor y, con él, requisitos técnicos, contractuales y legales que el anterior no tenía.
El nivel 1, eficiencia interna, es el dato que mejora decisiones y procesos propios: una previsión de demanda que abarata las compras, un modelo que anticipa impagos, un cuadro que acorta un cierre contable. No se factura nada y, sin embargo, ahí suele concentrarse la mayor parte del valor, que se mide con las herramientas del capítulo 2, como el ROI Canvas. Su requisito es la disciplina de las partes anteriores de la guía: calidad medida, un dueño con nombre y una definición única en la capa semántica.
El nivel 2, producto interno, convierte ese dato en un servicio que consumen varias áreas, por API o como conjunto compartido, con cuotas y con el coste a la vista. En el showback, cada área recibe un informe de lo que ha consumido y de lo que ha costado; en el chargeback, ese coste se imputa a su presupuesto. Este nivel introduce la medición del consumo, un acuerdo de servicio interno y el catálogo donde se descubre el producto, el inventario vivo del capítulo 27.
El nivel 3, servicio externo, abre el producto a clientes, socios o proveedores mediante una API o un portal, y con ellos llegan el contrato con un tercero, el acuerdo de nivel de servicio con consecuencias, el precio, la facturación, el soporte y una pregunta legal nueva: con qué base jurídica salen esos datos de la empresa y quién responde de ellos después.
El nivel 4, mercado, publica el dato para consumidores que no se conocen de antemano, en el marketplace de una plataforma, en un espacio de datos sectorial o en un portal de datos abiertos. Las licencias se estandarizan, la anonimización tiene que ser real porque nadie controla qué cruzará el comprador, la competencia importa si los compradores compiten entre sí, y operar el mercado para terceros puede convertir a la organización en un intermediario regulado.
Los niveles no forman un recorrido obligatorio. Muchos conjuntos de datos deben quedarse en el 1 o el 2 para siempre, porque su valor es interno o porque la ley no permite más. Lo que el marco sí establece es el orden: saltarse niveles es el origen más habitual de los fracasos, porque cada nivel pone a prueba lo que el anterior debería haber resuelto. Un dato que nadie usa con rigor dentro de la empresa llega al cliente externo con sus errores intactos, y el primero en descubrirlos es alguien que paga.
| Nivel | Quién consume | Qué se obtiene | Requisito técnico nuevo | Requisito contractual o legal nuevo |
|---|---|---|---|---|
| 1. Eficiencia interna | Las áreas que producen el dato y las que deciden con él | Ahorro, ingreso protegido, decisiones mejores | Calidad medida, dueño, métrica en la capa semántica | Finalidad compatible con la que justificó la recogida |
| 2. Producto interno | Varias áreas, por API o conjunto compartido | Reutilización y coste visible (showback o chargeback) | Contrato versionado, medición del consumo, catálogo | Acuerdo de servicio interno y acceso por perfil |
| 3. Servicio externo | Clientes, socios y proveedores conocidos | Ingresos por suscripción o uso, fidelización, cumplimiento de obligaciones | Pasarela, autenticación de terceros, facturación, soporte | Contrato con SLA, precio y condiciones de uso; base jurídica para ceder; papel de cada parte en el RGPD |
| 4. Mercado | Consumidores no conocidos de antemano | Ingresos a escala, presencia en un ecosistema | Listados, licencias estándar, controles de exportación | Anonimización verificable, derecho de la competencia, posible régimen de intermediación |
Criterio de decisión. Un conjunto de datos sube al nivel siguiente solo cuando supera cuatro pruebas en el actual: consumo interno estable y medido, definición única en la capa semántica, coste de servir conocido y base jurídica documentada para el nuevo tipo de consumidor. La prueba que falte la exigirá el nivel siguiente, con un cliente esperando.
Corvenia Energía: de vender perfiles de consumo a servir un contrato
Corvenia Energía es una comercializadora de electricidad y gas ficticia, compuesta a partir de situaciones habituales del sector energético español, y servirá de hilo al resto del capítulo. Su cartera es mayoritariamente residencial, con un segmento de empresas que crece deprisa: cadenas de tiendas, cooperativas, ayuntamientos y grupos con decenas o cientos de suministros en varias provincias. Como cualquier comercializadora, recibe de las distribuidoras las lecturas de consumo de sus clientes para facturar, de modo que acumula curvas horarias de cientos de miles de suministros.
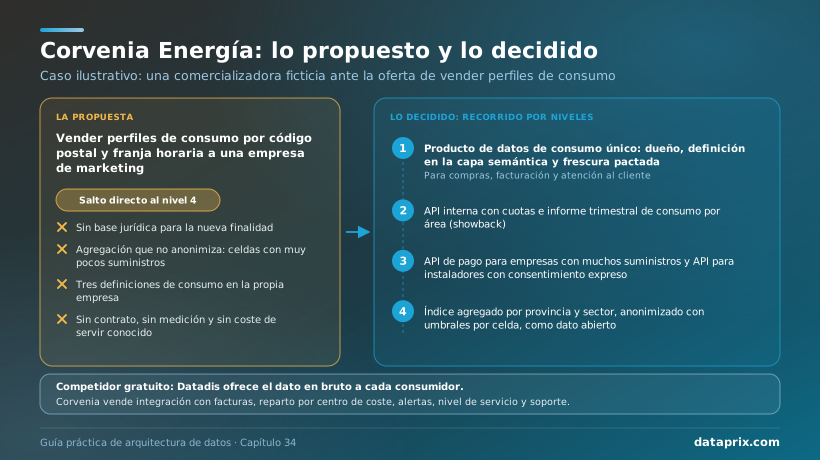
La propuesta que llegó al comité de dirección tenía aspecto de dinero fácil. Una empresa de datos de marketing ofrecía comprar perfiles de consumo por código postal y franja horaria para orientar campañas de autoconsumo solar y de climatización, y el director comercial traía incluso un precio por perfil. El equipo de datos pidió dos semanas y volvió con un diagnóstico ordenado según los cuatro niveles.
En el nivel 1, Corvenia estaba peor de lo que creía. El área de compra de energía, que necesita prever el consumo de su cartera para reducir el coste de los desvíos entre lo que compra en el mercado y lo que sus clientes consumen, trabajaba con una definición de consumo distinta de la de facturación, y atención al cliente mantenía sus propias extracciones. Nadie era dueño del dato. En el nivel 2 no había nada que medir: ni API interna, ni catálogo, ni coste imputado. Y el salto directo al nivel 4 chocaba con la ley. La curva horaria de un hogar revela horarios y ocupación; esos datos se habían obtenido para facturar, y venderlos exigía una base jurídica que Corvenia no tenía. Agrupar por código postal tampoco los convertía en anónimos: en algunos códigos postales rurales, una celda podía contener tres suministros.
El comité no vendió los perfiles. Aprobó en su lugar un recorrido por niveles con objetivos medibles. Primero, un único producto de datos de consumo, con la definición en la capa semántica, un dueño en el área de operaciones y un compromiso de frescura, que alimentase a compras, facturación y atención al cliente. Después, una API interna con cuotas y un informe trimestral de consumo por área. En tercer lugar, una API de datos para clientes empresariales, de pago, y otra para instaladores y empresas de servicios energéticos a la que solo se accede con el consentimiento expreso de cada cliente. Por último, un índice de consumo agregado por provincia y sector, anonimizado con umbrales mínimos por celda, para publicarlo como dato abierto.
La API para empresas tenía un competidor gratuito que conviene no ignorar. Datadis, la plataforma creada por las distribuidoras eléctricas españolas, permite a los consumidores consultar sus datos de consumo sin coste y autorizar el acceso de terceros. Un cliente con cien suministros puede obtener ahí sus curvas. Lo que no obtiene es lo que Corvenia decidió vender: esas curvas integradas en un único modelo con sus facturas y sus contratos, conciliadas para detectar errores de facturación, repartidas por centro de coste, con alertas de consumo anómalo, un nivel de servicio por contrato y alguien al teléfono cuando algo no cuadra. El dato en bruto ya era gratis; el producto, no.
El contrato de consumo: un contrato de datos con cliente
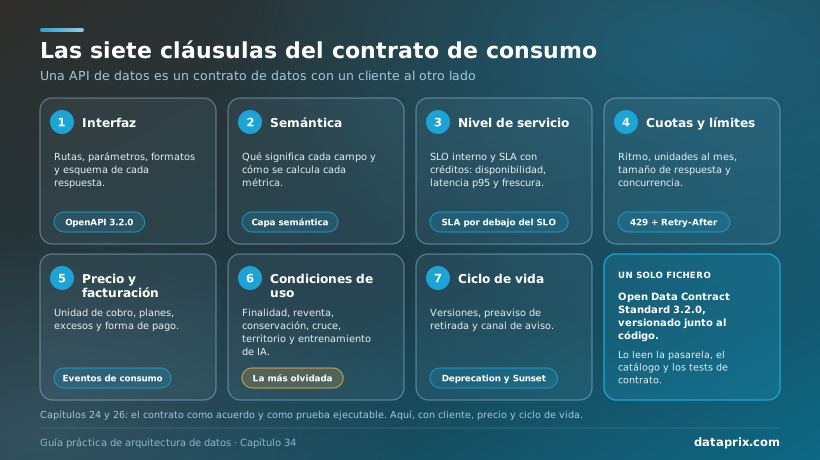
La guía ha tratado los contratos de datos dos veces. El capítulo 24 los presentó como acuerdo entre productores y consumidores, con niveles de servicio de calidad medibles, y el capítulo 26 les dio una dimensión ejecutable: un contrato que se verifica en integración continua antes de cada cambio. Una API de datos es ese mismo contrato con un cliente al otro lado, y el cliente añade exigencias que un equipo interno toleraba mejor. En la práctica, el contrato de consumo tiene siete cláusulas.
La primera es la interfaz: rutas, parámetros, formatos y esquema de cada respuesta, descritos en un estándar legible por máquina; para APIs REST, la referencia habitual es la especificación OpenAPI, cuya versión 3.2.0 se publicó en septiembre de 2025. La segunda es la semántica: qué significa cada campo y cómo se calcula cada métrica. Aquí la API no debería inventar nada. Si la organización tiene una capa semántica como la del capítulo 30, la API sirve sus definiciones; si no la tiene, cada API nueva es una ocasión de fabricar otra versión de la verdad.
La tercera es el nivel de servicio, con dos términos que conviene separar. El SLO es el objetivo interno —disponibilidad, latencia en el percentil 95, frescura— con su presupuesto de error, como planteaba el capítulo 5; el SLA es el compromiso contractual con el cliente, con consecuencias si se incumple, normalmente créditos sobre la factura. Un SLA prudente promete menos que el SLO, para que quede margen entre lo que se persigue y lo que se paga. La cuarta cláusula son las cuotas y límites (peticiones por segundo, unidades al mes, tamaño de respuesta, concurrencia), y la quinta, el precio y la facturación: unidad de cobro, planes, excesos y forma de pago.
La sexta, las condiciones de uso, es la que a menudo se descuida y la que más disgustos evita. Fija la finalidad permitida, si el cliente puede redistribuir o revender, cuánto tiempo puede conservar los datos, si puede combinarlos con otros, en qué territorios y, cada vez con más frecuencia, si puede usarlos para entrenar modelos de inteligencia artificial. La séptima es el ciclo de vida: cómo se versiona la API, con cuánta antelación se avisa de una retirada y por qué canal.
Las siete cláusulas caben en un único fichero versionado. El Open Data Contract Standard (ODCS), del proyecto Bitol en la fundación LF AI & Data y en su versión 3.2.0, reserva secciones para el esquema, la calidad, el soporte, los roles, el nivel de servicio y el precio. Ese fichero lo leen la pasarela, que aplica las cuotas; el catálogo, que lo publica; y los tests de contrato, que bloquean los cambios que lo incumplen. Con el contrato en el repositorio, junto al código, el acuerdo comercial y el técnico dejan de poder divergir.
En Corvenia, la primera versión del contrato de la API para empresas quedó así, con cifras ilustrativas: disponibilidad mensual del 99,5 %; datos disponibles en la API como máximo cuatro horas después de recibirlos de la distribuidora; latencia inferior a un segundo en el percentil 95 para consultas de hasta un mes de datos horarios de un suministro; tres planes según el número de suministros; uso limitado a la gestión energética del propio cliente, sin reventa; y aviso de seis meses antes de retirar una versión.
Diseñar la interfaz: cuatro formas de servir datos
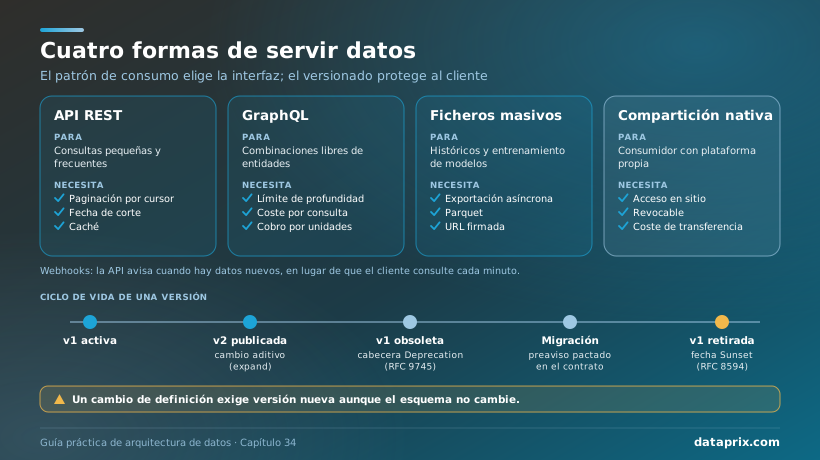
Una API REST no es la única forma de servir datos, ni siempre la mejor. El patrón de consumo decide la interfaz, y en una misma organización suelen convivir tres o cuatro.
La API REST sirve consultas pequeñas y frecuentes sobre recursos bien definidos: el consumo de un suministro en un periodo, el índice de un mes. Es fácil de cachear, documentar e integrar para un socio con pocos medios. Necesita paginación por cursor, porque la paginación por desplazamiento devuelve duplicados cuando los datos cambian entre páginas, y, en datos que se corrigen a posteriori, un parámetro de fecha de corte que permita repetir una consulta con idéntico resultado, algo que cualquier auditor agradece.
GraphQL encaja cuando el consumidor necesita combinar entidades con libertad y cada pantalla pide algo distinto. El precio de esa libertad es que una consulta puede costar mil veces más que otra, así que exige límites de profundidad, un análisis del coste de cada consulta antes de ejecutarla y, en APIs de pago, cobrar por unidades de coste en lugar de por llamada.
Para volúmenes grandes —un histórico completo, el entrenamiento de un modelo— están los ficheros masivos: el cliente solicita una exportación asíncrona, recibe un identificador de trabajo y descarga un fichero Parquet mediante una URL firmada y temporal. Si tiene su propia plataforma de datos, la compartición en sitio del apartado siguiente evita incluso el fichero. Y para avisar de cambios están los webhooks, notificaciones que la API envía cuando hay datos nuevos, en lugar de que el cliente pregunte cada minuto.
Sea cual sea la interfaz, una API externa no debería consultar el almacén de datos en cada llamada: recibe picos que nadie controla, y el presupuesto de latencia del capítulo 32 se aplica con más rigor que en un cuadro de mando. Tablas precalculadas, una caché que se invalida al cargar —el capítulo 13 explica cuándo compensa— o un motor de servicio analítico separan el tráfico de los clientes del trabajo interno de la plataforma.
Versionar el esquema y también la definición
El versionado es el punto donde las APIs de datos rompen más relaciones comerciales. Los cambios aditivos, como un campo nuevo o un filtro opcional, no rompen a nadie; eliminar o renombrar campos y cambiar tipos sí, y exige una versión mayor. El patrón expand/contract del capítulo 17 se aplica igual a una API: primero se añade lo nuevo, después se migra a los clientes y al final se retira lo viejo. Para anunciar la retirada hay cabeceras estándar: Deprecation, definida en el RFC 9745 de marzo de 2025, indica desde cuándo un recurso está obsoleto, y Sunset, del RFC 8594, cuándo dejará de responder. Los errores, por su parte, ganan mucho si siguen el formato Problem Details del RFC 9457, que los clientes pueden tratar de forma uniforme.
Hay un cambio que ninguna herramienta detecta y que es el más dañino: el cambio de semántica. Si la fórmula de una métrica cambia y el esquema no, los tests de contrato pasan, la API responde igual y los modelos de los clientes empiezan a calcular otra cosa. Una definición nueva merece una versión nueva aunque no cambie un solo campo, y el contrato debería fijar con cuánta antelación se anuncia.
Cuotas, límites y medición: la pasarela como contador
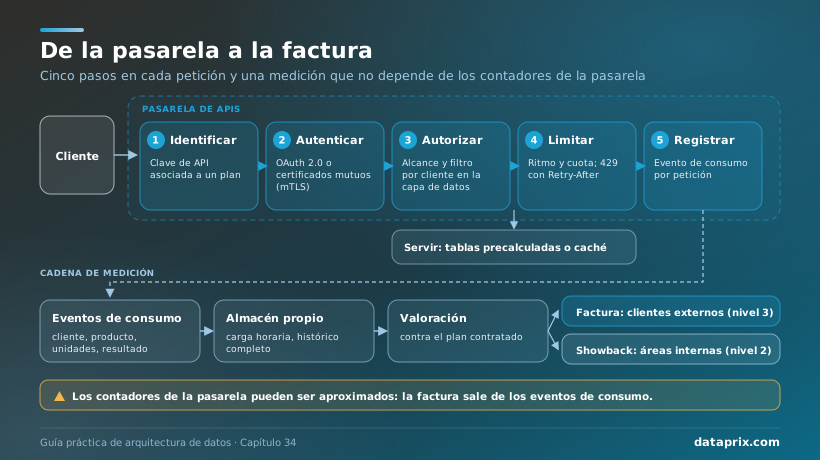
Entre el cliente y los datos se sitúa una pasarela de APIs (API gateway) que hace en cada petición, y por este orden, cinco cosas: identificar al cliente, autenticarlo, comprobar qué puede ver, limitar cuánto consume y registrar lo consumido. Cada una tiene su error típico.
Identificar y autenticar son pasos distintos. Una clave de API identifica a quién consume, y por eso sirve para asociar cuotas y planes, pero es un secreto compartido que viaja en cada petición. La documentación de Amazon API Gateway lo dice sin rodeos: no hay que usar las claves de API para autenticar ni para autorizar. Con terceros, lo razonable es OAuth 2.0 con credenciales de cliente o certificados mutuos (mTLS), y reservar la clave para asociar el consumo a un plan.
Autorizar es una pregunta sobre datos. Que un cliente pueda llamar a /consumos no significa que pueda ver los consumos de cualquiera. La pasarela comprueba el alcance (scope) de la credencial, pero el filtro por cliente debe aplicarse en la capa de datos, con la misma seguridad por fila que el capítulo 30 pedía definir una sola vez. Una API que filtra solo en el código del endpoint está a un error de programación de enseñar a un cliente los datos de otro.
Limitar tiene dos escalas. El límite de ritmo (rate limit) protege la plataforma de las ráfagas; la cuota fija el consumo del periodo contratado. Al superar cualquiera de los dos, la respuesta estándar es un 429 Too Many Requests con la cabecera Retry-After, el mismo error que el capítulo 22 enseñaba a encajar desde el lado del consumidor. Las cabeceras que informan del consumo restante aún no tienen un estándar cerrado —el IETF las trabaja como borrador con el título RateLimit header fields for HTTP—, así que conviene documentar en el contrato las que use cada API. Hasta los servicios públicos gratuitos ponen límites: según datos.gob.es, la API de AEMET exige una clave gratuita y admite 50 peticiones por minuto. Un precio cero no elimina el contrato.
Medir exige algo más que los contadores de la pasarela. Es la lección menos intuitiva. En la misma página, AWS advierte de que la limitación y las cuotas de sus planes de uso no son límites estrictos, de que algunos clientes pueden superarlas y de que no deben usarse para controlar costes. Si esos contadores no son exactos, tampoco sirven para facturar. La medición fiable se construye con eventos de consumo: cada petición atendida emite un registro con el cliente, el producto, las unidades y el resultado, que se acumula en un almacén propio, se valora contra el plan del cliente y se convierte en factura o, en el nivel 2, en informe de showback.
Las plataformas comerciales cubren esa cadena con piezas distintas. Apigee incluye un módulo de monetización con planes de tarifas, saldos de prepago e informes. Azure API Management organiza las APIs en productos y suscripciones, aplica cuotas y límites por clave y, según su documentación de monetización, delega el cobro en un proveedor de pagos como Stripe o Adyen. Kong adquirió OpenMeter en septiembre de 2025 para integrar la medición y la facturación por uso en su plataforma Konnect, y mantuvo OpenMeter como proyecto de código abierto con licencia Apache 2.0. Amazon API Gateway ofrece planes de uso con claves, con las salvedades citadas.
Corvenia separó las dos funciones desde el principio: la pasarela aplica límites de ritmo generosos y cuotas por plan, y la facturación sale de los eventos de consumo, que se cargan cada hora en su plataforma de datos. Los mismos eventos alimentan el informe trimestral que reciben compras, facturación y atención al cliente por su uso de la API interna, y fue ese informe, más que cualquier norma, lo que acabó con las extracciones paralelas: cuando el coste se ve, la copia propia deja de parecer gratis.
Compartir sin copiar: compartición nativa, salas limpias y espacios de datos
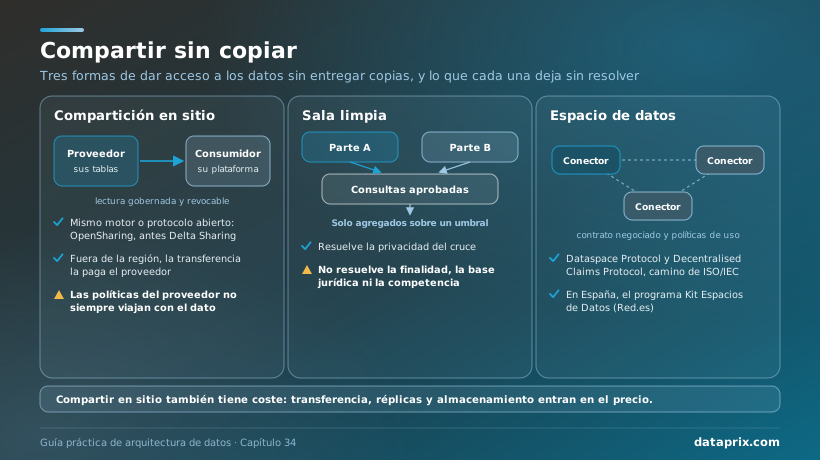
Cuando el consumidor tiene su propia plataforma de datos y quiere millones de filas, la API se queda estrecha. Las plataformas han desarrollado mecanismos de compartición en sitio: el proveedor concede acceso de lectura a sus tablas y el consumidor las consulta desde su propio entorno, sin copias que mantener ni cargas que programar. La tabla resume los principales a fecha de noviembre de 2026.
| Mecanismo | Cómo comparte | Lo que conviene vigilar |
|---|---|---|
| OpenSharing (antes Delta Sharing) | Protocolo abierto, anunciado el 10 de junio de 2026 por Databricks y la Linux Foundation como evolución de Delta Sharing; compatible con los clientes de Delta Sharing y con los del catálogo REST de Apache Iceberg | Fuera de la región o de la nube, el proveedor puede pagar la transferencia de salida; se mitiga replicando en la región del destinatario |
| Snowflake: compartición segura y Marketplace | Listados públicos o privados; el auto-fulfillment replica el producto en otras regiones y nubes | El proveedor asume la transferencia, el almacenamiento y el cómputo de esas réplicas |
| BigQuery sharing (antes Analytics Hub) | Intercambios y listados, con listados comerciales integrados en Google Cloud Marketplace | Controles de salida que impiden copiar o exportar lo compartido |
| Microsoft Fabric: compartición externa | Entre inquilinos, en sitio, mediante accesos directos de OneLake y en solo lectura | Las etiquetas de confidencialidad y la prevención de pérdida de datos del proveedor no se aplican en el inquilino consumidor, que puede dar acceso a quien quiera |
| Oracle Autonomous Database y AWS | Oracle admite el protocolo Delta Sharing; AWS combina los datashares de Amazon Redshift con AWS Data Exchange, que comercializa ficheros, APIs y datashares | Interoperabilidad real con la plataforma del destinatario y modelo de cobro del mercado |
Compartir en sitio también tiene coste. Snowflake documenta que el proveedor asume la transferencia y el almacenamiento cuando su producto se replica en otras regiones para servirlo, y Databricks recuerda que compartir dentro de la misma región no genera costes de salida, pero que entre regiones o nubes el proveedor de nube puede cobrarlos. Esa partida entra en el coste de servir y, por tanto, en el precio.
Compartir en sitio tampoco garantiza que las políticas viajen con el dato. La documentación de la compartición externa de Microsoft Fabric advierte de que la gobernanza del proveedor no se traslada al inquilino consumidor, de que quien comparte no controla quién accede en destino y de que revocar un acceso puede tener consecuencias serias para quien lo consume. Lo que la tecnología no garantiza lo tiene que cubrir el contrato: quién puede acceder, prohibición de redistribuir, derecho de auditoría y preaviso antes de revocar. BigQuery sharing cubre una parte del problema con controles de salida que impiden copiar o exportar los datos compartidos.
Cuando dos organizaciones quieren cruzar datos sin enseñárselos —un distribuidor y sus proveedores, un medio y sus anunciantes—, la herramienta es la sala limpia de datos (data clean room): un entorno en el que cada parte aporta sus datos, solo se ejecutan análisis aprobados y solo salen resultados agregados por encima de umbrales mínimos. Snowflake, Databricks, Google Cloud y AWS ofrecen la suya. Una sala limpia resuelve la privacidad del cruce, pero la finalidad, la base jurídica y las implicaciones de competencia siguen siendo preguntas del contrato.
El modelo europeo para el nivel 4 son los espacios de datos: ecosistemas, normalmente sectoriales, en los que cada participante conserva sus datos y los comparte mediante conectores que negocian contratos y aplican políticas de uso legibles por máquina. El Eclipse Dataspace Working Group impulsa hacia la normalización ISO/IEC dos protocolos abiertos, el Dataspace Protocol y el Decentralised Claims Protocol: el primero define el intercambio gobernado por control de uso y el segundo, la verificación de credenciales sin un tercero central. En España, el programa Kit Espacios de Datos, gestionado por Red.es y dotado con hasta 60 millones de euros, subvenciona la incorporación de empresas y administraciones a espacios de datos, con importes mayores para quien se incorpora como proveedor.
Poner precio: la horquilla entre el coste de servir y el valor
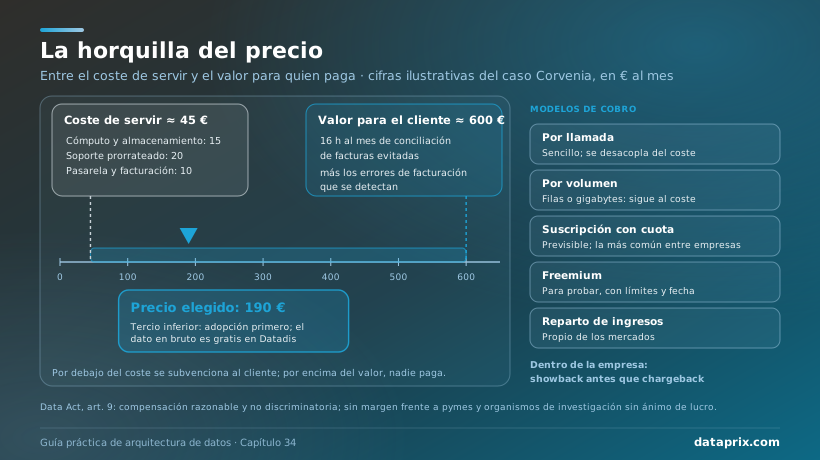
El precio de un producto de datos se mueve en una horquilla. El extremo inferior es el coste de servir: cómputo de las consultas, almacenamiento, transferencia de datos fuera de la región o de la nube (egress), la pasarela, la facturación, el soporte, la parte del equipo que mantiene el producto y el trabajo jurídico y de cumplimiento. El extremo superior es el valor para quien paga: lo que ahorra, lo que gana o lo que le costaría obtener lo mismo por otra vía, incluida la de construirlo. Por debajo del coste de servir, el proveedor subvenciona al cliente; por encima del valor, nadie paga, o se paga una sola vez.
Los modelos de cobro encajan de forma distinta en esa horquilla. El pago por llamada es fácil de explicar, pero se desacopla del coste cuando una llamada puede devolver una fila o un millón. El pago por volumen —filas, registros, gigabytes— sigue mejor al coste. La suscripción por planes con cuota es la más frecuente entre empresas, porque da previsibilidad a las dos partes. El modelo freemium sirve para que un desarrollador pruebe la API, siempre que el plan gratuito tenga límites y fecha de revisión, y el reparto de ingresos es propio de los mercados, donde la plataforma retiene una parte de cada venta. Dentro de la empresa, la elección es entre showback y chargeback, y empezar por el primero suele ser más sensato: cambia el comportamiento sin abrir una negociación presupuestaria por cada consulta. El reparto detallado de esos costes entre áreas es materia del capítulo de FinOps de la Parte VI.
El reglamento europeo de datos aporta una referencia útil incluso a quien no está obligado por él. Cuando una empresa debe poner a disposición de un tercero los datos de productos conectados, el artículo 9 del Data Act le permite pedir una compensación razonable y no discriminatoria, que puede incluir un margen salvo si el destinatario es una pyme o un organismo de investigación sin ánimo de lucro, en cuyo caso se limita a los costes. A principios de 2026, la Comisión sometió a consulta un borrador de directrices para calcularla, que solo admite los costes incrementales ligados a cada solicitud —preparar y dar formato a los datos, difundirlos, almacenarlos— y excluye los costes generales y los costes ocultos. Es una buena plantilla para justificar cualquier tarifa de datos ante un cliente exigente.
Corvenia fijó el precio de su plan intermedio, de hasta cien suministros, con un cálculo deliberadamente simple y cifras redondas que no corresponden a ninguna empresa concreta. El coste de servir por cliente y mes rondaba los 45 euros: unos 15 de cómputo y almacenamiento, 20 de soporte prorrateado y 10 de pasarela y facturación. El valor, estimado con tres clientes piloto, se acercaba a los 600 euros mensuales, sobre todo por las dieciséis horas al mes que su responsable de energía dejaba de dedicar a conciliar facturas, sin contar los errores de facturación detectados. El precio quedó en 190 euros, en el tercio inferior de la horquilla, porque el objetivo del primer año era la adopción y porque el dato en bruto seguía disponible gratis en Datadis. La cifra importa menos que el método: cada componente del coste quedó por escrito, y la conversación con el primer cliente que pidió descuento pudo hacerse sobre él.
El marco legal que decide hasta dónde se puede llegar
Cada conjunto de datos tiene un nivel máximo de monetización, y lo fijan la naturaleza del dato y la norma que le corresponde antes que cualquier estrategia comercial. Este apartado resume lo esencial sin sustituir el análisis jurídico de cada caso, que la Parte VI de la guía desarrollará en su capítulo de privacidad y cumplimiento.
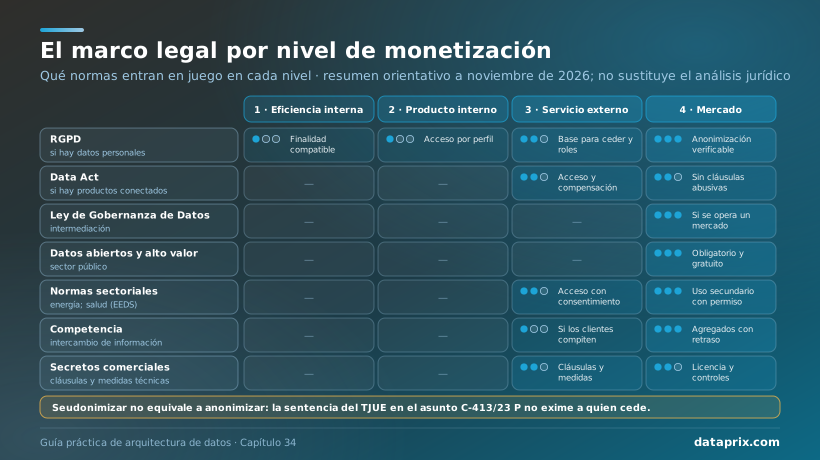
Si hay datos personales, manda el RGPD. Cederlos a un tercero exige base jurídica, y reutilizarlos para una finalidad distinta de la que justificó su recogida exige que sea compatible con ella o una base nueva, como el consentimiento. El responsable debe informar a los interesados de quiénes son los destinatarios, y el contrato con el cliente tiene que dejar claro si este actúa como encargado que trata por cuenta ajena o como responsable independiente. La frontera más malentendida es la que separa seudonimizar de anonimizar: los datos seudonimizados, con los identificadores sustituidos por códigos, siguen siendo personales para quien conserva la correspondencia, mientras que los anonimizados han perdido de forma irreversible cualquier vínculo razonable con la persona. El Comité Europeo de Protección de Datos dedica a la seudonimización sus directrices 01/2025.
La sentencia del Tribunal de Justicia de la Unión Europea de 4 de septiembre de 2025, en el asunto C-413/23 P, matizó esa frontera: unos datos seudonimizados pueden no ser personales para un destinatario que no dispone de medios razonables para reidentificar a nadie. Pero la sentencia no exime a quien los cede, para quien siguen siendo personales: necesita base jurídica para la cesión y debe informar a los interesados. Ayuda a delimitar las obligaciones del comprador y deja intactas las del vendedor.
El Data Act, el Reglamento (UE) 2023/2854, se aplica desde el 12 de septiembre de 2025. Da a los usuarios de productos conectados el derecho a acceder a los datos que generan y a pedir que se compartan con terceros, regula la compensación de esas cesiones, deja sin efecto las cláusulas abusivas impuestas unilateralmente en los contratos de datos entre empresas y, desde el 12 de septiembre de 2026, obliga a diseñar los nuevos productos conectados para que esos datos sean accesibles. La Comisión ha publicado modelos de cláusulas contractuales, de uso voluntario, para estas cesiones. Para un fabricante que explotaba en exclusiva los datos de sus equipos, el reglamento cambia el modelo de negocio: el dato deja de ser un monopolio y el valor tiene que estar en el servicio. Conviene seguir, además, la propuesta de Ómnibus Digital de noviembre de 2025, que modificaría el Data Act y trasladaría a él las normas de la Ley de Gobernanza de Datos, de la directiva de datos abiertos y del reglamento de libre circulación de datos no personales; el Consejo fijó su posición negociadora el 21 de octubre de 2026 y el Parlamento no prevé votar la suya en comisión antes de 2027. Hasta que haya texto final, rige el vigente.
La Ley de Gobernanza de Datos, el Reglamento (UE) 2022/868, importa a quien piensa en el nivel 4 como operador y no solo como vendedor. Un servicio que pone en contacto a titulares y usuarios de datos puede ser un servicio de intermediación de datos, y entonces debe notificarse a la autoridad competente, separarse estructuralmente de los demás servicios de la empresa, actuar con neutralidad y abstenerse de explotar en beneficio propio los datos que intermedia. Montar un mercado de datos para terceros puede ser, por tanto, una actividad regulada antes que un proyecto tecnológico.
Algunos sectores tienen reglas propias. En energía, la Directiva (UE) 2019/944 obliga a organizar el acceso de los consumidores, y de las partes que ellos autoricen, a sus datos de medición y consumo, y el Reglamento de Ejecución (UE) 2023/1162 fija los requisitos de interoperabilidad de ese acceso. En sanidad, el Reglamento (UE) 2025/327 del Espacio Europeo de Datos de Salud, en vigor desde el 26 de marzo de 2025 y aplicable con carácter general desde el 26 de marzo de 2027, canaliza el uso secundario de los datos sanitarios a través de organismos de acceso y permisos de datos, con la mayor parte de ese régimen aplicable desde el 26 de marzo de 2029; cualquier monetización de datos de salud tendrá que encajar en ese cauce. Y en el sector público, los datos de alto valor del principio del capítulo cierran el círculo: ahí la norma ya ha decidido que el nivel es el 4 y el precio, cero.
Queda el derecho de la competencia, que se olvida con facilidad cuando los compradores de un conjunto de datos compiten entre sí. Las directrices de la Comisión sobre acuerdos de cooperación horizontal de 2023 dedican un capítulo al intercambio de información: los datos agregados, históricos y no individualizados reducen el riesgo, y los datos actuales y desagregados sobre precios o volúmenes de competidores lo aumentan.
Riesgo legal: seudonimizar no equivale a anonimizar. Sustituir el nombre y el número de suministro por un código mantiene los datos dentro del RGPD para quien conserva la correspondencia, y agrupar por zonas pequeñas no basta cuando una celda contiene pocas personas. Antes de vender o ceder datos derivados de personas, la anonimización debe superar una prueba de reidentificación documentada —con atacantes razonables, los datos auxiliares disponibles y umbrales mínimos por celda— y validarse con el delegado de protección de datos. Si no la supera, el dato sigue siendo personal y el nivel 4 queda cerrado.
Tres escenarios: dónde se tuerce la monetización en otros sectores
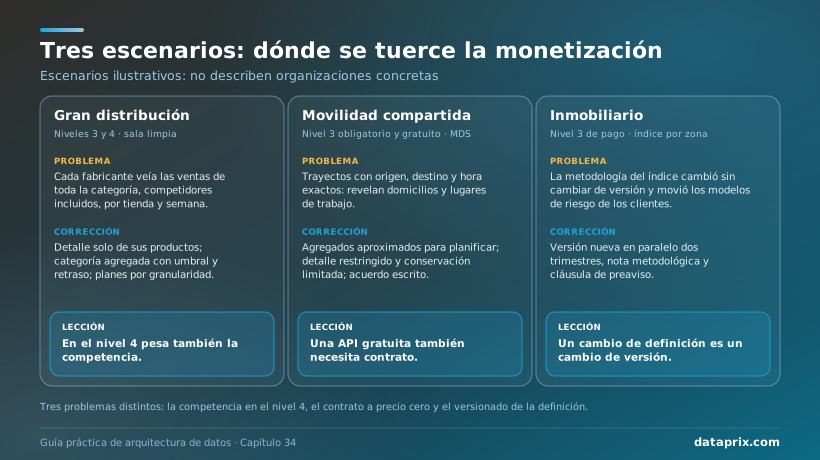
Los escenarios siguientes son ilustrativos: no describen organizaciones concretas, y cada uno se ha elegido para mostrar un problema distinto.
Gran distribución: datos de venta para los fabricantes
Una cadena de supermercados decide vender a sus proveedores el acceso a los datos de venta por tienda y producto a través de una sala limpia. El primer diseño daba a cada fabricante las ventas de toda la categoría, incluidas las referencias de sus competidores, semana a semana y tienda a tienda. El área jurídica lo frenó: entre fabricantes que compiten, ese nivel de detalle se parece demasiado a un intercambio de información sensible. El diseño final muestra a cada fabricante sus propios productos con detalle y la categoría solo en agregados regionales con umbrales mínimos y varias semanas de retraso, y cobra por planes según la granularidad. Lección: en el nivel 4, la pregunta legal no se agota en la privacidad; la competencia pesa tanto como ella.
Movilidad compartida: la API que exige la licencia
Un operador de bicicletas y patinetes eléctricos compartidos obtiene la licencia de un ayuntamiento con una condición: compartir datos de flota y de trayectos mediante la Mobility Data Specification (MDS), el estándar abierto de la Open Mobility Foundation, cuya versión 2.0 se publicó en 2023 y ya cubre otros servicios de movilidad. El precio es cero, y la tentación fue tratarlo como un trámite técnico. El problema llegó con los trayectos: el origen y el destino exactos, con su hora, permiten deducir dónde vive y dónde trabaja cada usuario habitual. El acuerdo final separó dos usos —datos agregados y con ubicaciones aproximadas para la planificación, y detalle con acceso restringido y conservación limitada para la inspección— y los puso por escrito con finalidad, plazos y responsables. Lección: una API obligatoria y gratuita también necesita contrato, y su beneficio, conservar la licencia, es monetización indirecta.
Inmobiliario: el índice que cambió sin cambiar de versión
Una empresa de valoración inmobiliaria vende a entidades financieras y sociedades de tasación una API con un índice de precios de vivienda por zona, que esos clientes usan en sus modelos de riesgo. Un trimestre cambia la metodología: el índice deja de apoyarse en precios de oferta y pasa a ajustarse con precios de transacción. La API no cambió de versión, porque el esquema era idéntico, pero el índice de varias zonas se movió de golpe y los modelos de los clientes con él. Dos clientes pidieron explicaciones por escrito y uno no renovó. La corrección fue publicar el nuevo índice como versión distinta, en paralelo durante dos trimestres, acompañar cada cambio de una nota metodológica y añadir al contrato una cláusula de preaviso. Lección: un cambio de definición es un cambio de versión, aunque el esquema no se mueva.
Anti-patrones: del fichero enviado por correo al mercado vacío
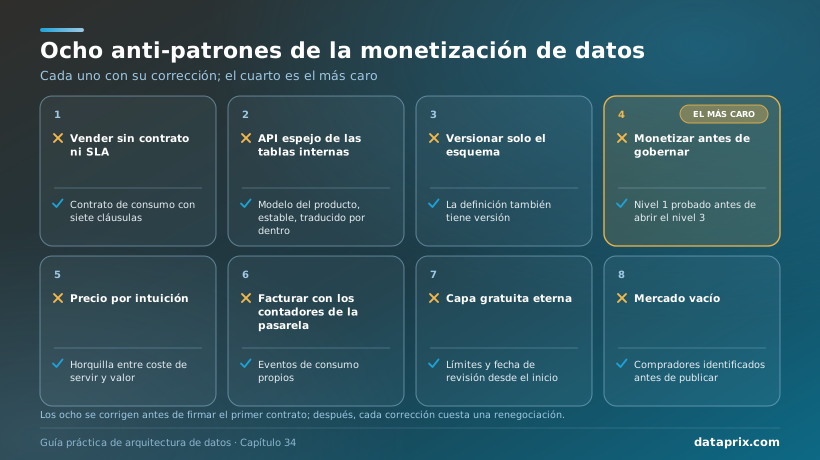
Los errores de la monetización de datos se repiten con una regularidad que permite catalogarlos. El primero es vender sin contrato ni nivel de servicio: extracciones que salen hacia un socio por correo o por SFTP con un acuerdo verbal, sin finalidad escrita, sin plazo de conservación, sin forma de revocarlas y sin nadie que responda si llegan mal. Funcionan hasta el día en que el socio las usa para algo que nadie autorizó.
El segundo es la API espejo, que expone las tablas internas tal como están, con sus nombres y sus rarezas. Se construye deprisa y ata a los clientes al modelo interno: cada refactorización de la plataforma se convierte en una negociación con terceros. Una API de datos debe exponer el modelo del producto, estable y documentado, y traducir por dentro. El tercero es versionar solo el esquema, el error del índice inmobiliario. El cuarto, y el más caro, merece recuadro propio.
El anti-patrón más caro: monetizar antes de gobernar. Abrir un servicio externo sobre datos que la propia organización no usa con disciplina traslada al cliente los problemas que nadie había detectado: métricas con varias definiciones, cargas que fallan sin aviso, datos personales mal clasificados. El primer cliente que paga hace de auditor de calidad, y lo hace con un contrato en la mano. Un buen indicador previo es si el área que produce el dato confía en él lo suficiente para decidir con él.
El quinto es el precio por intuición, que suele olvidar la transferencia entre regiones, el soporte y el trabajo jurídico, y que produce planes que pierden dinero justo con los clientes que más consumen. El sexto, facturar con los contadores de la pasarela, que no se diseñaron para eso. El séptimo, la capa gratuita eterna: un plan sin coste, sin límites claros y sin fecha de revisión que después nadie se atreve a retirar. El octavo, confundir seudonimizado con anónimo, ya descrito en el apartado legal. Y el noveno es el mercado vacío: publicar listados en un marketplace sin haber hablado con un solo comprador, porque el nivel 4 parecía el más ambicioso. Un listado sin demanda cuesta lo mismo de mantener que uno con ella.
Selección de software: pasarelas, compartición nativa y medición
La tecnología de la monetización de datos se reparte en familias que rara vez cubre un único producto, y el directorio de Dataprix las recoge en varios rankings con el veredicto editorial de cada opción. El ranking de plataformas de datos, encabezado por Oracle Autonomous Database, Amazon Aurora y Azure SQL Database, incluye también Snowflake, Databricks y Google BigQuery, las tres con compartición y mercado nativos. El ranking de herramientas de integración de datos 2026, con Informatica Data Integration & Engineering, Azure Data Factory y Oracle Data Integrator en cabeza, recoge plataformas de virtualización como Denodo, capaces de publicar vistas de datos como servicios. Y el ranking de plataformas de gobernanza del dato sitúa en cabeza a Informatica Intelligent Data Management, IBM Watson Knowledge Catalog y Atlan, junto a Collibra, con catálogos que sirven de mercado interno de productos de datos en el nivel 2. El directorio no tiene aún una categoría propia de gestión de APIs, así que esta tabla añade las pasarelas más extendidas, a fecha de noviembre de 2026.
| Familia | Opciones habituales | Niveles | Qué comprobar en la demostración |
|---|---|---|---|
| Pasarelas comerciales de gestión de APIs | Azure API Management, Apigee, Kong Konnect, Amazon API Gateway, MuleSoft Anypoint Platform | 2 y 3 | Cuotas por producto y por cliente, portal de desarrolladores, exportación de eventos de consumo |
| Pasarelas de código abierto | Apache APISIX, Tyk, Gravitee, WSO2 API Manager | 2 y 3 | Coste de operarlas (capítulo 12), complementos de cuota, alta disponibilidad |
| Compartición nativa y mercados | Snowflake Marketplace, OpenSharing en Databricks, BigQuery sharing, compartición externa de Microsoft Fabric, Oracle Autonomous Database, AWS Data Exchange | 3 y 4 | Interoperabilidad entre plataformas, quién paga la transferencia, revocación, controles de exportación |
| Medición y facturación por uso | Monetización de Apigee, Kong Konnect con OpenMeter, proveedores de pago integrados con Azure API Management | 2 a 4 | Unidad de consumo configurable, conciliación con la pasarela, exportación al ERP |
| Catálogo y mercado interno | Collibra, Informatica, Atlan; OpenMetadata o DataHub en código abierto | 2 | Contrato visible en la ficha del producto, solicitud de acceso con aprobación, linaje hasta la API |
| Espacios de datos | Conectores basados en Eclipse Dataspace Components y en el Dataspace Protocol | 4 | Conformidad con el protocolo, políticas de uso, gestión de identidades |
Las funciones cambian con cada versión; las preguntas para la demostración, hecha con un cliente de prueba y un plan real, se mantienen. Qué unidad de consumo admite la medición y si coincide con la que el contrato va a facturar. Si las cuotas son estrictas o aproximadas, y qué ocurre en el límite. Cómo se exportan los eventos de consumo al almacén propio. Cómo se anuncia y se aplica la retirada de una versión. Dónde se aplica el filtro por cliente: en la pasarela, en el código o en la capa de datos. Y, en la compartición nativa, quién paga la transferencia y cuánto tarda en surtir efecto una revocación. A juicio de la redacción de Dataprix, la medición pesa más que la pasarela en el éxito de un programa de monetización: una pasarela se sustituye en semanas, y un histórico de consumo mal medido no se reconstruye.
Checklist operativo: antes de abrir la primera API de datos
- Clasificar cada conjunto de datos candidato en su nivel actual y en el máximo que permite su naturaleza jurídica.
- Comprobar que el nivel 1 funciona: dueño con nombre, calidad medida y definición única en la capa semántica.
- Redactar el contrato de consumo con sus siete cláusulas y guardarlo versionado junto al código.
- Separar el SLO interno del SLA contractual y dejar margen entre ambos.
- Elegir la interfaz por patrón de consumo: REST, GraphQL, ficheros masivos o compartición nativa.
- Servir desde tablas precalculadas o caché, nunca desde el almacén en cada llamada.
- Autenticar a terceros con OAuth 2.0 o mTLS y reservar la clave de API para asociar planes.
- Aplicar el filtro por cliente en la capa de datos y probarlo con un cliente de prueba por plan.
- Emitir eventos de consumo desde el primer día y facturar a partir de ellos, no de los contadores de la pasarela.
- Calcular el coste de servir por componentes, incluida la transferencia entre regiones, antes de fijar el precio.
- Definir la política de versiones, el plazo de aviso y el uso de las cabeceras Deprecation y Sunset.
- Documentar la base jurídica de cada cesión, el papel de cada parte en el RGPD y, si se anonimiza, la prueba de reidentificación.
- Revisar con el área jurídica el derecho de la competencia cuando los compradores compitan entre sí.
- Publicar el producto en el catálogo con su contrato visible y un informe de consumo por cliente o por área.
Formación recomendada
Para los equipos que van a diseñar, proteger y operar APIs de datos, y para quienes deciden qué datos pueden salir de la organización, estas opciones están directamente relacionadas con el capítulo:
- Azure API Management (DataCamp, en español): curso intermedio de unas tres horas para crear, publicar y proteger APIs, con un capítulo dedicado a la seguridad y la optimización y otro a la automatización del ciclo de vida y la observabilidad.
- Introducción a FastAPI (DataCamp): curso intermedio de unas cuatro horas para construir APIs en Python, con operaciones HTTP, validación y un ejercicio completo de API JSON.
- Privacidad de datos y anonimización en Python (DataCamp): curso avanzado de unas cuatro horas sobre técnicas de preservación de la privacidad, privacidad diferencial y anonimización de conjuntos de datos antes de publicarlos.
- PRO Azure API Management de 0 a Experto (Udemy, en español): curso práctico de unas tres horas sobre la gestión de APIs con Azure API Management, como complemento con más práctica guiada.
Enlaces de afiliado: Dataprix puede recibir una comisión si contratas a través de ellos.
Recursos y lecturas recomendadas
- Barbara H. Wixom, Cynthia M. Beath y Leslie Owens, Data Is Everybody's Business: The Fundamentals of Data Monetization (MIT Press, 2023): las tres vías de monetización —mejorar, enriquecer productos y vender— a partir de la investigación del MIT CISR.
- Mehdi Medjaoui, Erik Wilde, Ronnie Mitra y Mike Amundsen, Continuous API Management (O'Reilly, segunda edición): cómo gobernar un catálogo de APIs a lo largo de su ciclo de vida, versionado y retirada incluidos.
- Comisión Europea, página del Data Act, y la explicación de la Ley de Gobernanza de Datos, con las obligaciones de los servicios de intermediación.
- Comité Europeo de Protección de Datos, directrices 01/2025 sobre seudonimización, y la sentencia del TJUE en el asunto C-413/23 P: lectura obligada antes de ceder datos seudonimizados.
- Especificaciones de referencia: OpenAPI 3.2.0, Open Data Contract Standard, RFC 9745 (Deprecation), RFC 8594 (Sunset) y RFC 9457 (Problem Details).
- Documentación de compartición de los fabricantes: el anuncio de OpenSharing, los costes del auto-fulfillment de Snowflake, la gestión de listados de BigQuery sharing y la compartición externa de Microsoft Fabric.
- datos.gob.es: el resumen del informe del sector infomediario de ASEDIE y la guía de APIs de las administraciones públicas, con ejemplos de autenticación y cuotas en servicios públicos.
- Reglamento (UE) 2025/327 del Espacio Europeo de Datos de Salud, para cualquier proyecto que roce el uso secundario de datos sanitarios.
Preguntas frecuentes
¿Qué es la monetización de datos?
Es la obtención de un beneficio económico medible a partir de activos de datos. Puede ser indirecta, cuando los datos mejoran procesos y decisiones propios, o directa, cuando un tercero paga por acceder a los datos, a análisis derivados o a servicios construidos sobre ellos. En la mayoría de las organizaciones, la mayor parte del valor está en la vía indirecta y en el consumo interno gobernado, antes de facturar nada.
¿Qué es una API de datos?
Es una interfaz programática, documentada y gobernada por la que una organización sirve datos o métricas a consumidores internos o externos con un contrato explícito: esquema, significado de cada campo, nivel de servicio, cuotas, precio, condiciones de uso y política de versiones. A diferencia de una API transaccional, que crea o modifica registros, una API de datos se dedica a la lectura de series, agregados e indicadores.
¿Cuáles son los niveles de monetización del dato?
El marco de los cuatro niveles distingue la eficiencia interna (nivel 1), el producto interno con showback o chargeback (nivel 2), el servicio externo mediante API o portal para clientes y socios (nivel 3) y el mercado, con consumidores no conocidos de antemano (nivel 4). Cada nivel añade requisitos técnicos, contractuales y legales, y saltarse alguno es la causa más habitual de fracaso.
¿Cómo se fija el precio de una API de datos?
Dentro de una horquilla cuyo mínimo es el coste de servir —cómputo, almacenamiento, transferencia de datos, pasarela, facturación, soporte y cumplimiento— y cuyo máximo es el valor que obtiene el cliente. Los modelos más habituales son la suscripción por planes con cuota, el pago por volumen y el pago por llamada. La facturación debe calcularse a partir de eventos de consumo registrados, no de los contadores aproximados de la pasarela.
¿Se pueden vender datos personales si están seudonimizados?
Los datos seudonimizados siguen siendo datos personales para quien puede reidentificarlos, por lo que cederlos exige base jurídica, información a los interesados y un contrato que fije el papel de cada parte. La sentencia del TJUE de 4 de septiembre de 2025, en el asunto C-413/23 P, admite que pueden no ser personales para un destinatario sin medios razonables de reidentificación, pero no libera a quien los cede. Solo los datos anonimizados de forma verificable quedan fuera del RGPD.
¿Qué cambia el Data Act para quien comparte datos con otras empresas?
El Reglamento (UE) 2023/2854, aplicable desde el 12 de septiembre de 2025, da a los usuarios de productos conectados derecho a acceder a los datos que generan y a pedir que se compartan con terceros, permite al titular cobrar una compensación razonable y no discriminatoria, que puede incluir un margen salvo frente a pymes y organismos de investigación sin ánimo de lucro, y deja sin efecto las cláusulas abusivas impuestas unilateralmente en los contratos de datos entre empresas. La propuesta de Ómnibus Digital, en tramitación a finales de 2026, podría modificarlo.
Una lista pendiente: los datos que ya salen sin contrato
Hay un ejercicio que cualquier dirección de sistemas puede encargar esta semana sin comprar nada: inventariar todos los datos que hoy salen de la organización hacia terceros. Exportaciones programadas por SFTP, informes que se envían por correo a un socio, claves de API concedidas a un proveedor para una integración puntual, accesos a portales, ficheros que se entregan a una consultora. Para cada salida, cinco preguntas: quién la autorizó, con qué finalidad escrita, con qué base jurídica si hay datos personales, cuánto cuesta servirla y cómo se revocaría mañana. El inventario suele ser más largo de lo que nadie habría estimado y casi siempre contiene salidas sin contrato que funcionan desde hace años. Es el nivel 3 real de la organización, aunque nadie lo haya llamado así. Y deja una pregunta para el próximo comité: si un cliente o un regulador pidiera mañana la lista de terceros que reciben datos de la organización y para qué los usan, ¿cuánto se tardaría en entregarla?
Ordenadas esas salidas, aparece un consumidor externo distinto: el que quiere ver los datos dentro de la aplicación que ya usa, con sus filtros y sus permisos, sin integrarlos en sus propios sistemas. Para él, la API deja paso a la analítica embebida, con un riesgo que en una API se gestiona con un filtro y en un producto multicliente se vuelve existencial: enseñar a un cliente los datos de otro. El capítulo 35 se ocupa de ese consumo dentro del producto.
Siguiente en la Parte IV: capítulo 35, Embedded analytics y experiencia dentro del producto. · Capítulo anterior: Self-service analytics · Volver a la Parte IV · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 10 de noviembre de 2026.
