
Capítulo 35 · Parte IV: Business Intelligence y consumo · Guía práctica para diseñar y operar la arquitectura de datos de tu empresa
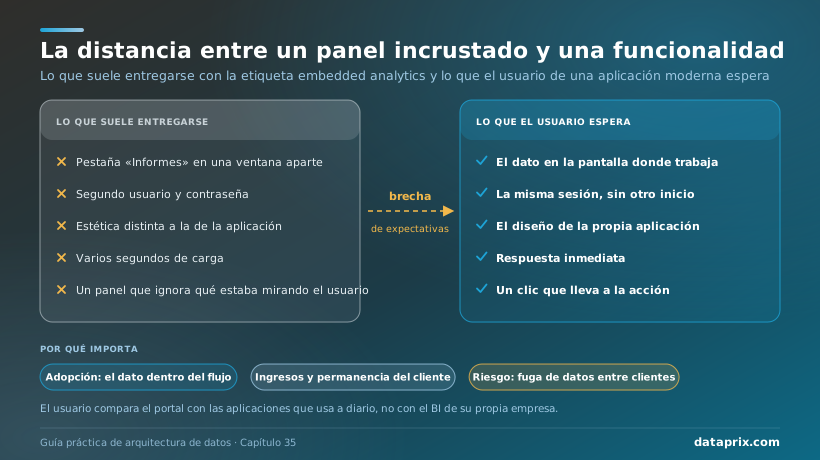
Quien consulta su banco desde el móvil ve los gastos del mes agrupados por categoría en la misma pantalla que los movimientos, con la tipografía de la aplicación, sin volver a identificarse y a un toque del cargo concreto que le ha sorprendido. Esa misma persona entra el lunes en el portal de clientes de su proveedor logístico, pulsa la pestaña «Informes» y encuentra otra cosa: una ventana con otra estética, un segundo usuario y una contraseña que nadie recuerda, una espera de varios segundos y un cuadro de mando que ignora qué envío estaba mirando hace un momento. Las dos experiencias se comercializan con la misma etiqueta, embedded analytics, y la distancia entre ellas explica por qué tantas pestañas de informes reciben clics de curiosidad el primer mes y silencio después. El usuario de una aplicación profesional compara ese portal con las aplicaciones que usa a diario, más que con el BI de su propia empresa, y en ellas los datos aparecen donde se toma la decisión. Cerrar esa brecha entre lo que el mercado llama embebido y lo que el usuario espera es un problema de producto, de arquitectura multicliente y de medición, y en ese orden lo recorre este capítulo.
En resumen. La analítica embebida no consiste en incrustar un panel en un iframe con un segundo inicio de sesión: consiste en tratar la analítica como una funcionalidad del producto, con su experiencia de uso, su seguridad multicliente y sus métricas de adopción. Se integra en tres niveles —iframe con inicio de sesión único, componentes nativos mediante SDK y modelo headless servido por API—, y conviene empezar por el nivel más bajo que resuelva la tarea del usuario en su propia pantalla. La frontera entre clientes se decide en el servidor: el identificador del cliente viaja en un token firmado, nunca en la URL, y la seguridad por filas se define una vez en la capa semántica y se comprueba con clientes ficticios en cada versión. La licencia debe crecer con la unidad de ingresos del negocio, y el éxito se mide con métricas de producto —activación, hábito, profundidad de uso y efecto en el negocio— en lugar de con aperturas de paneles.
La Parte IV ha ido ampliando el círculo de quienes consumen datos. El capítulo 31 presentó al cliente embebido como el tercer consumidor de la matriz con la que se eligen herramientas de BI, el que recibe analítica dentro de otro producto, y el capítulo 34 sacó los datos fuera de la organización mediante APIs con contrato. Este capítulo se ocupa del consumidor que no quiere integrar nada en sus sistemas: quiere ver sus datos en la aplicación que ya usa, con sus filtros y sus permisos. Para servirlo hacen falta tres disciplinas que rara vez conviven en el mismo equipo: diseño de producto, arquitectura multicliente y medición del uso.
La distancia entre un panel incrustado y una funcionalidad
Casi todas las herramientas de Business Intelligence ofrecen hoy alguna forma de «embeber». El abanico va desde un código para pegar en una página hasta kits de desarrollo con componentes, eventos y temas visuales, y la documentación de los propios fabricantes distingue entre la incrustación en iframe, la integración mediante SDK y el acceso por API. Bajo la misma palabra conviven, por tanto, productos y esfuerzos muy distintos, y la primera decisión de cualquier proyecto es nombrar con precisión qué se va a construir.
La analítica embebida (embedded analytics) es la analítica servida dentro de otra aplicación —un producto SaaS, un portal de clientes o socios, una aplicación interna— con la identidad, los permisos y la imagen de esa aplicación, de modo que el usuario no cambia de herramienta ni de sesión para consultar datos. La analítica in-product es su forma más exigente: indicadores y gráficos colocados en la pantalla donde se realiza la tarea, que reaccionan al contexto —el cliente, el pedido o el periodo que el usuario está mirando— y que conducen a una acción dentro del propio producto. Un portal con una pestaña de informes es analítica embebida; un indicador de entregas con retraso junto a la lista de envíos, que al pulsarlo filtra esa misma lista, es analítica in-product.
La diferencia importa por razones que van más allá de la estética. La primera es la adopción: un dato que exige abandonar el flujo de trabajo compite con la inercia de llamar o escribir a alguien que lo sepa, el mismo fenómeno que el capítulo 32 describía para los cuadros de mando internos. La segunda es económica: para un fabricante de software, la analítica integrada se convierte en argumento de venta, en motivo de permanencia y, a menudo, en un plan de precio superior, el servicio externo que el capítulo 34 situaba en el tercer nivel de monetización. La tercera es el riesgo. En cuanto los usuarios pertenecen a organizaciones distintas, cada consulta debe respetar una frontera entre clientes que el BI interno nunca tuvo que vigilar, y un error en esa frontera se mide en confianza perdida y en una posible brecha de datos personales, mucho más que en minutos de caída.
De esas tres razones se deduce quién debe responder del resultado. La analítica embebida tiene un dueño de producto, con objetivos de uso y de negocio, aunque se construya con herramientas y datos que gestiona el equipo de BI. El equipo de datos aporta lo que el capítulo 29 llamaba productos de datos: conjuntos certificados, métricas definidas una vez en la capa semántica y niveles de servicio de frescura. El equipo de producto decide dónde aparece cada dato, para qué tarea y cómo se mide si sirve. Cuando falta cualquiera de las dos mitades, el resultado es reconocible: datos correctos en una pestaña que nadie abre, o una experiencia atractiva sobre cifras que no cuadran con la factura.
Tres territorios: clientes, socios y equipos propios
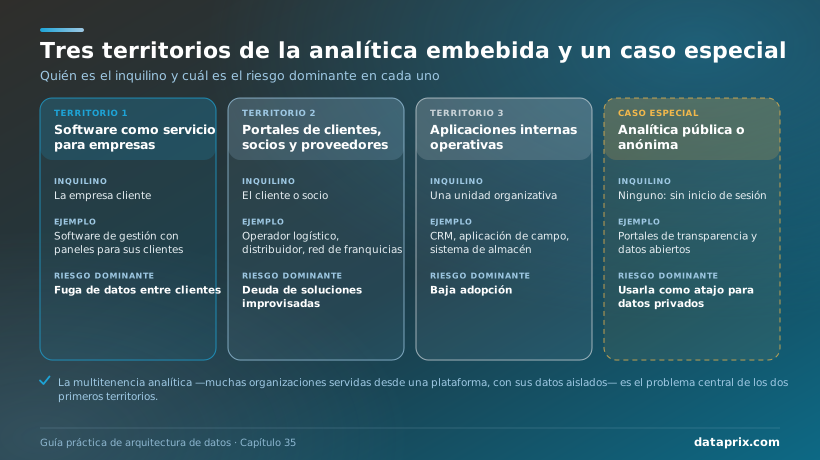
Los proyectos de analítica embebida se agrupan en tres territorios con exigencias diferentes, y conviene identificar el propio antes de elegir arquitectura.
El primero es el del software como servicio para empresas. Un fabricante de software de gestión ofrece a sus clientes paneles sobre los datos que esos mismos clientes generan en la aplicación: facturación, actividad, rendimiento de sus equipos. La analítica forma parte del producto que se vende, el número de organizaciones usuarias puede llegar a miles y cada una espera la misma calidad de experiencia que en el resto de la aplicación. Es el territorio donde la multitenencia analítica —servir a muchas organizaciones cliente desde una misma plataforma, con sus datos aislados entre sí y la posibilidad de agregarlos cuando el negocio lo necesita— se convierte en el problema central de arquitectura.
El segundo es el de los portales de clientes, socios y proveedores de empresas que no se dedican al software: un operador logístico que muestra a sus cargadores el estado de sus entregas, un distribuidor que enseña a cada fabricante la rotación de sus productos, una red de franquicias que da a cada franquiciado sus ventas comparadas con la media. Estas organizaciones se convierten en proveedoras de software sin haberlo planeado, con usuarios externos que esperan soporte, disponibilidad y una experiencia comparable a la de cualquier aplicación comercial. Es el territorio con más deuda acumulada, porque a menudo empezó como un favor a un cliente importante.
El tercero es el de las aplicaciones internas operativas: el CRM donde el comercial ve el riesgo de baja de su cartera, la aplicación de campo donde el técnico consulta el historial de averías del equipo que va a reparar, el sistema de almacén con la productividad por turno. El «inquilino» es aquí una unidad organizativa y no una empresa externa, el riesgo legal es menor y la lógica de experiencia es la misma: el dato aparece en la pantalla de la tarea.
Existe un cuarto caso, menos frecuente y con reglas propias: la analítica pública o anónima de los portales de transparencia y de datos abiertos, donde no hay inicio de sesión y la protección depende de publicar solo agregados. Los fabricantes la tratan como una modalidad aparte —Qlik, por ejemplo, documenta un acceso anónimo específico para incrustar contenido en sitios web públicos, con disponibilidad regional limitada según su documentación de 2026— y nunca debe confundirse con un atajo para enseñar datos privados sin construir la autenticación.
La escala de integración embebida
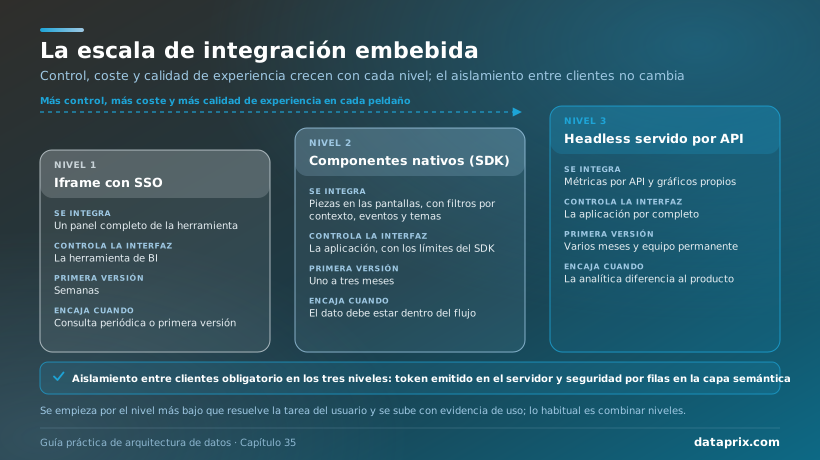
La forma de integrar la analítica en una aplicación admite muchas variantes, pero todas caen en uno de tres niveles. Ordenarlos en una escala permite discutir el proyecto con un vocabulario común y detectar los dos errores más caros: quedarse corto, con un iframe que nadie usa, o sobredimensionar, con un desarrollo a medida que reconstruye durante años lo que una herramienta ya resolvía. Es la escala de integración embebida, y en cada peldaño crecen a la vez el control sobre la experiencia, el coste de construcción y mantenimiento y la calidad que puede alcanzar el resultado.
Nivel 1: iframe con inicio de sesión único
La aplicación reserva un espacio de su pantalla y muestra en él un panel completo de la herramienta de BI. La autenticación se resuelve con un inicio de sesión único o, en el caso de usuarios externos, con un enlace o token firmado que genera el servidor de la aplicación, y los filtros de contexto viajan dentro de esa firma. Looker lo llama signed embedding y lo describe como la forma de presentar contenido privado sin que el usuario necesite un inicio de sesión propio en la herramienta; Apache Superset lo resuelve con un guest token que su servidor emite a petición del backend de la aplicación; Metabase, desde su versión 58, lo ofrece como guest embeds en todas sus ediciones. Se pone en marcha en semanas y hereda todo lo que la herramienta ya sabe hacer, pero el panel conserva su estética, desconoce qué hace el usuario en el resto de la pantalla y se presenta como un destino al que hay que ir. Encaja con consultas periódicas y como primera versión para comprobar si existe demanda.
Nivel 2: componentes nativos mediante SDK
La aplicación deja de mostrar paneles enteros y coloca piezas: un indicador en la cabecera de la ficha del cliente, un gráfico junto a la lista de pedidos, una tabla de excepciones en la pantalla de planificación. Los kits de desarrollo de los fabricantes permiten que la aplicación fije los filtros según el contexto, escuche los eventos del componente —un clic en una barra que abre la lista filtrada en la propia aplicación—, aplique el sistema de diseño del producto y renueve los tokens sin interrumpir la sesión. El SDK de embebido de Looker, la Embedding API v3 de Tableau con sus componentes web, el cliente JavaScript de Power BI, la librería qlik-embed, el Visual Embed SDK de ThoughtSpot y el SDK de React de Metabase pertenecen a esta familia. Muchos siguen dibujando el contenido dentro de un iframe —la documentación de Looker explica que su SDK lo crea al conectar—, pero es la aplicación la que lo gobierna. El precio es trabajo de desarrollo en el frontal y una dependencia de versión con el SDK del fabricante, que hay que actualizar y probar.
Nivel 3: headless, servido por API
El headless BI separa la lógica analítica de su presentación: una capa semántica define métricas, dimensiones y reglas de acceso y las sirve por API —REST, GraphQL o SQL— a cualquier interfaz, y el equipo de producto dibuja los gráficos con sus propios componentes. Cube, cuyo núcleo se publica con licencia Apache 2.0, y GoodData, que se presenta como plataforma de analítica gestionada como código, son ejemplos de este enfoque, y las APIs de consulta de las grandes plataformas permiten aproximarse a él. El control es total: la analítica tiene exactamente la apariencia y el comportamiento del producto, el rendimiento se ajusta consulta a consulta y la misma API sirve también a los agentes de IA. La contrapartida es que todo lo que una herramienta resuelve sin pedirlo —selectores de filtro, exportación a PDF, envíos programados, gestión de permisos, accesibilidad de los gráficos— pasa a ser código propio que alguien mantendrá durante toda la vida del producto.
| Aspecto | Nivel 1 · iframe y SSO | Nivel 2 · componentes (SDK) | Nivel 3 · headless (API) |
|---|---|---|---|
| Qué ve el usuario | Un panel de la herramienta dentro de la aplicación | Piezas integradas en las pantallas de la aplicación | Gráficos propios, indistinguibles del resto del producto |
| Quién controla la interfaz | La herramienta de BI | La aplicación, con los límites del SDK | La aplicación por completo |
| Primera versión (orden de magnitud) | Semanas | Uno a tres meses | Varios meses |
| Coste recurrente | Licencia y administración del contenido | Licencia, frontal y actualizaciones del SDK | Equipo de producto y de plataforma permanente |
| Riesgo típico | Una pestaña que nadie abre | Acoplamiento a versiones del SDK | Reconstruir funciones que ya existían |
Criterio de decisión. Se empieza por el nivel más bajo que resuelve la tarea del usuario en su propia pantalla y se sube con evidencia de uso. El nivel 1 basta cuando la analítica es un destino periódico; el nivel 2 se justifica cuando el dato tiene que aparecer dentro del flujo y reaccionar a su contexto; el nivel 3 solo compensa cuando la experiencia analítica diferencia al producto frente a sus competidores y existe un equipo que la mantendrá. Lo habitual es combinar niveles en el mismo producto. Y hay algo que no cambia con el nivel: el aislamiento entre clientes se exige igual en los tres.
Trasvela: de la pestaña «Informes» a la analítica dentro del seguimiento de envíos
Trasvela es un operador logístico ficticio pero representativo, compuesto a partir de patrones habituales del transporte de carga fraccionada y la paquetería empresarial en Europa. Las magnitudes que siguen son órdenes de magnitud ilustrativos y no corresponden a ninguna empresa concreta. La compañía combina almacenes propios con una red de transportistas subcontratados y atiende a algo más de un millar de clientes cargadores, desde la pyme que envía unas decenas de bultos a la semana hasta el fabricante que despacha camiones completos a diario.
Un portal que funcionaba y una pestaña que nadie abría
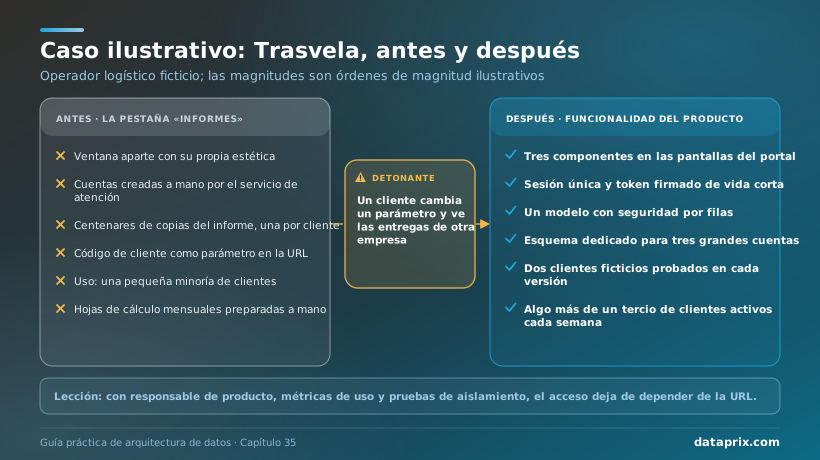
El portal de clientes de Trasvela permitía grabar envíos, descargar etiquetas y consultar el estado de cada expedición. Años atrás se le había añadido una pestaña «Informes» que abría, en una ventana nueva, los cuadros de mando de la herramienta de BI del departamento de operaciones. Cada cliente necesitaba una cuenta en esa herramienta, que el servicio de atención creaba a mano, y para que cada uno viera solo lo suyo se había optado por la solución más rápida: una copia del informe por cliente, filtrada por su código. Con el tiempo, las copias se contaban por centenares, cada cambio de diseño había que repetirlo en todas y las de los clientes grandes habían ido divergiendo con peticiones particulares.
Los registros de la herramienta contaban una historia incómoda: en un mes cualquiera, solo una pequeña minoría de los clientes abría la pestaña, y la mayoría de las sesiones duraba menos de un minuto. Mientras tanto, el servicio de atención seguía recibiendo a diario las mismas llamadas —dónde está mi envío, cuántas entregas fallaron la semana pasada, por qué este destinatario siempre está ausente— y preparaba cada mes, a mano, hojas de cálculo con el cumplimiento de plazos para los clientes que las pedían.
El aviso que cambió la conversación
Lo que precipitó el cambio fue un correo del equipo técnico de un cliente. Al revisar la integración con su propio sistema, habían observado que la dirección del panel incluía el código de cliente como parámetro y que, al cambiarlo, aparecían las entregas de otra empresa. El parámetro solo filtraba la presentación; el control de acceso que debía impedirlo faltaba en algunas de las copias del informe. Trasvela cerró el acceso esa misma tarde y lo trató como un incidente de seguridad: revisó los registros para determinar qué consultas se habían hecho con códigos ajenos, valoró con su delegado de protección de datos si había brecha —los informes incluían nombres y direcciones de destinatarios, datos personales que la compañía trata por cuenta de sus clientes— e informó a los cargadores afectados, responsables de esos datos.
Cinco decisiones para convertir la analítica en funcionalidad
El comité de dirección encargó el rediseño al responsable de producto del portal, con el equipo de datos como proveedor, y le fijó objetivos de producto: proporción de clientes que usan la analítica cada semana, reducción de las consultas de seguimiento al servicio de atención y uso del informe de cumplimiento en las renovaciones de contrato. Con ese encargo se tomaron cinco decisiones.
La primera fue subir al nivel 2 de la escala. En lugar de una pestaña, el portal incorporó tres componentes en las pantallas que los clientes ya usaban: un resumen de cumplimiento de plazos en la página de inicio, un gráfico de incidencias por causa junto a la lista de envíos —al pulsar una causa, la lista se filtra— y, en la ficha de cada destinatario recurrente, su historial de entregas fallidas. El detalle de cada envío siguió sirviéndose desde la API operativa del propio portal, y la herramienta de BI quedó reservada para los agregados, que es lo que mejor sabe hacer.
La segunda fue eliminar el segundo inicio de sesión. El servidor del portal genera, para cada sesión, un token firmado de vida corta con el identificador del cliente y el rol del usuario, y la capa de analítica deriva de esas afirmaciones todos sus filtros. Las cuentas en la herramienta desaparecieron y, con ellas, el trabajo manual del servicio de atención.
La tercera fue sustituir los centenares de copias por un único modelo con seguridad por filas, definida una sola vez y alimentada por el token. Tres grandes cuentas exigían por contrato que sus datos no compartieran tablas con los de nadie, y para ellas se mantuvo un esquema dedicado en el almacén —el modelo puente que se describe más adelante—; el resto convive en tablas compartidas con el identificador de cliente en cada fila. Los transportistas subcontratados, que tienen su propio portal, reciben los mismos componentes con otra frontera: ven únicamente las expediciones que transportan.
La cuarta fue la herramienta. Se evaluaron tres caminos: la capacidad de Power BI Embedded, coherente con el BI interno de la compañía; Tableau, con su licencia por uso, que mide el consumo de los visores en impresiones analíticas, y su Embedding API v3; y Apache Superset con su SDK de embebido, operado por el propio equipo de plataforma. El uso previsto era muy desigual —unos pocos clientes a diario, la mayoría unas veces al mes— y el equipo prefirió un coste que creciera con el consumo real antes que dimensionar una capacidad para los lunes por la mañana que pasaría ociosa el resto de la semana. Eligió Tableau, con aplicaciones conectadas que firman el token y atributos de usuario que el contenido usa para filtrar, y fijó un tope mensual de consumo con alertas para que la factura no sorprendiera a nadie. Superset quedó como alternativa documentada si el volumen llegaba a hacer rentable operar la plataforma.
La quinta, la que más tardó en asentarse, fue medir como se mide un producto. Cada componente emite eventos —se ha mostrado, se ha aplicado un filtro, se ha pulsado una causa, se ha descargado el informe de cumplimiento— con el identificador de cliente y un identificador seudónimo de usuario, y el responsable de producto revisa cada mes la activación de los clientes nuevos, los clientes activos por semana y las consultas de seguimiento de los clientes que usan la analítica frente a los que no.
Lo que cambió
En los seis meses siguientes, la proporción de clientes con al menos una sesión semanal pasó de una minoría pequeña a algo más de un tercio, y las llamadas de seguimiento de esos clientes bajaron de forma visible; las cifras son ilustrativas del orden de magnitud que cabe esperar en un escenario así. El informe mensual de cumplimiento dejó de prepararse a mano y empezó a aparecer en las reuniones de renovación, ahora con una definición de «entrega a tiempo» común a todos los clientes. Y el equipo incorporó al ciclo de cada versión una batería de pruebas con dos clientes ficticios que no deben verse entre sí.
Lección: la analítica embebida se gestiona como una funcionalidad del producto, con un responsable, métricas de uso y pruebas de aislamiento en cada versión. Mientras se gestionó como un informe más, el control de acceso acabó dependiendo de un parámetro en la URL.
Multicliente: dónde se dibuja la frontera entre clientes
La seguridad por filas multicliente es el mecanismo que garantiza que cada consulta de la analítica embebida devuelve únicamente filas de la organización a la que pertenece el usuario —y, dentro de ella, solo las que su rol permite ver—, con independencia del panel, del filtro o de la vía por la que llegue la petición. Es una propiedad del sistema completo, desde el token hasta el almacén, y se diseña por capas.
Silo, puente y piscina
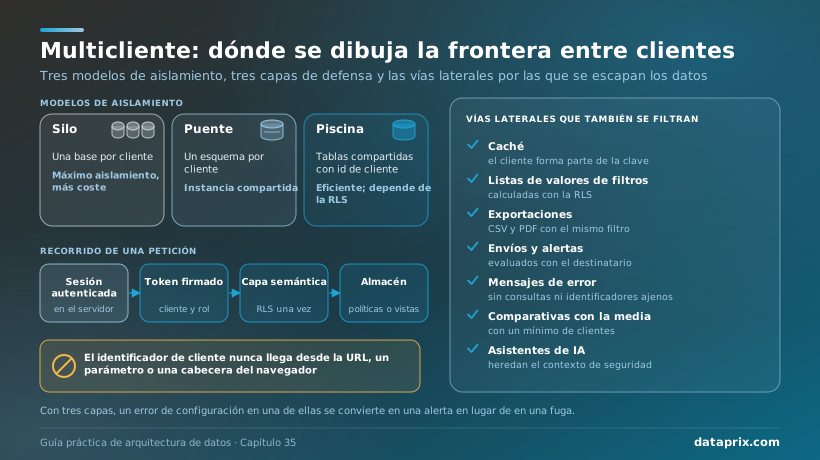
La arquitectura SaaS distingue tres modelos de aislamiento, popularizados por los documentos de referencia de AWS sobre estrategias de aislamiento de inquilinos. En el modelo silo, cada cliente tiene su propia base de datos o instancia: el aislamiento es el más fuerte y el más fácil de explicar a un auditor, pero el coste y la operación crecen con cada alta, y las comparativas entre clientes exigen juntar datos que se habían separado. En el modelo puente, los clientes comparten instancia y cada uno tiene su esquema. En el modelo piscina, todos comparten tablas y cada fila lleva el identificador de su cliente: es el más eficiente para la analítica, porque los agregados y las comparativas salen de una sola consulta, y el que más depende de que la seguridad por filas no falle nunca. Lo habitual es combinarlos, con silos o puentes para los clientes grandes o regulados y piscina para el resto, como hizo Trasvela.
Las herramientas de BI reproducen esa elección en su propio terreno. Microsoft documenta para Power BI dos enfoques —aislamiento por áreas de trabajo, con un perfil de entidad de servicio por cliente, o aislamiento por seguridad de nivel de fila en un modelo compartido— y sitúa el primero en soluciones con decenas de miles de inquilinos. Google recomienda configurar Looker como un sistema cerrado cuando los clientes de un embebido firmado no deben saber unos de otros. Superset admite reglas de seguridad por filas dentro del propio token de invitado, y Cube resuelve la multitenencia a partir de un contexto de seguridad verificado que reescribe cada consulta. El capítulo 30 defendía que la seguridad por filas viviera en la capa semántica y no se duplicara en cada herramienta; en analítica embebida esa recomendación pasa a ser una condición de supervivencia.
La regla del inquilino de servidor
El fallo más frecuente en analítica multicliente tiene una causa muy concreta: el identificador del cliente llega desde el navegador. Puede estar en la URL, en un parámetro del panel, en una cabecera que fija el código del frontal o en un campo oculto de un formulario, y en todos los casos basta con cambiarlo para pedir datos ajenos. Es la forma analítica del control de acceso roto, la categoría que encabeza el OWASP Top 10:2025, igual que encabezaba la edición de 2021. La defensa es la regla del inquilino de servidor: el cliente y el rol de cada usuario se determinan en el servidor de la aplicación a partir de la sesión autenticada, viajan en un token firmado de vida corta —habitualmente un JWT— que la capa de analítica verifica, y de esas afirmaciones verificadas, y de ningún otro sitio, se derivan todos los filtros de seguridad. Los parámetros que sí llegan del navegador sirven para la experiencia —el periodo, la causa seleccionada—, y la capa de analítica los combina siempre con el filtro del token, que el usuario no puede retirar.
Los fabricantes han convergido en este patrón con nombres distintos: el token de inserción con identidad efectiva de Power BI, las aplicaciones conectadas de Tableau con atributos de usuario dentro del JWT, la URL de embebido firmada de Looker, el token de invitado de Superset o el contexto de seguridad de Cube. Cambia el detalle y se mantiene la disciplina, que conviene escribir en la especificación del producto para que ninguna integración futura la eluda.
Defensa en tres capas
Un solo control, por bien hecho que esté, es un punto único de fallo. La práctica más sólida superpone tres: el token, que fija quién es el usuario y a qué cliente pertenece; la capa semántica, donde la regla de seguridad por filas se define una vez para todos los componentes; y el almacén, con políticas de seguridad por filas nativas de la base de datos o vistas por cliente, para que una consulta que escape de las dos capas anteriores siga sin devolver datos ajenos. Con las tres capas en su sitio, un error de configuración en una de ellas deja de ser una fuga y se convierte en una alerta.
Las fugas que no pasan por el panel
Las revisiones de aislamiento suelen concentrarse en el gráfico que el usuario ve, y las fugas aparecen en los alrededores. La caché es la primera: si la clave con la que se guarda un resultado no incluye el cliente o el contexto de seguridad, el segundo cliente que pide el mismo panel recibe los datos del primero, un riesgo que el capítulo 13 ya señalaba para las cachés compartidas y que en analítica embebida se multiplica. Las listas de valores de los filtros son la segunda y la más traicionera: un desplegable que muestra los nombres de todos los destinatarios, o de todos los clientes, porque se calculó sin aplicar la seguridad por filas. Siguen las exportaciones a CSV o PDF, los envíos programados y las alertas —que deben evaluarse con la identidad de su destinatario—, los mensajes de error que reproducen una consulta con identificadores ajenos y las comparativas con la media, que pueden revelar a un competidor si la media se calcula sobre muy pocos clientes. La última en llegar es la analítica conversacional: varios fabricantes permiten ya incrustar asistentes de IA en sus componentes, y un asistente que responde preguntas en lenguaje natural debe heredar el mismo contexto de seguridad que un gráfico. Esa protección se aplica en la capa que ejecuta la consulta, porque las instrucciones de un modelo de lenguaje se pueden eludir.
Riesgo legal: una fuga entre clientes es una brecha de datos personales. Si los datos que un cliente ve por error incluyen datos personales —destinatarios, empleados, pacientes, usuarios finales—, el incidente es una brecha de confidencialidad en el sentido del RGPD. Quien presta la analítica actúa casi siempre como encargado del tratamiento de sus clientes y debe informarles sin dilación indebida; el responsable valora el riesgo y, si existe, lo notifica a la autoridad de control —en España, la AEPD— en un plazo máximo de 72 horas desde que tiene constancia, y lo comunica a los afectados si el riesgo es alto. El contrato de encargo debe concretar plazos, contenido y canal de ese aviso, y el registro de accesos de la analítica embebida tiene que permitir reconstruir qué vio quién. Conviene revisar ese procedimiento con el delegado de protección de datos antes de abrir el primer componente.
Demostrar el aislamiento antes de que lo compruebe un cliente
Un control de acceso que no se prueba de forma automática se degrada con cada versión: un componente nuevo, un filtro añadido con prisas, una caché activada para resolver un problema de rendimiento. Por eso el aislamiento se trata como se trata un pago, con pruebas que se ejecutan en cada cambio y que fallan de forma ruidosa.
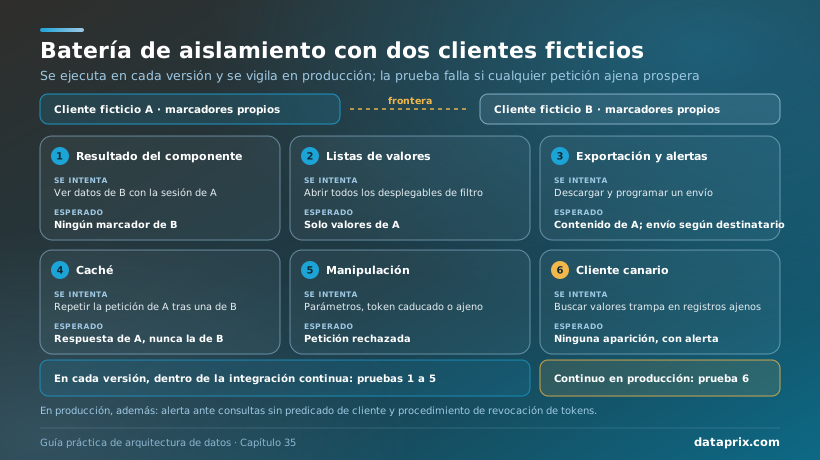
La base es un par de clientes ficticios, A y B, con datos sintéticos que incluyen valores marcadores imposibles de confundir: un destinatario con un nombre inequívoco, un importe con una secuencia de dígitos reconocible. El capítulo 31 proponía esta prueba durante la evaluación de herramientas; aquí se convierte en parte de la integración continua, con la lógica de pruebas que el capítulo 26 aplicaba a los pipelines. Para cada componente embebido, la batería inicia sesión como A y comprueba que ningún marcador de B aparece en el resultado, en las listas de valores de los filtros, en la exportación, en la respuesta servida desde caché ni en la alerta programada. Después intenta lo que intentaría alguien con curiosidad: manipular los parámetros de la petición, reutilizar un token caducado, presentar un token de A con un parámetro de B y pedir directamente a la API de la herramienta un recurso que no figura entre los concedidos. Todas esas peticiones deben fallar, y la prueba falla si alguna no lo hace.
En producción, la vigilancia continúa con tres mecanismos. Un cliente canario con valores trampa cuya aparición en cualquier registro ajeno dispara una alerta inmediata. Una revisión de los registros de consultas del almacén que señala cualquier consulta de la cuenta de servicio de la analítica embebida sin el predicado de cliente. Y un procedimiento de respuesta preparado de antemano: revocar todos los tokens emitidos, desactivar un componente o un cliente concreto sin detener el resto del portal y conservar los registros que permitirán contestar a las preguntas que formulará el responsable del tratamiento. Una prueba de intrusión periódica, centrada en el acceso a objetos de otros clientes, completa el ciclo.
| Prueba | Qué se intenta | Resultado esperado | Cuándo |
|---|---|---|---|
| Resultado del componente | Ver datos de B tras iniciar sesión como A | Ningún marcador de B | En cada versión |
| Listas de valores | Abrir todos los desplegables de filtro | Solo valores de A | En cada versión |
| Exportación y alertas | Descargar el contenido y programar un envío | Contenido de A; envío evaluado con la identidad del destinatario | En cada versión |
| Caché | Repetir la petición de A justo después de una de B | Respuesta de A, nunca la guardada para B | En cada versión |
| Manipulación | Cambiar parámetros, usar un token caducado o ajeno | Petición rechazada | En cada versión y en la prueba de intrusión |
| Cliente canario | Buscar valores trampa en registros de otros clientes | Ninguna aparición | Continuo, con alerta |
Licencias: alinear la factura con la unidad de ingresos
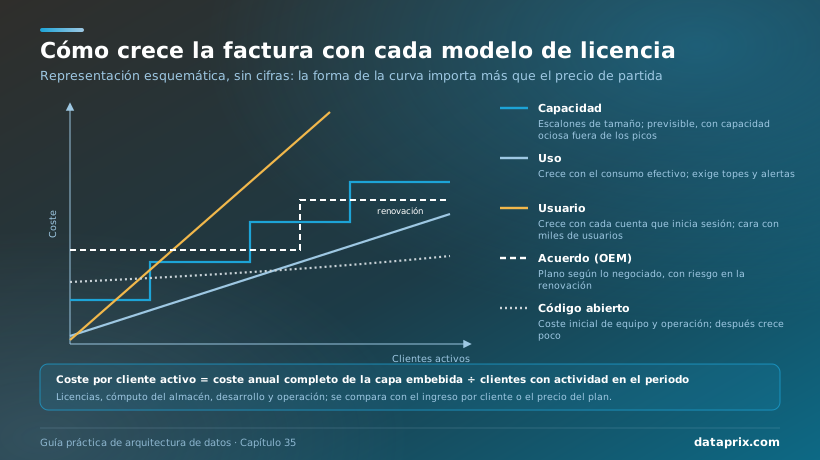
El capítulo 31 dejó formulada la regla económica de la analítica embebida: la unidad de precio de la herramienta debe parecerse a la unidad de ingresos del negocio que la sirve. Si se cobra por cliente, por envío o por plan, pagar por cada usuario externo provisionado convierte el éxito de la adopción en un problema de margen. A fecha de noviembre de 2026, el mercado ofrece cinco modelos, y casi todos los fabricantes combinan más de uno.
El modelo por capacidad reserva cómputo que comparten todos los visores. Power BI Embedded se contrata como capacidad —las SKU A de Azure o las F de Fabric— y, en el escenario que Microsoft llama inserción para clientes, los usuarios finales no necesitan licencia de Power BI. Tableau añadió en julio de 2026 un licenciamiento por capacidad con bloques de visores que se dimensionan por uso concurrente. Es previsible, y su riesgo es dimensionar para el pico del lunes y pagar capacidad ociosa el resto de la semana.
El modelo por uso cobra por consumo efectivo. La licencia por uso de Tableau mide a los visores en impresiones analíticas, mientras que creadores y exploradores siguen licenciándose por usuario. Encaja con un consumo muy desigual entre clientes, como en Trasvela, y obliga a vigilar la factura con topes y alertas, porque un componente mal diseñado que se recarga sin necesidad multiplica el consumo sin aportar valor.
El modelo por usuario sobrevive en algunas ofertas para embebido. En Metabase, cada persona que inicia sesión en un embebido con inicio de sesión único cuenta como usuario del plan, mientras que los embebidos de invitado, sin inicio de sesión, no cuentan. Es razonable con pocos usuarios externos de alto valor y caro con miles de usuarios ocasionales; si se adopta, las cuentas se crean en el primer acceso para no pagar por clientes que nunca entran.
El modelo bajo acuerdo, a veces llamado OEM, es el habitual en las ediciones específicas para embebido —la edición Embed de Looker, ThoughtSpot Embedded o las plataformas nacidas para embeber—, con precios negociados que pueden combinar una cuota de plataforma con unidades de uso, espacios de trabajo o clientes. Se negocia con la adopción prevista a tres años y cláusulas de revisión, antes de que el producto dependa de la herramienta.
Y el código abierto elimina la licencia y traslada el coste a la operación. Apache Superset, con licencia Apache 2.0, permite integrar su SDK en un producto propio sin obligación de publicar los cambios; la edición abierta de Metabase, con licencia AGPL, merece la revisión jurídica que el capítulo 31 recomendaba antes de modificarla e integrarla. En ambos casos el presupuesto incluye actualizaciones, alta disponibilidad, monitorización y guardias, las mismas cuentas que el capítulo 12 hacía para cualquier plataforma autogestionada.
Para comparar opciones sirve una métrica sencilla: el coste por cliente activo, resultado de dividir el coste anual completo de la capa embebida —licencias, cómputo del almacén que generan sus consultas, desarrollo y operación— entre los clientes que la han usado en el periodo, con un umbral de actividad fijado de antemano. Comparado con el ingreso medio por cliente o con el precio del plan que incluye la analítica, indica si la funcionalidad se paga a sí misma, y su evolución avisa antes que la factura cuando algo se desvía.
| Modelo | Cómo crece la factura | Encaja cuando | Riesgo |
|---|---|---|---|
| Capacidad | Por escalones de tamaño | Uso amplio y estable, con picos previsibles | Capacidad ociosa, o saturada en los picos |
| Uso | Con el consumo efectivo | Uso muy desigual entre clientes | Factura difícil de prever sin topes ni alertas |
| Usuario | Con cada cuenta que inicia sesión | Pocos usuarios externos de alto valor | Miles de usuarios ocasionales |
| Acuerdo (OEM) | Según lo negociado | La analítica forma parte del precio del producto | Pérdida de poder de negociación en la renovación |
| Código abierto | Con el equipo y la infraestructura | Hay un equipo de plataforma con experiencia | Coste de operación infravalorado |
Rendimiento cuando quien espera es el cliente de otro
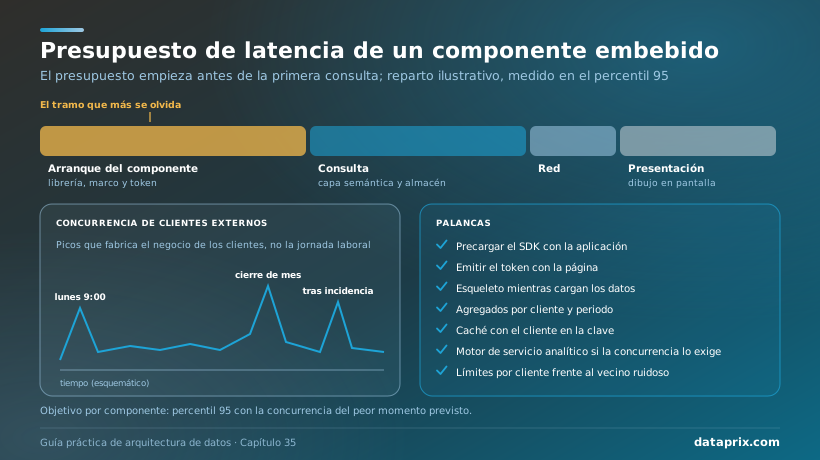
El capítulo 32 definió el presupuesto de latencia como el tiempo máximo aceptable entre una acción del usuario y la respuesta visual completa, repartido entre almacenamiento, consulta, red y presentación. En analítica embebida aparece un tramo previo que suele ser el más largo y el que nadie mide: el arranque del componente. Antes de lanzar la primera consulta, la página carga la librería del fabricante, crea el marco, pide al servidor de la aplicación un token firmado y lo intercambia con la herramienta. Si ese tramo consume la mitad del presupuesto, ninguna optimización del almacén lo compensará. Las palancas son conocidas: cargar el SDK junto con la estructura de la aplicación en lugar de al llegar a la pantalla, emitir el token en el mismo viaje que la página, mostrar un esqueleto del componente mientras llegan los datos y diferir la carga de lo que queda fuera de la vista.
La segunda diferencia es la forma de la concurrencia. Los usuarios internos se reparten a lo largo de la jornada; los clientes de un producto se concentran en momentos que fabrica el propio negocio: el lunes a primera hora, el cierre de mes, la mañana siguiente a una incidencia generalizada, cuando todos quieren saber cuántas de sus entregas se han visto afectadas. A eso se suma la asimetría entre clientes: uno o dos clientes grandes pueden concentrar buena parte del volumen, y un modelo que funciona para la pyme media se atasca con ellos.
Las respuestas combinan diseño de datos y protección mutua. Agregados por cliente y periodo, particionados o agrupados por el identificador de cliente, en la línea del diseño por patrón de acceso del capítulo 9. Cachés cuya clave incluye siempre el cliente, con caducidad atada a la carga de datos. Motores de servicio analítico —ClickHouse, Apache Druid, Apache Pinot— cuando, como anticipaba el capítulo 32, la concurrencia la marca el número de clientes. Y límites por cliente —tiempo máximo de consulta, filas por exportación, consultas simultáneas— para que quien lanza una exportación masiva no degrade la experiencia de los demás, el problema del vecino ruidoso que cualquier plataforma compartida termina encontrando. El objetivo se expresa como un nivel de servicio por componente, en el percentil 95 y con la concurrencia del peor momento previsto, a la manera de los SLO del capítulo 5.
Diseñar la experiencia: la analítica dentro de la pantalla donde se decide
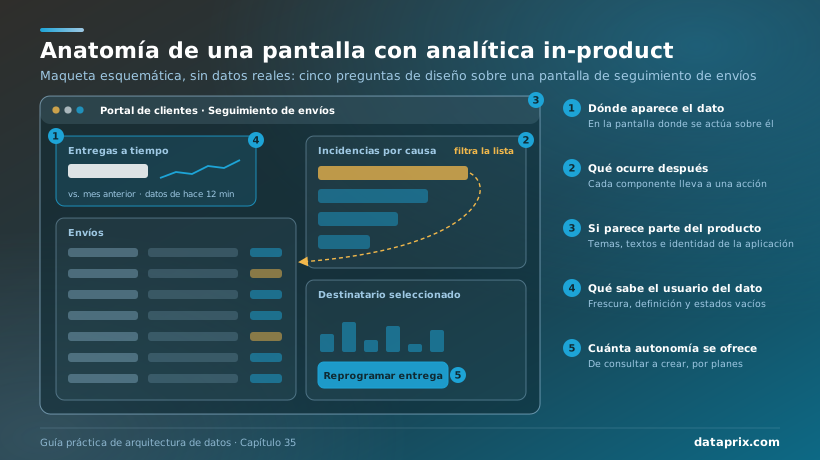
Las decisiones de diseño que separan un panel incrustado de una funcionalidad caben en cinco preguntas, y todas se responden mirando la tarea del usuario antes que el catálogo de visualizaciones.
La primera es dónde aparece el dato. Un indicador vale más en la pantalla donde se actúa sobre él que en una sección dedicada: el cumplimiento de plazos en la página de inicio del cliente, el riesgo de rotura de stock junto al botón de reponer, el historial de averías en la orden de trabajo. Una zona de exploración libre puede convivir con esas piezas para el usuario que quiere profundizar, pero no las sustituye.
La segunda es qué ocurre después. Cada componente debería conducir a una acción dentro del producto: abrir la lista filtrada, crear una incidencia, reprogramar una entrega, contactar con el transportista. Un gráfico sin salida obliga al usuario a recordar lo que ha visto y buscarlo en otra pantalla, y ese salto es exactamente el que la analítica embebida promete eliminar.
La tercera es si parece parte del producto. Tipografías, colores, espaciados y estados deben salir del sistema de diseño de la aplicación mediante los temas del SDK; los textos, del mismo tono y del mismo idioma; la identidad, de la misma sesión. Un componente que delata a otro fabricante transmite que el dato también es de otro, y el usuario le concede menos confianza.
La cuarta es qué sabe el usuario sobre el dato: la frescura visible —«datos actualizados hace doce minutos»—, la definición de cada métrica accesible desde el propio indicador y tomada de la capa semántica, y unos estados vacíos pensados para el cliente que acaba de darse de alta y aún no tiene historial. Un panel vacío el primer día es la causa más silenciosa de que un cliente no vuelva.
Y la quinta es cuánta autonomía se ofrece. La escala va de consultar a filtrar y profundizar, a guardar vistas propias y, en el extremo, a construir informes nuevos sobre los datos del cliente. Cada paso añade valor y también soporte, riesgo de rendimiento y superficie de seguridad, y lo habitual es reservar los últimos para un plan superior, con cuotas y límites como los que el capítulo 33 describía para el autoservicio interno. La accesibilidad y el uso desde el móvil, que el capítulo 32 trataba como requisitos de diseño, pesan todavía más cuando el usuario es un cliente.
Medir la adopción con métricas de producto
La analítica embebida se gestiona con métricas de producto, y la tentación de medirla con las del BI interno —número de paneles publicados, aperturas totales— conduce a conclusiones equivocadas. Un panel abierto mil veces por error de navegación no ha resuelto nada; un indicador que el cliente mira diez segundos cada mañana antes de decidir qué envíos reclamar puede ser lo más valioso del portal.
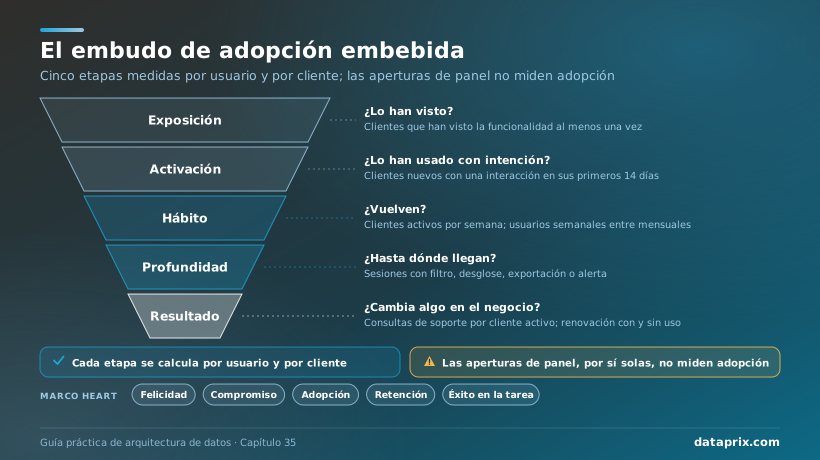
Una forma práctica de ordenar la medición es el embudo de adopción embebida, con cinco etapas. La exposición cuenta qué clientes y usuarios tienen la funcionalidad disponible y la han visto al menos una vez. La activación mide cuántos realizan una primera interacción con intención —aplicar un filtro, pulsar una barra, descargar un informe— en sus primeros días. El hábito registra la frecuencia: clientes activos por semana y relación entre usuarios activos semanales y mensuales. La profundidad describe qué parte de las sesiones usa filtros, desgloses, exportaciones o alertas. Y el resultado conecta el uso con el negocio: consultas de soporte evitadas, renovación y permanencia de los clientes que usan la analítica frente a los que no, contratación del plan que la incluye. En software para empresas, cada etapa se calcula a dos niveles, por usuario y por cliente, porque un cliente con un único usuario activo depende de que esa persona no cambie de puesto.
El marco HEART, que Kerry Rodden, Hilary Hutchinson y Xin Fu presentaron en la conferencia CHI de 2010 a partir del trabajo de los equipos de experiencia de usuario de Google, ofrece un complemento útil: organiza las métricas en felicidad, compromiso, adopción, retención y éxito en la tarea, y propone derivarlas de objetivos y señales en lugar de partir de lo que resulta fácil contar. Para la analítica embebida, la métrica de éxito en la tarea suele ser la más reveladora: cuánto tarda un cliente en saber qué envíos se han retrasado y por qué, con el componente y sin él.
La instrumentación combina dos fuentes. La aplicación emite eventos propios, con el identificador de cliente y un identificador seudónimo de usuario, hacia su herramienta de analítica de producto —PostHog, Amplitude, Mixpanel o un registro de eventos en el propio almacén—, y la herramienta de BI aporta sus registros de actividad, útiles para el rendimiento pero ciegos a lo que ocurre fuera del componente. Esa telemetría es, a su vez, tratamiento de datos personales de los usuarios de los clientes: debe figurar en la información de privacidad del producto, limitarse a lo necesario y agregarse por cliente siempre que el análisis lo permita. Con los datos ordenados, la colocación de un componente o el texto de un indicador se pueden decidir con experimentos controlados, y lo que no supera la etapa de activación tras varios meses se retira, con la misma disciplina que el capítulo 29 aplicaba a los informes zombis.
| Etapa | Pregunta | Métrica de ejemplo | Fuente |
|---|---|---|---|
| Exposición | ¿Lo han visto? | Clientes que han visto la funcionalidad al menos una vez | Eventos de la aplicación |
| Activación | ¿Lo han usado con intención? | Proporción de clientes nuevos con una interacción en sus primeros 14 días | Eventos de la aplicación |
| Hábito | ¿Vuelven? | Clientes activos por semana; usuarios activos semanales entre mensuales | Eventos de la aplicación |
| Profundidad | ¿Hasta dónde llegan? | Sesiones con filtro, desglose, exportación o alerta | Eventos y registros de la herramienta |
| Resultado | ¿Cambia algo en el negocio? | Consultas de soporte por cliente activo; renovación con uso y sin uso | CRM, soporte y facturación |
Tres escenarios: recursos humanos, comercio electrónico y marketing
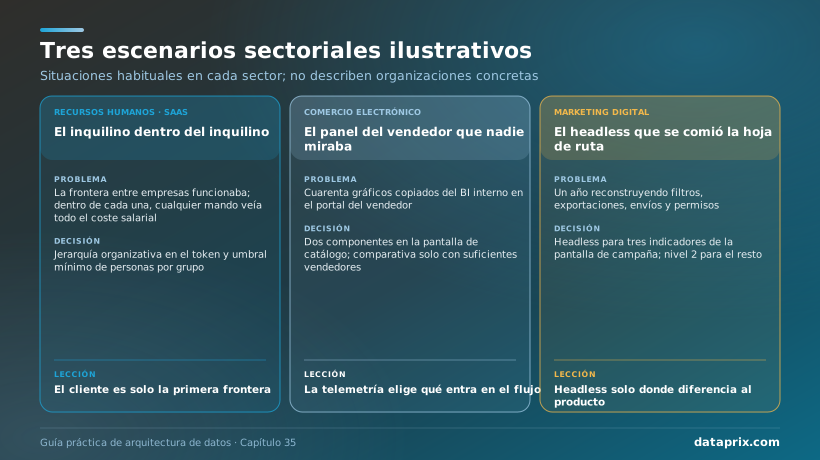
Los tres escenarios siguientes son ilustrativos: combinan situaciones habituales en cada sector y no describen organizaciones concretas.
Software de recursos humanos para pymes: el inquilino dentro del inquilino
Un fabricante de software de nómina y gestión de personal para pymes quería ofrecer a sus clientes indicadores de absentismo, rotación y coste de plantilla. La primera versión aplicó con corrección la frontera entre empresas cliente y olvidó la segunda: dentro de cada empresa, un mando intermedio no debe ver el coste salarial de otros departamentos, y el área de personas sí. La revisión llevó la jerarquía organizativa de la propia aplicación al modelo semántico, de modo que el token incluye el cliente, el rol y el ámbito organizativo, y añadió un umbral mínimo de personas por grupo para que ningún promedio de un equipo pequeño permitiera deducir el sueldo de alguien concreto. Lección: en software para empresas, el cliente es solo la primera frontera; los datos de personas exigen además permisos por jerarquía y umbrales que impidan reidentificar a nadie desde un agregado.
Mercado en línea: el panel del vendedor que nadie miraba
Una plataforma de comercio electrónico con varios miles de vendedores independientes había trasladado al portal del vendedor buena parte de su BI interno: cuarenta gráficos sobre ventas, tráfico, devoluciones y valoraciones. La telemetría mostró que la mayoría de los vendedores solo usaba dos cosas —los productos que iban a quedarse sin stock en una semana y el rendimiento de cada producto frente a su categoría— y que las buscaba mientras gestionaba el catálogo. El equipo llevó esas dos piezas, como componentes, a la pantalla de gestión de productos y retiró la mayor parte del resto. La comparativa con la categoría exigió una decisión adicional: solo se muestra cuando la media se calcula sobre suficientes vendedores para que ninguno pueda deducir las ventas de un competidor, una cautela que aconsejan el derecho de la competencia y los propios contratos con los vendedores. Lección: replicar el BI interno para los clientes multiplica el contenido sin multiplicar el uso; la telemetría dice qué dos o tres piezas merecen estar dentro del flujo.
Plataforma de marketing digital: el headless que se comió la hoja de ruta
Una empresa de software para la gestión de campañas publicitarias decidió construir su analítica para clientes en el nivel 3: una capa semántica servida por API y componentes gráficos propios. El resultado era visualmente impecable, y al cabo de un año el equipo había reconstruido filtros con comparación de fechas, exportación a PDF, envíos programados por correo, permisos por agencia y anunciante y una versión accesible de cada gráfico; la cola de peticiones del módulo de analítica superaba ya a la del producto principal. La revisión mantuvo el desarrollo propio para los tres indicadores de la pantalla de campaña, donde la experiencia sí diferenciaba al producto, y trasladó informes, exportaciones y envíos a una herramienta con SDK en el nivel 2. Lección: el nivel headless se reserva para la parte de la analítica que diferencia al producto; lo que es común a cualquier informe sale más barato de una herramienta.
Anti-patrones: del segundo inicio de sesión a la caché que no distingue clientes
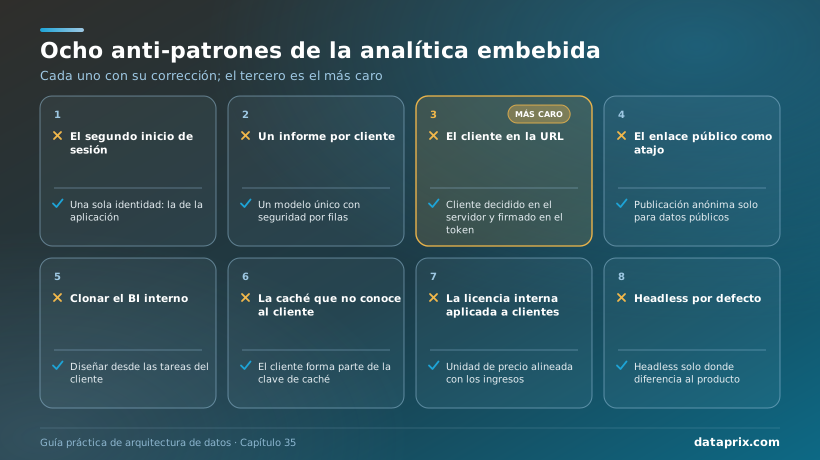
Los errores de la analítica embebida se repiten con tanta regularidad que se pueden catalogar. Ocho aparecen en casi todas las revisiones.
El segundo inicio de sesión. Otra cuenta y otra ventana para ver los propios datos garantizan que solo lleguen los más interesados y generan soporte con cada contraseña olvidada. Para el usuario solo debe existir la identidad de la aplicación.
Un informe por cliente. Las copias filtradas parecen la forma más rápida de aislar a cada cliente y acaban en centenares de objetos que divergen, que nadie mantiene y en los que basta una copia sin restricción para abrir una fuga. Un modelo único con seguridad por filas las sustituye a todas.
El anti-patrón más caro: el cliente en la URL. Cuando el identificador del cliente viaja como parámetro del panel, de la dirección o de una cabecera que fija el navegador, la frontera entre clientes depende de que nadie lo cambie. Basta con que un usuario curioso, o el equipo técnico de un cliente que revisa una integración, modifique un número para ver datos ajenos, y la organización pasa de tener un problema de diseño a gestionar una posible brecha de datos personales y la confianza de todos sus clientes. Ningún ahorro de tiempo en la primera versión compensa ese riesgo: el cliente se determina en el servidor y viaja firmado.
El enlace público como atajo. Varias herramientas permiten publicar un panel en Internet sin autenticación, y Microsoft advierte de que, con «Publicar en la web», cualquier persona puede ver el informe y sus datos. Escondido tras un portal con contraseña, el enlace sigue funcionando en cualquier navegador que lo conozca. La publicación anónima se reserva para datos públicos.
Clonar el BI interno. Los cuadros de operaciones responden a preguntas internas, con su vocabulario y su densidad; trasladados tal cual, producen paneles que el cliente no entiende. La analítica para clientes se diseña desde sus tareas.
La caché que no conoce al cliente. Una caché compartida sin el cliente en su clave convierte una optimización en una fuga intermitente, la más difícil de detectar porque solo aparece cuando dos clientes piden lo mismo en el mismo intervalo.
La licencia interna aplicada a clientes. Extender a miles de usuarios externos la licencia por usuario del equipo interno convierte cada alta de cliente en un coste y empuja a compartir cuentas, lo que destruye la trazabilidad.
Headless por defecto. Elegir el nivel 3 sin una experiencia diferencial que lo justifique ni un equipo que lo sostenga compromete durante años a reconstruir funciones que una herramienta ya ofrecía.
Medir aperturas. Contar cuántas veces se abre un panel premia la curiosidad del primer mes y oculta el abandono posterior; sin el embudo de adopción, nadie sabe si la funcionalidad merece inversión o retirada.
Selección de software: cinco familias para embeber analítica
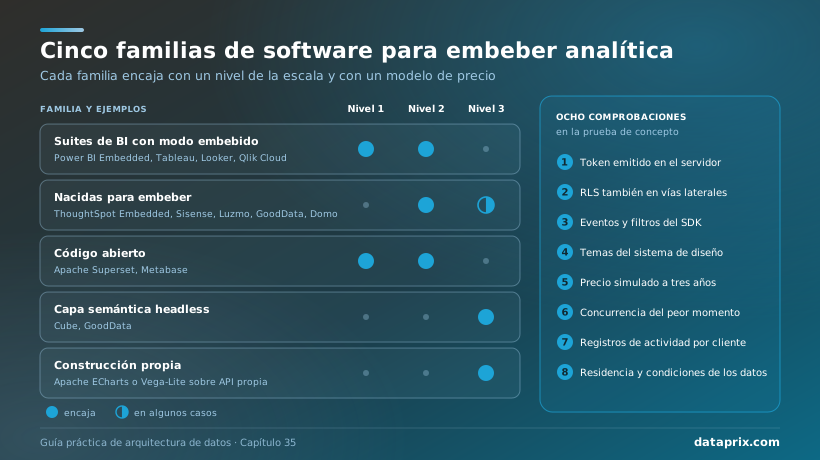
La oferta se ordena mejor por familias que por marcas, porque cada familia encaja con un nivel de la escala y con un modelo de precio.
Las suites de BI con modo embebido son la opción natural cuando la organización ya usa una de ellas internamente y quiere reutilizar modelos, conocimiento y contratos; cubren los niveles 1 y 2 con solvencia, y sus diferencias pesan sobre todo en el modelo de licencia y en la nube donde vive el resto de la plataforma. Las cuatro encabezan, en ese orden —Microsoft Power BI, Tableau, Qlik Sense y Looker—, el ranking TOP 10 de software de Business Intelligence y analítica de 2026 del directorio de Dataprix, que recoge el veredicto editorial de cada opción.
Las plataformas nacidas para embeber —ThoughtSpot Embedded, de ThoughtSpot; Sisense con su Compose SDK; Luzmo; GoodData, o la oferta de embebido de Domo— priorizan el SDK, la marca blanca y la gestión de miles de inquilinos, con precios casi siempre bajo acuerdo. Tienen sentido cuando la analítica es parte del producto que se vende y no existe una suite interna que reutilizar.
El código abierto —Apache Superset y Metabase, este con el inicio de sesión único y el SDK de React reservados a sus planes de pago— elimina la licencia y exige un equipo capaz de operar la plataforma con la disponibilidad que esperan los clientes. Las capas semánticas headless, con Cube como referencia de código abierto, son la base del nivel 3, y la construcción propia sobre librerías de gráficos como Apache ECharts o Vega-Lite solo compensa en las piezas donde la experiencia es el producto.
| Familia | Ejemplos | Nivel de la escala | Aislamiento multicliente | Precio habitual |
|---|---|---|---|---|
| Suites de BI con modo embebido | Power BI Embedded, Tableau, Looker, Qlik Cloud | 1 y 2 | Token firmado con seguridad por filas o espacios por cliente | Capacidad, uso o edición específica |
| Nacidas para embeber | ThoughtSpot Embedded, Sisense, Luzmo, GoodData, Domo | 2, y 3 en algunas | Inquilinos gestionados por la plataforma | Bajo acuerdo |
| Código abierto | Apache Superset, Metabase | 1 y 2 | Token de invitado con reglas, o inicio de sesión único | Operación propia; planes de pago para funciones avanzadas |
| Capa semántica headless | Cube, GoodData | 3 | Contexto de seguridad verificado en cada consulta | Núcleo abierto o plataforma gestionada |
| Construcción propia | Apache ECharts o Vega-Lite sobre API propia | 3 | El que se programe | Equipo permanente |
Más allá de la familia, la prueba de concepto debería comprobar ocho cosas: que el token se emite en el servidor y las reglas de seguridad no pueden alterarse desde el navegador; que la seguridad por filas se define una vez y alcanza también a listas de valores, exportaciones, alertas, caché y asistentes de IA; que el SDK expone los eventos y filtros que exige el nivel 2; que los temas permiten aplicar el sistema de diseño completo; que el modelo de precio se ha simulado con la adopción prevista a tres años; que el rendimiento se ha medido con la concurrencia del peor momento; que la herramienta ofrece registros de actividad por cliente; y dónde se alojan los datos y en qué condiciones de tratamiento, un requisito que en Europa decide más contratos que cualquier gráfico. En opinión de la redacción de Dataprix, para el portal de clientes de una empresa que no vende software, la suite de BI que ya se usa internamente, en el nivel 2, suele ser el camino de menor riesgo, siempre que su modelo de licencia supere la simulación de costes; las plataformas nacidas para embeber y el headless se justifican cuando la analítica forma parte del precio del producto.
Checklist operativo: antes de abrir la analítica a los clientes
- Nombrar un responsable de producto para la analítica embebida, con objetivos de uso y de negocio escritos.
- Identificar el territorio —SaaS, portal de socios, aplicación interna o público— y el nivel de la escala de partida, con el criterio para subir.
- Elegir el modelo de aislamiento —silo, puente, piscina o una combinación— por tipo de cliente y reflejarlo en los contratos.
- Emitir el cliente y el rol en el servidor, en tokens firmados de vida corta, y prohibir por especificación cualquier filtro de seguridad que llegue del navegador.
- Definir la seguridad por filas una sola vez en la capa semántica y reforzarla en el almacén con políticas nativas o vistas por cliente.
- Revisar las vías laterales: caché, listas de valores, exportaciones, envíos programados, alertas, mensajes de error, comparativas y asistentes de IA.
- Automatizar la batería de aislamiento con dos clientes ficticios en cada versión y mantener un cliente canario en producción.
- Preparar el procedimiento de incidente: revocación de tokens, desactivación por componente o por cliente, registros conservados y aviso a los responsables del tratamiento.
- Simular el coste por cliente activo a tres años con dos escenarios de adopción y, si el modelo es por uso, fijar topes y alertas.
- Fijar el presupuesto de latencia por componente, arranque incluido, en el percentil 95 y con la concurrencia del peor momento previsto.
- Aplicar el sistema de diseño del producto, mostrar la frescura de los datos y diseñar los estados vacíos de los clientes nuevos.
- Instrumentar el embudo de adopción por usuario y por cliente, informar de esa telemetría en la política de privacidad y revisarlo cada mes.
Formación recomendada
Para los equipos de producto y de datos que van a medir la adopción de la analítica embebida o a prototipar componentes propios antes de comprometerse con el nivel 3, estas opciones están directamente relacionadas con el capítulo:
- A/B Testing en Python (DataCamp, en español): curso intermedio de unas cuatro horas para diseñar, ejecutar y analizar experimentos controlados, con capítulos sobre planificación, comprobaciones de validez y toma de decisiones; la base para decidir con datos dónde colocar un componente o qué indicador mostrar.
- Creación de paneles con Dash y Plotly (DataCamp, en español): curso intermedio de unas cuatro horas para construir aplicaciones analíticas interactivas en Python, con estilos, callbacks y componentes; útil para prototipar una interfaz propia sobre una API de métricas antes de decidir si el nivel headless compensa.
Enlaces de afiliado: Dataprix puede recibir una comisión si contratas a través de ellos.
Recursos y lecturas recomendadas
- AWS, SaaS Tenant Isolation Strategies (2020): el documento que popularizó los modelos silo, puente y piscina; AWS lo conserva como referencia histórica y sus principios siguen vigentes.
- Microsoft Learn, aplicaciones multicliente escalables con Power BI Embedded: perfiles de entidad de servicio y aislamiento por áreas de trabajo o por seguridad de nivel de fila.
- Google Cloud, embebido firmado en Looker, con la recomendación de configurar un sistema cerrado para clientes que no deben conocerse entre sí.
- Tableau, control del acceso a los datos con atributos de usuario en la Embedding API v3, y la descripción de sus modelos de licencia, incluidos el uso y la capacidad.
- Metabase, introducción al embebido, y Apache Superset, SDK de embebido con tokens de invitado y reglas de seguridad por filas.
- Cube, documentación de multitenencia: contexto de seguridad, reescritura de consultas y modelos por inquilino.
- OWASP, Top 10:2025, con el control de acceso roto en primera posición.
- Kerry Rodden, Hilary Hutchinson y Xin Fu, Measuring the User Experience on a Large Scale: User-Centered Metrics for Web Applications (CHI, 2010): el artículo que presentó el marco HEART.
- Agencia Española de Protección de Datos, brechas de seguridad de datos personales: qué son y cómo actuar, con las obligaciones del responsable y del encargado del tratamiento.
Preguntas frecuentes
¿Qué es embedded analytics o analítica embebida?
Es la analítica servida dentro de otra aplicación —un producto SaaS, un portal de clientes o socios o una aplicación interna— con la identidad, los permisos y la imagen de esa aplicación, de modo que el usuario consulta los datos sin cambiar de herramienta ni de sesión. Su forma más avanzada, la analítica in-product, coloca indicadores en la pantalla donde se realiza la tarea, reacciona al contexto del usuario y conduce a una acción dentro del producto.
¿Qué diferencia hay entre incrustar un dashboard en un iframe y la analítica in-product?
Un iframe con inicio de sesión único muestra un panel completo de la herramienta de BI dentro de la aplicación, con su propia estética y sin conocer lo que hace el usuario en el resto de la pantalla. La analítica in-product usa componentes integrados mediante SDK, o una capa headless servida por API, para colocar piezas concretas en las pantallas del producto, fijar filtros según el contexto, reaccionar a los clics del usuario y aplicar el sistema de diseño de la aplicación.
¿Cómo se evita que un cliente vea los datos de otro en analítica embebida?
Determinando el cliente y el rol de cada usuario en el servidor de la aplicación, enviándolos en un token firmado de vida corta y derivando de él todos los filtros de seguridad, sin aceptar nunca el identificador de cliente desde la URL o el navegador. La seguridad por filas se define una vez en la capa semántica y se refuerza en el almacén, se revisan las vías laterales —caché, listas de valores de los filtros, exportaciones, alertas y asistentes de IA— y se prueba en cada versión con dos clientes ficticios.
¿Qué es el headless BI y cuándo conviene usarlo?
Es un enfoque que separa la lógica analítica de su presentación: una capa semántica define métricas, dimensiones y reglas de acceso y las sirve por API a cualquier interfaz, y el equipo de producto construye los gráficos con sus propios componentes. Conviene cuando la experiencia analítica diferencia al producto y existe un equipo que la mantendrá, porque obliga a desarrollar funciones que una herramienta ya incluye, como filtros, exportaciones o envíos programados.
¿Cómo se licencia la analítica embebida?
A fecha de noviembre de 2026, con cinco modelos que los fabricantes combinan: por capacidad reservada, como Power BI Embedded o los bloques de capacidad de Tableau; por uso, como la licencia de Tableau basada en impresiones analíticas; por usuario, como los embebidos con inicio de sesión de Metabase; mediante acuerdos específicos para embebido; y con código abierto, que elimina la licencia y traslada el coste a la operación. La elección debe alinear la unidad de precio con la unidad de ingresos del negocio y compararse con el coste por cliente activo.
¿Qué métricas miden la adopción de la analítica embebida?
Las de producto, organizadas en un embudo de cinco etapas: exposición, activación, hábito, profundidad y resultado. Se calculan por usuario y por cliente e incluyen, por ejemplo, la proporción de clientes nuevos que interactúan con la analítica en sus primeros días, los clientes activos por semana, la parte de las sesiones que usa filtros o exportaciones y el efecto en las consultas de soporte y en la renovación. El número de aperturas de un panel, por sí solo, no indica adopción.
Dos clientes inventados y una tarde de pruebas
Hay una comprobación que cualquier organización con un portal de clientes puede hacer esta semana, antes de cualquier rediseño. Se crean dos clientes ficticios con datos inconfundibles, se inicia sesión como el primero y se dedica una tarde a intentar ver algo del segundo: cambiar cada parámetro visible en la dirección del navegador, abrir todos los desplegables de filtro, exportar, programar un envío, repetir una petición justo después de haberla hecho como el otro cliente. Si nada aparece, el resultado se documenta y se automatiza. Si algo aparece, la organización acaba de encontrar, en una tarde y sin daño, el incidente que de otro modo habría descubierto un cliente. En ambos casos, lo encontrado esa tarde dice más sobre la madurez de la analítica embebida que cualquier hoja de ruta.
La Parte IV termina en el extremo opuesto de este mismo problema. Si este capítulo ha tratado del consumidor más alejado de la organización, el capítulo 36 se ocupa del más cercano y exigente, el comité de dirección, con un caso práctico que aplica todo lo visto en la parte —producto de datos, capa semántica, herramienta, diseño, autoservicio y gobierno de cada cifra— a la construcción de un centro de control ejecutivo.
Siguiente en la Parte IV: capítulo 36, Caso de uso: construir un centro de control ejecutivo (CEO dashboard). · Capítulo anterior: Monetización de datos y APIs · Volver a la Parte IV · Índice de la guía
Los ejemplos de este capítulo son ilustrativos y no corresponden a implantaciones concretas.
Contenido elaborado con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones. Última actualización: 17 de noviembre de 2026.
