 |
|
|
|
Monetizar datos rara vez consiste en venderlos tal cual: lo que se cobra, o se ahorra, es el producto que los rodea. El capítulo 34 de la guía de arquitectura de datos lo ordena en cuatro niveles, desde la eficiencia interna hasta el mercado, y lo baja al contrato de consumo, las cuotas, la medición y el precio, con el marco legal europeo y el caso de una comercializadora de energía. Lo acompañan el capítulo 29, donde nace el producto de datos con dueño y ciclo de vida, y el capítulo 2, con las herramientas para medir su valor; en el directorio, Snowflake y Databricks por su compartición nativa y Atlan como catálogo donde se descubre el producto.
En el sector, Google declara general el interconexionado entre nubes con AWS y Azure sin coste variable de salida, y AlloyDB empieza a consultar tablas Iceberg sin tuberías. Snowflake lleva a disponibilidad general sus agentes que investigan y reparan tuberías, Confluent añade Lightning Tables para consultar con SQL el estado vivo de Kafka, EDB compra Altinity para unir Postgres y ClickHouse, y Apache Airflow 3.4.0 trae bucles de tareas, grafos en TypeScript, Java y Go y límites de gasto para la IA.
|
Destacado
|
 |
Monetizar datos rara vez significa venderlos tal cual: lo que se cobra, o se ahorra, es el producto que los rodea. El capítulo 34 ordena la monetización en cuatro niveles —eficiencia interna, producto interno, servicio externo y mercado—, detalla el contrato de consumo de una API de datos, las cuotas y la medición, la compartición sin copias, la fijación del precio y el marco legal europeo, y lo aplica al caso ilustrativo de una comercializadora de energía. Incluye también una tabla de pasarelas, compartición nativa y medición, y un checklist para antes de abrir la primera API de datos.
Blog de Dataprix
|
|
|
Entradas de blog
|
|
Es el capítulo del que parte el de esta semana: allí el producto de datos tiene dueño, usuarios identificados, compromiso de frescura, métricas de adopción y ciclo de vida. La monetización le añade lo que le falta para salir de la organización: un cliente que firma, un precio, un soporte con horario y una factura o, en el consumo interno, un informe de coste por área.
Blog de Dataprix
|
|
|
El primer nivel de monetización, el de la eficiencia interna, no factura nada y, sin embargo, suele concentrar la mayor parte del valor. Se mide con las herramientas de este capítulo, como el ROI Canvas, y es lo que conviene tener claro antes de ponerle precio a un dato.
Blog de Dataprix
|
|
|
Software empresarial
|
 |
Plataforma de datos en la nube totalmente gestionada, que permite almacenar, procesar y analizar datos y compartirlos de forma segura. Es una de las opciones de compartición nativa que compara el capítulo: listados públicos o privados en su Marketplace, con réplica del producto a otras regiones y nubes cuya transferencia, almacenamiento y cómputo asume el proveedor.
|
|
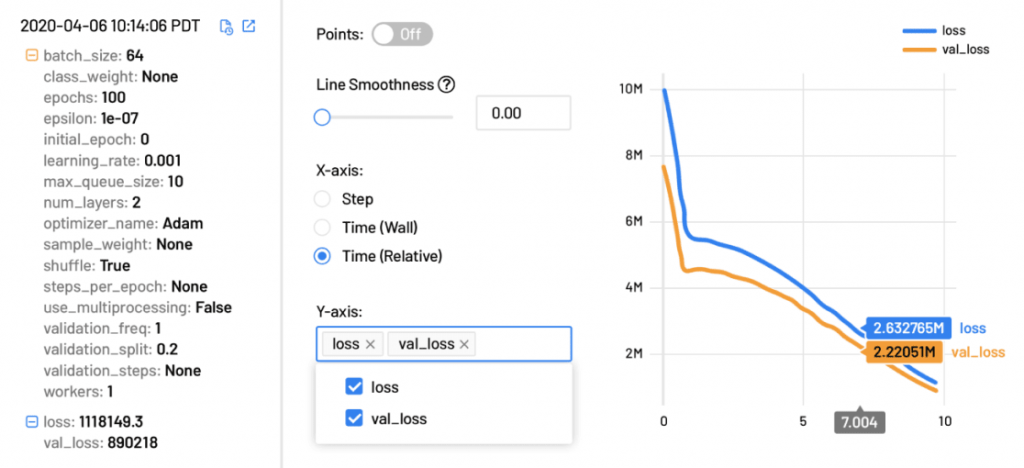 |
Plataforma en la nube para ingeniería de datos, ciencia de datos y aprendizaje automático sobre Apache Spark. El capítulo recoge su protocolo abierto de compartición, OpenSharing (antes Delta Sharing), y recuerda que compartir entre regiones o nubes puede generar costes de salida, una partida que entra en el coste de servir y, por tanto, en el precio.
|
|
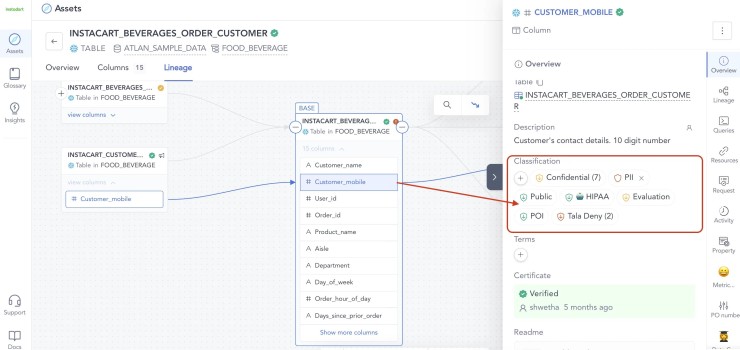 |
Catálogo y plataforma de gobierno que unifica los metadatos de bases de datos, lagos, herramientas de BI y pipelines, con glosario de negocio y linaje a nivel de columna. Es el tipo de catálogo que el capítulo propone como mercado interno de productos de datos, y pide comprobar que muestre el contrato en la ficha del producto, permita solicitar acceso con aprobación y llegue con el linaje hasta la API.
|
|
|
Noticias del sector datos
Publicado esta semana en Dataprix.net
|
 |
Las consultas a datos alojados en AWS o Azure viajan por una conexión privada, sin costes variables de salida y con los bloques recuperados en caché dentro de Google Cloud. Federa además catálogos Iceberg con Unity Catalog, Horizon y Glue; buena parte del resto de la tanda sigue en vista previa.
|
|
 |
Los agentes vigilan una tubería, investigan un fallo y proponen la reparación, que una persona revisa antes de que llegue a producción. Las cifras de ingesta son mediciones del propio fabricante, y piezas como Pipeline Builder siguen en vista previa.
|
|
 |
La operación, ya cerrada, reúne Postgres para la carga transaccional y ClickHouse para la analítica en tiempo real. El anuncio no concreta el calendario de integración, la pregunta que conviene hacer antes de contar con ello en un diseño.
|
|
 |
Una capa de consulta de solo lectura mantiene tablas al día a partir de Kafka, de modo que el estado actual del negocio se consulta por SQL o por API sin volcarlo antes a otra base de datos. La disponibilidad general es, por ahora, solo en AWS.
|
|
 |
Los bucles exigen declarar un máximo de iteraciones, y el proveedor de IA acota tokens, peticiones o gasto por ejecución y admite un estado de espera para la aprobación humana. Los grafos en otros lenguajes abren la orquestación a equipos que no son de Python, a cambio de más cadenas de construcción.
|
|
|
Recurso destacado
|
|
Antes de abrir un producto de datos a terceros conviene decidir sobre qué plataforma va a vivir. El ranking compara diez, de Oracle Autonomous Database, Amazon Aurora y Azure SQL Database a Snowflake, Databricks y Google BigQuery, con tablas comparativas y una guía para elegir la adecuada según el caso; las tres últimas son las que el capítulo cita por su compartición y mercado nativos.
Consultar el ranking →
|
|
Dataprix · C/ Font dels Arcs, 10 · La Florida, Barcelona 08130
|
|
Los contenidos de este boletín se elaboran con asistencia de inteligencia artificial — Equipo Editorial Dataprix. Verifica la información antes de tomar decisiones.
|
|
|
 Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 | Presentacion | Aviso legal | Política de privacidad